2015年のKaggle「Otto Group Product Classification Challenge」に、終了後のLate Submissionで挑戦しました。最終本命は Private logloss 0.36532 / Public 0.36273。Grok botが作ったTabPFNの基準0.37196から、0.00664改善しました。loglossは小さいほど良い指標です。
今回は、1つのAIにすべてを任せた実験ではありません。Grokの予測資産と実験記録を引き継ぎ、Gemini・ChatGPT・Claude.aiの調査をClaude Fableが統合し、Codexが追加実験を実行しました。結果だけでなく、何が効き、どのように評価し、どこで探索を止めたかを残します。
先に結果:本命は0.36532、比較候補の最小値は0.36516
| 構成 | 校正クロスフィット | Public | Private |
|---|---|---|---|
| Grok:TabPFN 3シード+温度 | 0.383717 | 0.36901 | 0.37196 |
| Kumo Large単体+温度 | 0.377344 | 0.36403 | 0.36642 |
| 最終本命:Kumo Large 1シード+TabPFN+温度 | 0.376397 | 0.36273 | 0.36532 |
| 比較候補:Kumo Large 2シード+TabPFN+温度 | 0.376217 | 0.36254 | 0.36516 |
校正クロスフィットは、保存済みのOOF予測を使い、評価対象のfoldを外して混合重みと温度を決める評価です。基礎モデルから再学習する完全な入れ子CVではありません。
比較候補のPrivateは0.36516でしたが、これを最終本命にはしませんでした。事前に決めた「クロスフィットが0.0005以上改善しなければ本命を維持する」という条件に対し、改善は約0.00018だったためです。Late SubmissionではPrivateもすぐ見えますが、その値で細かく候補を選ぶと、評価側に合わせすぎるおそれがあります。今回は事前の選択基準を優先しました。
2015年の優勝スコア0.38242、TabPFN-3.5の公開ノート0.37549、Kumoの外部報告0.36924よりも小さい値です。ただし、モデルが利用できる年代も実験条件も異なります。当時の順位表に参加した結果や、現在の世界最高記録という意味ではありません。 Kumoの0.36924も第三者の報告値で、NVIDIA公式ベンチマークとは表記しません。
Grokの基準を、3社の調査とFableの戦略で引き継ぐ
最初にGrok botが、LightGBMなどの古典手法、ニューラルネット、埋め込み特徴量、スタックを探索しました。初提出のPrivateは0.44386。複数のモデルを重ねる工夫を経て、TabPFN 3シードの幾何平均と温度補正で0.37196まで進みました。
これを超えるため、Claudeに共通の調査プロンプトを作らせ、Gemini・ChatGPT・Claude.aiのDeep Research系へ同じ条件で依頼しました。3本のレポートがそろったところで、Claude Fable 5.2が統合戦略を作成。試すモデルの順番、Privateを見ずに選ぶ方針、打ち止め条件をまとめました。Codexが実行し、途中の実測結果をFableへ相談するやり取りは、私が仲介しました。
ちょうどFable 5.2の特典期間に重なったことも、今回の進め方の背景です。対象Proプラン向けの特典期間は2026年11月9日〜16日(米国太平洋時間)、終了は日本時間11月17日16:59。週間上限などの条件があり、常時同じ条件で使えるサービスとしての費用比較ではありません。詳しくはClaude公式の案内を参照してください。
Otto 2015は、商品の画像ではなく93列の表を分類するコンペ
正式名はOtto Group Product Classification Challenge。1行が1商品で、匿名の93特徴から、9クラスそれぞれに属する確率を予測します。学習データは61,878行、testは144,368行です。特徴は非負の整数で、元の意味は公開されていません。
評価は多クラスlogloss。正解クラスへ割り当てた確率をpとすると、その商品の損失は−log(p)です。正解に0.9を出せば約0.105、0.5なら約0.693、0.01しか出さなければ約4.605。正解・不正解だけでなく、確率の自信度が適切かも重要になります。
簡単にデータを見ると、欠損はなく、学習側のセルの約79.34%が0でした。1商品で非ゼロになる特徴の数は中央値18/93。多くの列が0で、一部のカウントが大きくなるデータです。ここで0を欠損値とみなして補完することはしません。
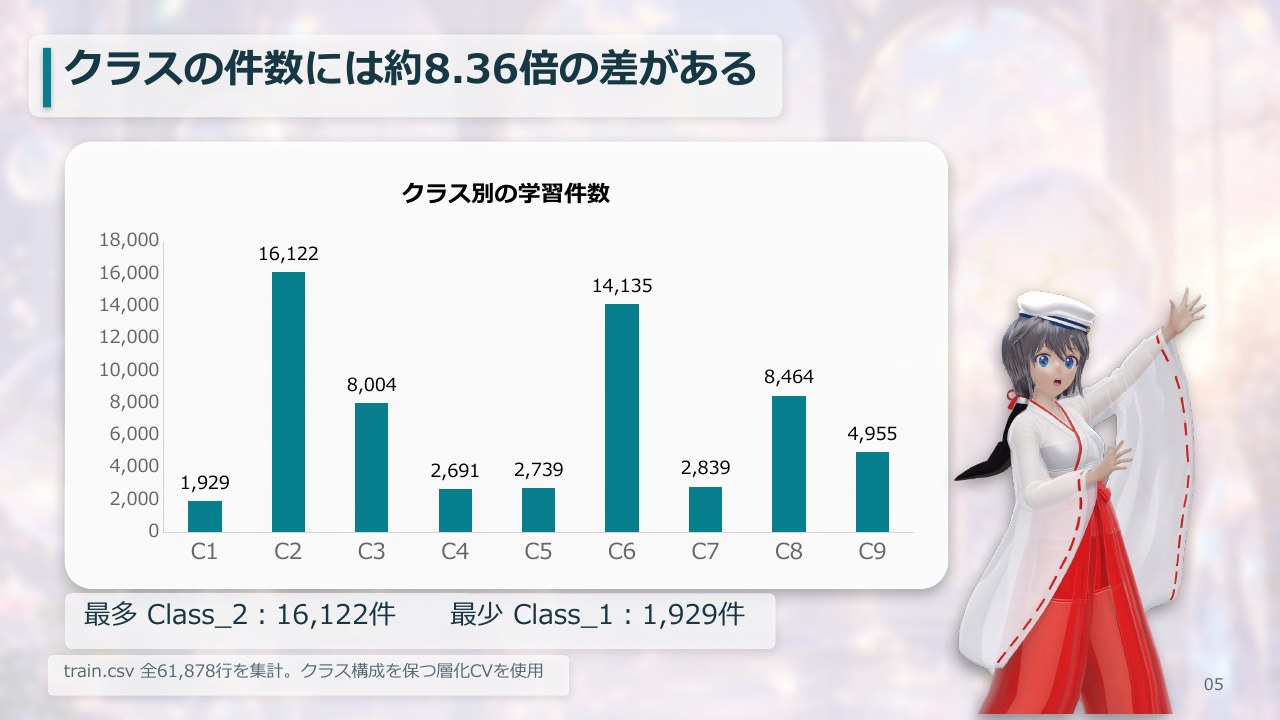
クラス件数にも差があります。最多のClass_2は16,122件、最少のClass_1は1,929件で約8.36倍。検証では、クラスの構成比を保つ固定foldを使いました。
なぜ、t-SNE・UMAPの座標を特徴量に加えると効くのか
Grok側では、93列をt-SNEやUMAPで少数の座標へ変換し、それをLightGBMへ追加しました。下図ではClass 5・6が比較的分かれ、Class 2・3・4は同じ領域に混ざっています。これは目視による観察で、クラス分離を検定したものではありません。図は実際に使った3次元座標の先頭2軸です。
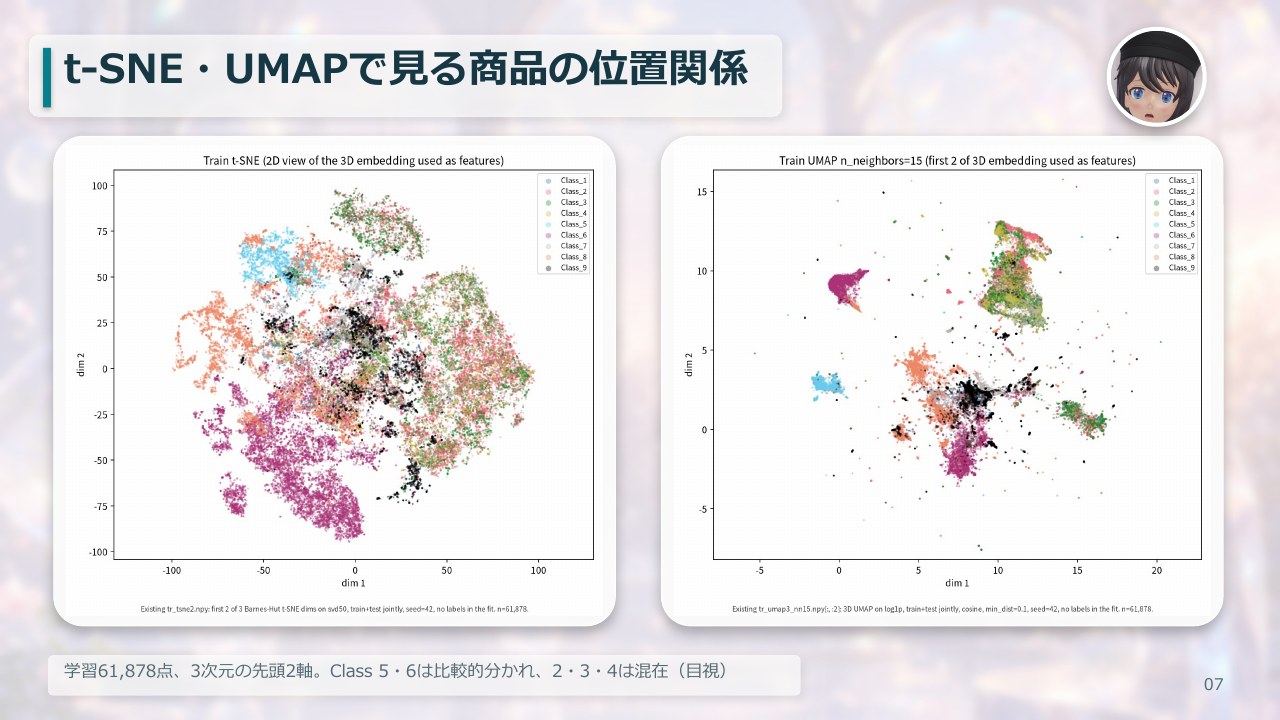
効く理由として考えられるのは、「複数の列を合わせたときに似ている商品」の関係を、木が使いやすい座標へまとめて渡せることです。木モデルは基本的に1列ずつしきい値で分割します。93列の組合せにある複雑な近さを元の軸だけで表すには、多くの分岐が必要になる場合があります。埋め込み座標が、その近傍構造の手掛かりになります。
新しい正解情報を作り出しているわけではありません。同じ特徴の関係を別の形で表現し、限られた木の深さや本数で使いやすくする、という仮説です。低次元の見た目だけで、効いた理由を証明することもできません。
もともとは厳密な追加前後比較がなかったため、後から同じ5-fold・LightGBM設定で追加実験を行いました。Kaggleへの提出はしていません。
| 入力 | OOF logloss | 対応する土台からの変化 |
|---|---|---|
| 土台A:log1p+統計量+SVD50(154列) | 0.469951 | — |
| 土台A+t-SNE 3次元 | 0.465469 | −0.004481 |
| 土台A+UMAP 2種 | 0.456226 | −0.013725 |
| 土台A+t-SNE+UMAP | 0.454203 | −0.015748程度 |
| 元の93特徴 | 0.453295 | — |
| 元の93特徴+UMAP 2種 | 0.438755 | −0.014541 |
この設定では、元の93特徴のほうが土台Aより強かったのが意外でした。それでも、その強い土台へUMAPを加えて約0.0145改善しています。各比較とも5つのfoldすべてで改善しました。したがって、この固定した実験条件では、弱い土台だけを比較したために効いて見えた、という説明ではありません。
ただし座標は、ラベルを使わずにtrainとtestを合わせた206,246行でfitしています。ラベルを直接入力してはいませんが、testの特徴分布は利用するtransductiveな条件です。foldごとに学習側だけで埋め込みをfitする厳密なinductive評価とは異なります。t-SNEはSVD50、UMAPはlog1pを入力としており、両手法の優劣だけを取り出した比較でもありません。
最終のTabPFN・Kumoブレンドは元の93特徴を使っており、この埋め込みは入りません。 ここは、Grokによる探索と後日の説明用検証の成果です。
TabPFNとKumoは、表の読み方を事前に学んだモデル
普通のモデルでは、手元の表で学習してから予測します。TabPFNやKumo-Tabularは、開発元で多くの予測課題を経験させておいたモデルです。新しい表では、正解付きの行を「この表ではこう対応している」という見本として参照し、未知の行の確率を出します。この使い方をin-context learning(文脈内学習)と呼びます。
今回はOtto用に基礎モデルの重みを追加学習していません。ただし、後から予測を混ぜる重みと、確率を校正する温度はOOFで調整しました。「モデルの重みを固定すること」と「後処理も一切調整しないこと」は別です。TabPFN-3.5の公式モデルカードにも、この文脈内予測の説明があります。
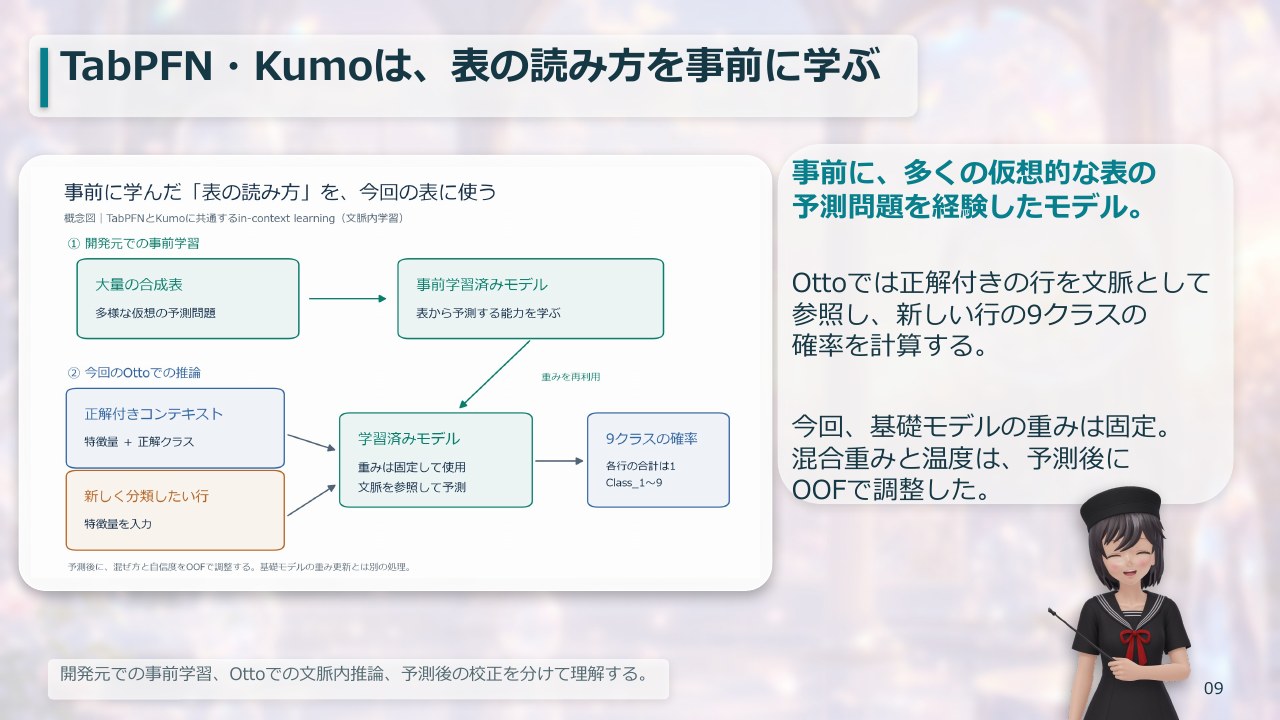
TabPFNは、今回の強い出発点を作りました。Grokが作成したseed 0・1・2の予測を幾何平均し、温度を補正したものがPrivate 0.37196です。Codexは、この予測と固定foldを引き継ぎました。
Kumo-Tabularは、セルの値をモデル内部の表現へ変え、列方向・行方向の関係を読み、正解付きの行を参照してクラス確率を出すTransformerです。初心者向けには「1マスの値から、列と行、最後に表全体の見本へ」と情報を組み立てるモデル、と捉えると入りやすいと思います。詳細はNVIDIA NIM APIリファレンスにあります。
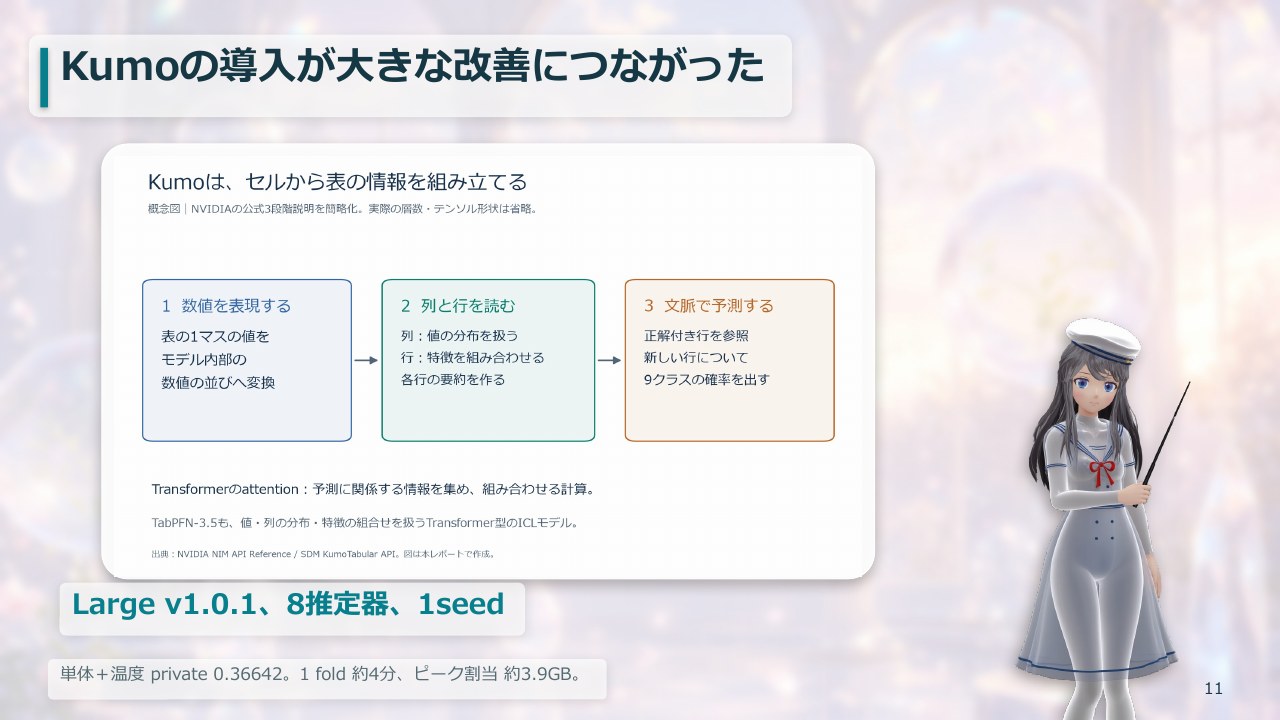
使ったのはKumo Large v1.0.1、8推定器、seed 0。手元のRTX 3060 12GBで、1foldは約4分、ピーク割当は約3.9GBでした。全行を参照するtest予測は約14分・約4.7GB。想定より軽く、まずKumo単体+温度だけでPrivate 0.36642へ進みました。
温度で「自信の出し方」を整え、異なる予測を混ぜる
最終本命では、KumoとTabPFNの対数確率を重み付きで混ぜました。Kumoの重みは約0.714、TabPFNは約0.286です。単体で強いKumoを主役にしつつ、TabPFNの異なる予測を残しています。この比率は予測を混ぜる係数で、AIごとの貢献率ではありません。
温度Tは、自信を調整するつまみです。T=1なら元の確率、T<1なら大きな確率をより強調し、T>1なら確率の差をなだらかにします。たとえば0.7・0.2・0.1は、T=0.8なら約0.771・0.161・0.068、T=1.2なら約0.645・0.227・0.128です。
全クラスに共通する正の温度なら、最大確率のクラスは変わりません。それでも、正解へ出した確率が変わるのでloglossは変わります。今回のTは約0.9475で、少し鋭くする方向でした。
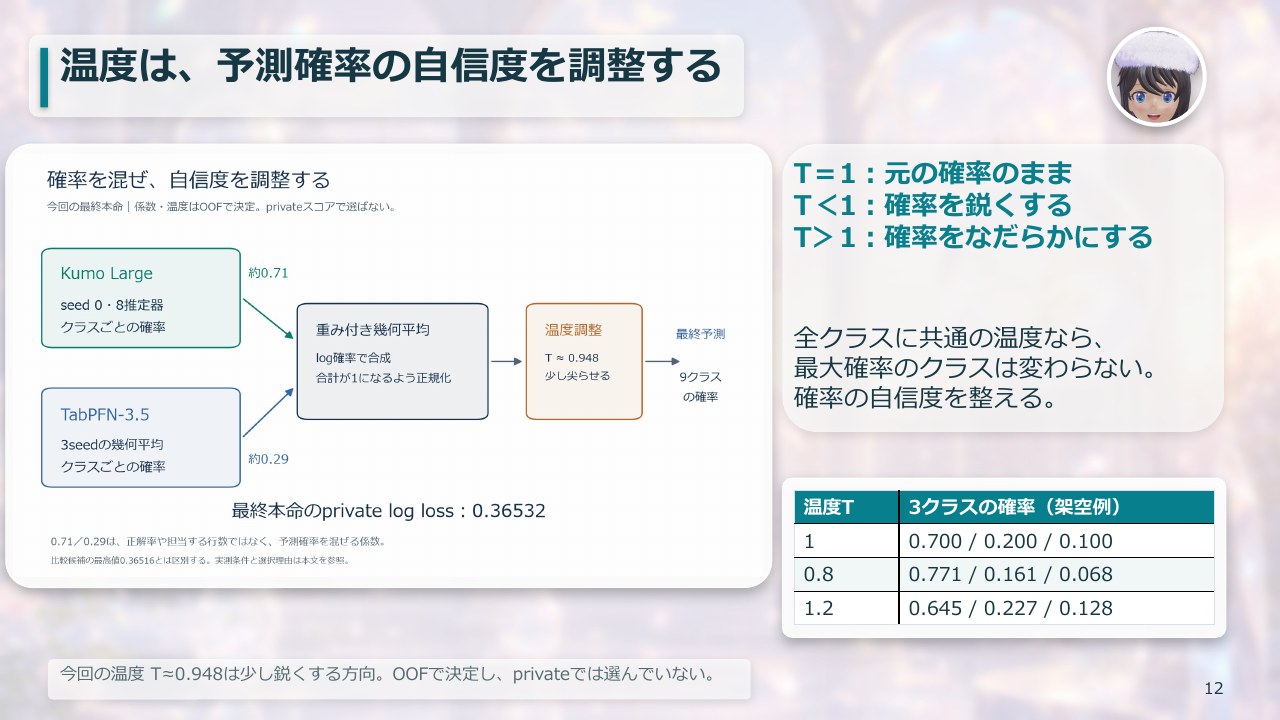
混合と温度の式は softmax((wK × log pK + wT × log pT) / T)。重み・温度はOOFで決め、Privateで調整していません。予測を混ぜる意味があったかは、Kumo単体の0.36642からブレンドの0.36532への改善にも表れました。
検証の分離と、効かなかった追加案
OOFは、各行を参照例に含めずに作る予測です。Kumoのfold 0〜2では、49,502行を文脈として12,376行を検証。fold 3〜4では49,503行と12,375行です。両者の重複は0でした。test予測では、学習61,878行すべてを参照します。
混合重みと温度も、評価するfold以外のOOFから決めるクロスフィットで確認しました。ただし、同じ固定OOFを使って複数の案を比べています。完全に未使用の独立評価を何度も用意したわけではなく、基礎モデルまで再学習する入れ子CVでもありません。
Kumoのコンテキスト量、追加seed、Mediumの追加、log1p入力、16/32推定器も調べました。2シード化には小さな改善がありましたが、事前の採用閾値には届きませんでした。Mediumやlog1p、推定器増も、この一巡では採用するほどの改善を示しませんでした。すべてを十分に調整した一般的な優劣比較ではありません。
Kumoの事前学習データについては、NVIDIAのNIM APIリファレンスに合成データのみと記載されています。これはメーカー公表情報の確認です。一方、今回のOOFに検証行が入っていないことは、コード・行番号・fold記録を照合した別の確認です。両者を合わせて、未知の漏れまで完全に存在しないと証明した、とは扱いません。
スコアの推移と、時間の読み方
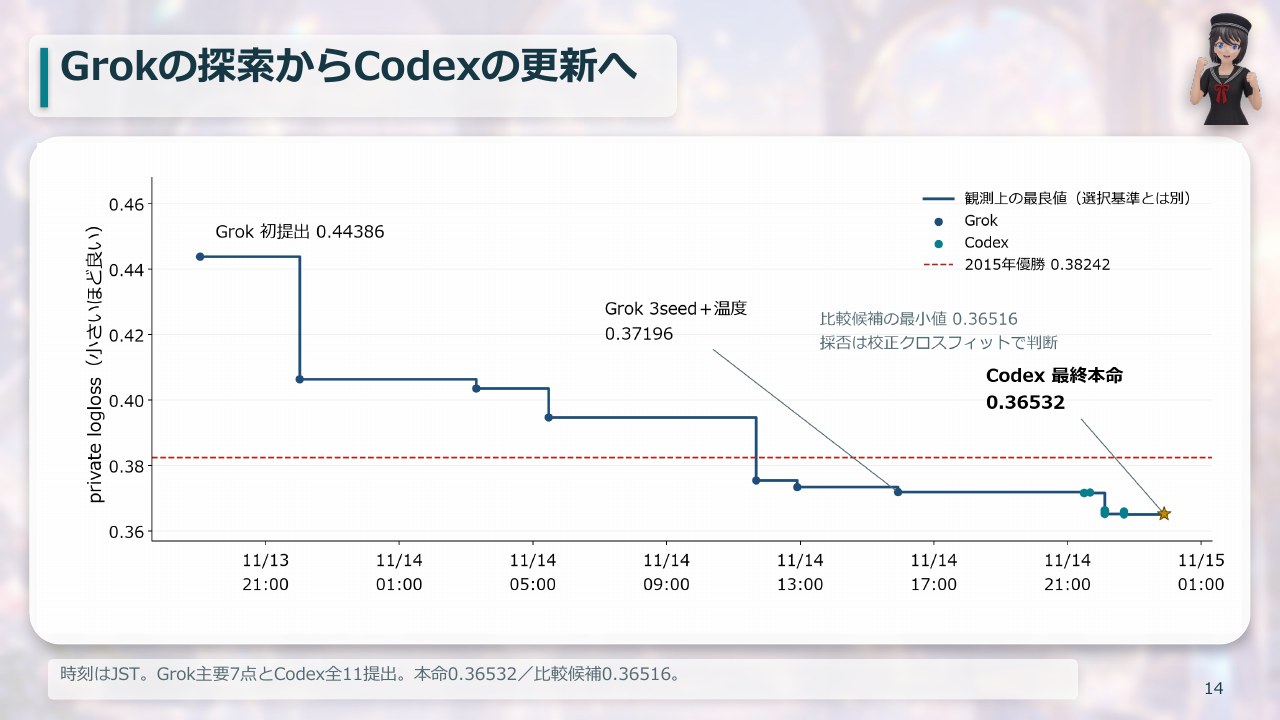
Grok側の探索で、古典手法とスタックからTabPFNへ進んだときに大きく改善しました。Codex側ではKumoの追加が決め手になりました。グラフの線は観測上の最良値を示していますが、本命選択はPrivateの最小値とは分けています。
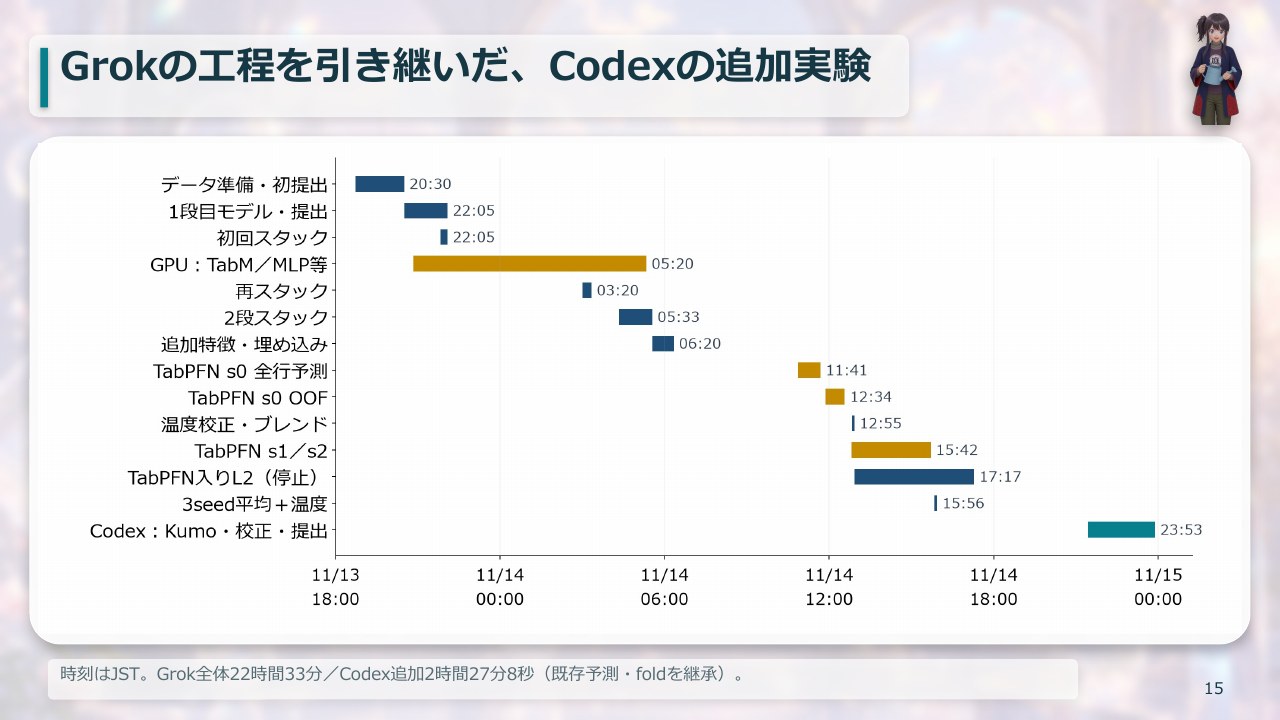
| 担当・区間 | 実測時間 | 含むもの |
|---|---|---|
| Grokの全体作業 | 22時間33分 | 環境構築、古典手法、埋め込み、TabPFN 3シード予測の作り直し、スタック、レポート |
| Codexの追加実験 | 2時間27分8秒 | 既存のTabPFN予測とfoldを継承し、最初のGPU試験から最終提出まで |
GrokのTabPFN 3シード予測の作り直しだけでも、約3.8〜4.4時間が含まれます。Codexの区間には、その予測の生成時間、最初の試験以前の環境構築、後日の資料作成は含めていません。以前書いたGrokの「約19時間」は概数で、ここでは実測22時間33分へ訂正しています。この時間差を、そのままAIの速度倍率とは比較できません。
追加の有料GPUは使わず、手元のRTX 3060で実行しました。AIサービスの契約は別です。今回のCodex側の提出は11件でした。
振り返り:それぞれの貢献をどう見るか
結果から振り返ると、Grokは強い基準と再利用可能な資産を作り、Claude Fableは限られた実験をどの順番で進め、何をもって採用・停止するかを決め、Codexはその戦略を実装して検証可能な結果へつなげました。Gemini・ChatGPT・Claude.aiの調査は、候補と論点を広げる役割でした。
| 担当 | 今回の主な貢献 |
|---|---|
| Grok bot | 古典手法からTabPFNへ進めた基準、3シード予測、固定fold、実験記録、後日の埋め込み比較。スライドのデザインも担当 |
| Claude Fable 5.2 | 3社の調査の統合、Kumoを優先する戦略、実測後の相談、Privateを選択に使わない評価・停止条件 |
| Codex | 環境準備、Kumo実行、校正・ブレンド、採用判断の記録、再現確認、レポートと公開資料の整理 |
| GeminiなどのDeep Research | 解法候補と検証上の論点を調査し、統合戦略の材料を提供 |
| 私 | 目標と制約の指定、AI間の仲介、素材と記録の提供、発表資料の確認 |
独立したAI比較実験ではないため、各AIの寄与をパーセントにはできません。特にGeminiの提案だけが最終スコアを何点改善したかは切り出せません。また、この結果を直接支えたのはTabPFNとKumoの開発者が作った学習済みモデルです。AIエージェントの工夫と、基盤モデルそのものの進歩は分けて考えたいところです。
資料作りではCopilotによる清書も試しましたが、配置が崩れて採用には至りませんでした。Grokが作ったスライドを土台に、Codexでチャートの見やすさや説明を調整したものを、以下に置いています。
スライドと再現用ファイル
図の細部を拡大する場合は、高画質PDF(約5.7 MB)も利用できます。
再現ZIPには、提出CSV2本、保存済みの予測、CPUでのCSV再生成・校正再計算コード、元の推論コード、評価記録をまとめました。Kaggleの生のtrain/test、モデル重み、APIキーは含めていません。
ZIPを展開し、Python 3.11環境で次を実行します。
|
1 2 |
python -m pip install -r requirements-cpu.txt python src/reproduce.py --verify-files |
保存済みの最終予測から、実際に提出したCSVを再生成し、SHA256の一致を確認します。基礎モデルからの再推論ではありません。校正クロスフィットも再計算する場合は、公式の train.csv を別途取得し、--refit --train-csv C:/path/to/train.csv を追加してください。
元の推論コードも参考として同梱していますが、一部は当時のローカル環境に依存します。基礎モデルからやり直すにはデータ・公開重み・GPU環境が別途必要で、GPU推論のバイト単位の一致は保証しません。Privateの再採点にはKaggleへの提出が必要です。
参考資料
- Kaggle Otto Group Product Classification Challenge
- TabPFN-3.5: Rank 1 in 1 Line of Code
- TabPFN-3.5 公式モデルカード
- NVIDIA Kumo-Tabular:NIM APIリファレンス
- Kumo外部報告の参照先(統合戦略で参照した第三者報告)
- 2015年1位の解法
- Claude Fable 5.2の特典案内
本記事の実験値・図は、ローカルの提出記録、固定foldの評価記録、Grokによる追加比較、発表資料v7をもとに整理しました。