- 1. この記事の要点
- 2. どんな共通プロンプトで、この結果につながったか
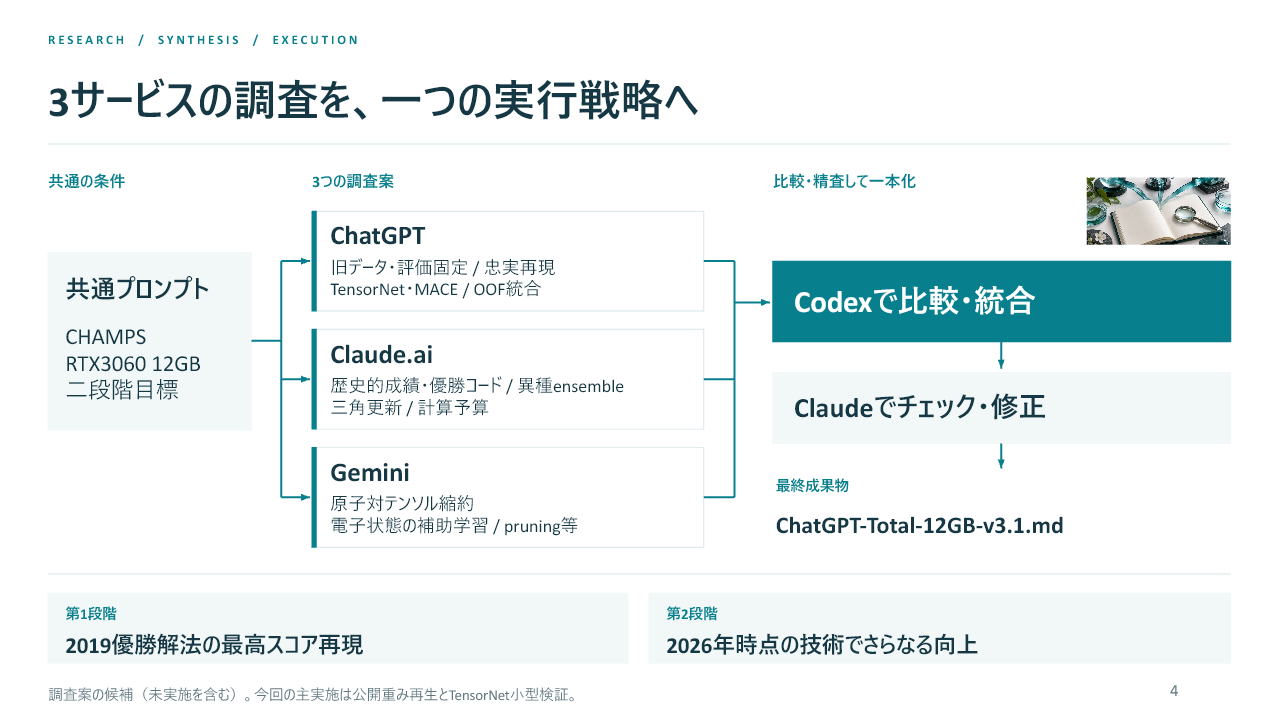
- 3. 3サービスの調査と統合の中身
- 4. A〜Mの13モデルと、自前学習の位置づけ
- 5. 制作環境とブラウザ連携を選んだ理由
- 6. 5時間枠を研究と資料制作に配分する
- 7. 再起動・利用枠切れに備える
- 8. 金曜夜からの全体工程と計算時間(発表資料PDFのp.10)
- 9. コンペとデータを理解する
- 10. EDAと構造の6クラスタ候補
- 10.1. 構造特徴の作り方
- 10.2. 8タイプの件数
- 10.3. trainとtestの構成
- 10.4. タイプ別の目的変数
- 10.5. 中央値とばらつき
- 10.6. 分子の大きさと行のまとまり
- 10.7. どんな元素を扱うか
- 10.8. 原子間距離だけで説明できるか
- 10.9. 距離分布を見る
- 10.10. 特徴同士の相関
- 10.11. 分子単位の5分割
- 10.12. Jの全体分布:大きな山と小さな山
- 10.13. 山の由来を結合タイプ別に確認
- 10.14. J分布の通常表示・対数表示・谷分割を並べて見る
- 10.15. 対数ヒストグラムの谷から6つの値域を考える
- 10.16. なぜ分子構造のクラスタ数も6を候補にするか
- 10.17. 6クラスタの構造プロフィール
- 10.18. 6クラスタの意味づけ仮説
- 10.19. 中心に近い代表分子で仮説を確認
- 10.20. t-SNE・UMAPで6クラスタの分布を見る
- 10.21. t-SNE:1群ずつ強調して位置を確認
- 10.22. UMAP:1群ずつ強調して位置を確認
- 10.23. 同じ地図をJの分位点で色分けする
- 10.24. t-SNE:タイプ別のJとの関係
- 10.25. UMAP:タイプ別のJとの関係
- 10.26. クラスタごとのタイプ内Jの偏り
- 10.27. 今後の予測へつなげる仮説
- 11. 分子モデルの推論アルゴリズム
- 12. 公開重みは、誰がどこで何のために公開したのか
- 13. 解法と実験結果
- 14. 未達の理由:事実と仮説を分ける(発表資料PDFのp.23)
- 15. 補足:改善仮説をどう検証したか
- 16. 結果を読むための用語
- 17. 入門サンプルを実行する
- 18. Summary:成果・得られた知見・残る課題
- 19. 配布ZIPの使い方:提出用CSVとプログラム
この記事の要点
CHAMPSは、分子の3次元構造から指定原子対の結合定数Jを予測するコンペです。今回はCore i7-11700K・128GB RAMとRTX3060 12GB 1台で、公開13モデルの推論と公式集約を再生し、Private −3.22754に到達しました。歴史首位−3.23968との差は0.01214。順位や入賞を取得した意味ではなく、歴史Privateスコアとの比較です。
スコアは、8つの結合タイプそれぞれのMAE(平均絶対誤差)の自然対数を平均した値で、低いほど良い指標です。−3.2なら、タイプ別MAEの幾何平均が約0.04 Hzに当たります。全行をまとめたMAEではありません。Privateは、最終評価用の非公開データ側のスコアです。
主成果は、事前の3サービス調査を統合して選んだ「公開資産を忠実に再現する」戦略が、この環境で機能したことです。第2段階の現代モデルは方向・幅・最適化で改善しましたが、今回の上積みとして採用するには至りませんでした。調査案の一致を独立実験の証拠とはせず、実測で確かめた範囲を説明します。
まず戦略と進め方、次にEDAと第1段階の解法、最後に第2段階で分かったこと・未解決課題を紹介します。
どんな共通プロンプトで、この結果につながったか
以下は説明用の要約で、原文の逐語引用ではありません。
CHAMPSを調査し、①2019年優勝級の解法を再現、②新技術で上積みを狙う。モデル紹介だけでなく、公開コード・評価方法・計算資源・実装手順まで示す。歴史的実績と未検証案、実測値と推定値を区別し、不明な情報は創作しない。
旧データ統一、分子単位CV、test正解・代理ラベルの利用禁止、上位解法とコード、主戦略/代替案、計算資源、失敗時のリスク、優先順位を要求しました。2019-A/B/Cと2026-A/B/C、実装ロードマップや一次情報の確認まで含まれます。RTX3060は原文の環境候補、VRAM12GBは統合版で確定しています。
戦略作成から実行までの工程:
- ChatGPTで共通プロンプト案を作成し、Claudeでチェック。
- ChatGPT、Claude.ai、GeminiのDeep Research系で共通課題を調査(各モードの差は後述)。
- 3案をCodexで比較・統合し、実行戦略を作成。
- Claudeでチェック・修正。
- ローカル実行に加え、事前許可した範囲でKaggle提出・採点取得まで行えるCodexを実行担当として採用。
各サービスの調査モードは完全同一とは限らず、Claude原稿には専用Advanced Research不使用の自己記録があります。3件の独立実験や同一モード比較ではありません。
共通調査プロンプト全文は、配布ZIP内のprompts/common-prompt-body.mdに収録しています。末尾のダウンロード欄から取得できます(ZIPは約146MB)。原文は調査前の依頼条件や仮説を含み、全候補の成功を示すものではありません。
プロンプトを送るだけで結果が出たわけではありません。その後に依存解決、コード移植、旧データ整合、重み互換、推論・集約の検算、提出を実施しました。投稿は許可した固定候補を検査・hash凍結し、重複送信を防いだ上で自動実行しています。
3サービスの調査と統合の中身
3案の比較・統合はCodexで行い、Claudeでチェックしました。統合版の保存名はChatGPT-Total-12GB-v3.1.mdです。以下に、各案から統合した主な提案をまとめます。
| 調査元 | 統合した提案 |
|---|---|
| Claude.ai | 2019年のPrivate成績と優勝コード、異種ensemble、三角更新、計算予算 |
| ChatGPT | 旧データ・評価の固定、Bosch優勝モデルの忠実再現、MACE/TorchMD系、OOFによる統合 |
| Gemini | 原子対のテンソル縮約、電子状態を使う補助学習、pruning等の研究候補 |
統合時には、未実測の「必ず高速」「必ず記録更新」を取り除き、一因子ずつ手元で検証する計画にしました。調査案の評価点はその原稿への主観的評価であり、AIサービス一般の能力順位としては用いません。
第1段階:公開優勝モデルで最高スコアの再現を目指す
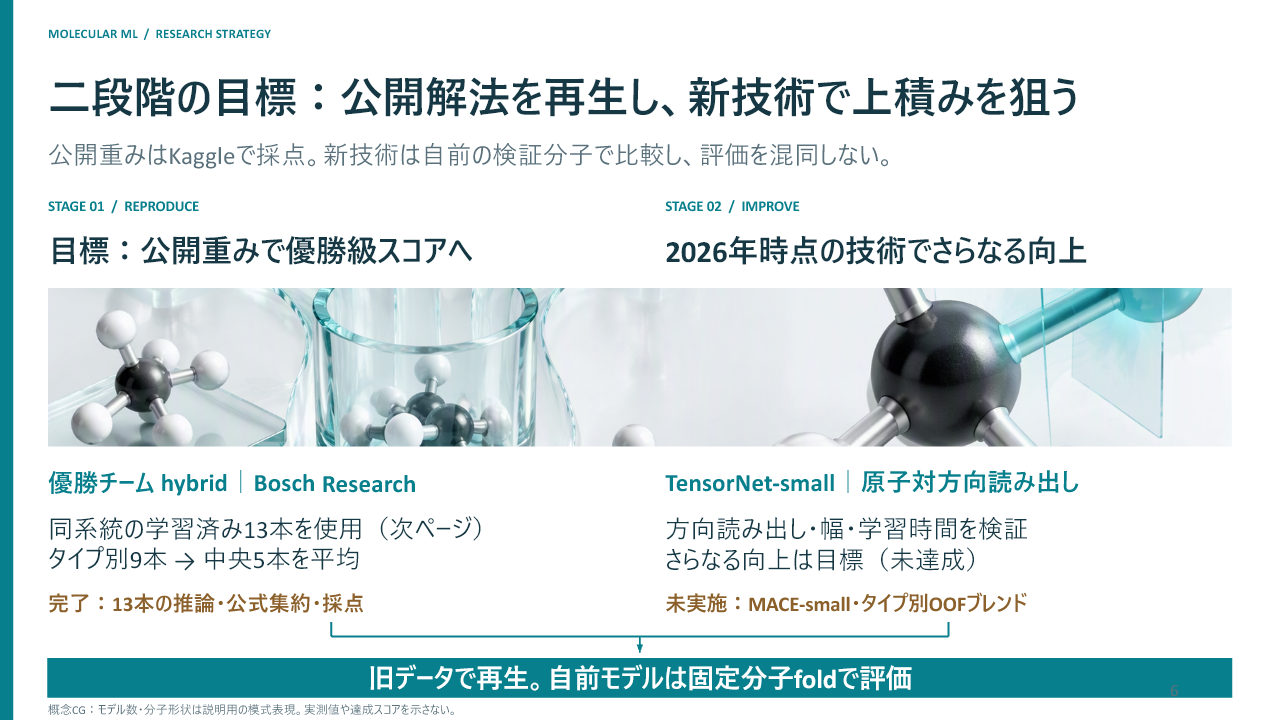
参照軸は、2019年の首位チームhybridのBosch公式実装BCAI_kaggle_CHAMPSです。原子・原子対・三つ組を注意機構で組み合わせ、距離、角度、結合情報、部分電荷などを利用します。単体モデルだけでなく、複数の保存重みと原本のタイプ別選択、中央5予測平均という集約まで含めて再現する方針でした。
今回の「公開モデルA」は、公式配布のmodel_A.ckptです。A〜Mの13本に含まれる1本で、これだけで優勝ensemble全体を表すわけではありません。公式コードは、今回の再現で使用した版を固定しています。版の識別情報は配布ZIPに記録しています。A単体に続き、全13本の全件推論・公式集約・独立再検算・Kaggle採点を完了しました。13本集約はPublic −3.23528、Private −3.22754です。公開重みの推論再生であり、全再学習の再現とは分けて示します。
自前2019系の実験では、公開Aと同じ構造(幅650・10層)を使い、学習条件は一部変更して、公開重みを読み込まず一から固定分子foldで学習しました。公開重みの参照採点と、自前の検証予測は別物です。また、統合戦略の「2019-A」は忠実再現という方針名で、配布ファイルの「モデルA」とは別の名前です。
その先の拡張として、座標TransformerやSchNet等、2019年の異なる解法を自前OOFで組み合わせる案もありました。今回は未実施です。
第2段階:2026年時点の技術で、さらに高いスコアを目指す
最優先候補はTensorNet-small、次がMACE-smallでした。分子全体のエネルギーを出すheadをそのまま使うのではなく、対象2原子の表現、距離、type、方向情報を取り出し、回転・並進・端点交換に対して整合するスカラーJを出すheadへ適応する計画です。
TensorNetでは方向を保つテンソル表現を原子対方向へ縮約する読み出しを実装しました。MACEでは多体の幾何表現を使う想定でしたが、今回は未実装です。第三原子の距離・角度を使うpair/triangle枝は試して不採用。FC/SD/PSO/DSOの4寄与の補助予測と和の整合性、2019系へのAMP・EMA/SWA等の近代化も候補として残り、今回の実施成果には含めません。
最終戦略は、2019系と有効な新モデルの予測を、自前OOFでタイプ別に非負・和1の重みで統合することでした。単体のスコアが弱くても、独立評価で補完効果があれば採用する考え方です。この最終OOFブレンドも未実施です。公開学習済み重みを自前OOFへ混ぜず、KaggleのPrivate値を見て重みを調整しません。
第1段階の完全再現を待つと新モデルの計算時間が分からないため、公開モデルAの参照点を確保した後、第2段階の小型実測を先行しました。「2026年技術での向上」は目標であって達成宣言ではなく、今回のTensorNetが最新技術全体を代表するわけでもありません。
A〜Mの13モデルと、自前学習の位置づけ
A〜MはBoschが公開したGraph Transformer系13本の識別名です。13種類の別アルゴリズムや13foldではありません。幅/層数はA・B・C=650/10、D=800/11、E=600/10、F=800/10、G=600/11、H=700/15、I=700/16、J=650/13、K=600/14、L=750/18(四つ組も使用)、M=660/11です。出力部やモデル固有コードにも差があります。A/B/Cは同じ主要configですが、別の学習済み重みです。seedや細かな学習履歴の差は設定だけから断定しません。13本の予測からタイプ別9本を選び、各原子対で中央5本を平均します。
公開モデルAは、この13本のうちのAです。「自前2019系」は同じAの設計(幅650・10層)を使い、公開checkpointを読み込まず、未学習の重みから自分で学習したものです。公開Aを上書き・破壊・初期化したという意味ではありません。学習分子だけで語彙・正規化をfitし、固定fold0で検証しました。分割・BF16等の条件も元解法とは違うので、勝者の完全再学習とは呼びません。
これは第1段階に関連する検証実験であり、第2段階の現代モデルとの比較基準を得る目的です。公開13本は元train全体で学習済みなので、train内の検証分子に対する予測をそのままOOF対照にはできません。公平な比較には別の対照学習が必要でしたが、公開重みのKaggleスコアを再生するだけなら不要です。
自前2019系19時間21分と現代モデル20時間05分、計約39時間26分は、記録済み主要計算45時間19分の約87%です。これらの重みは最終提出に直接使っていません。約70時間の経過や、人の作業の87%という意味ではなく、CPU工程等を除いた計算記録内の割合です。
公開資産を採用した再現戦略は成功しました。一方、スコア到達効率という軸では、追加探索への時間配分に反省があります。実行では自前学習や現代モデルの時間見積りを先行し、公開13本の採点は10/26午後になりました。スコア到達を優先するなら公開13本再生を先に完了し、追加研究の予算と打切り条件を早期に固定する方が適切でした。失敗実験にも比較・改善の知見はありますが、それを最終スコア向上の成果と混同しません。戦略全体の最適性を証明した事例でもありません。
制作環境とブラウザ連携を選んだ理由
本制作では、Codexでモデル6.1-Sol、M365 CopilotではPremium契約でモデル6.1-Solを使用しました。Codexの推論設定は資料の定型作業で「軽」、研究上の重要な判断で「中」を使い分ける方針としました。サービス間で同名のモデルを選んでも、利用枠・実行機能・課金体系が同一であるとは限りません。
今回確認したMicrosoft 365 Copilot Chat API(プレビュー)はテキスト中心で、画像生成・ファイル作成には対応していません。そのため、概念イラストとPPTXの制作には、Codexが内蔵ブラウザからCopilotの画面を操作する連携を選びました。これはCopilot全体や、MicrosoftのすべてのAPIに対する制限を意味するものではありません。仕様は2026年10月26日時点の確認です。
Codexは構成・数値・根拠・制作指示を管理し、ブラウザ経由で素材添付と修正指示を行いました。Copilotは共通デザインと写真画質の概念イラストを担当し、Codexが実データの図表配置・統合・編集を担当する分担です。サインインとデザインの採用判断は人間が行いました。ブラウザ操作の分だけCodexの利用量も増えるため、操作をまとめ、研究の判断・復旧用の枠を残しました。API方式との消費量比較は実測していません。
出典:Microsoft 365 Copilot Chat API overview
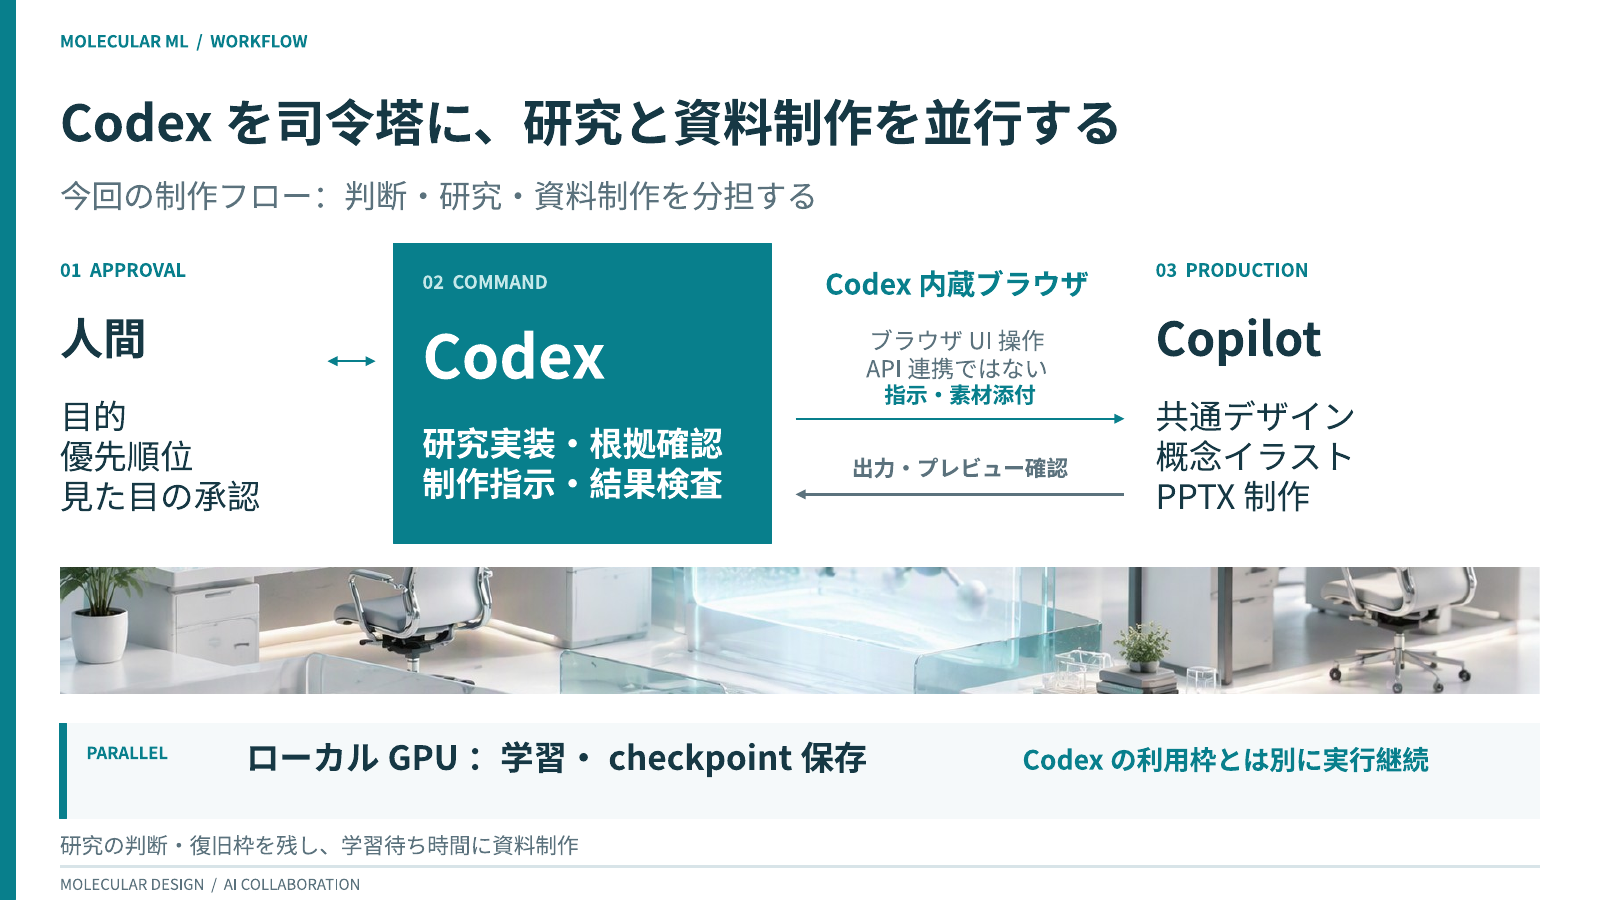
Copilotで作成した図版です。写真画質の挿絵は概念CGで、実際の作業室の写真ではありません。PPTXでは文字と矢印を編集可能なまま統合しました。
5時間枠を研究と資料制作に配分する
今回のCodex利用環境では、利用量を5時間の枠と週単位の枠で確認しました。ここでは前者を「5時間枠」と呼びます。残量・回復時刻は画面の表示に従いました。外出中はスマホから進捗確認と指示を行い、完了通知を受けました。
ローカルGPUの学習を独立プロセスで走らせ、その計算中に説明・EDA・資料を作りました。5時間枠の残り40%で資料作成の警告、30%以下で非緊急制作を止め、15%以下は研究の必須対応に限定します。自然回復を確認してから資料作業を再開します。これらは今回の運用目安で、製品公式の推奨閾値や厳密なtoken予約ではありません。
週枠も確認し、発表までの必要作業を優先しました。制作を小分けし、操作・ログ確認をまとめることで、人間の作業と利用枠の両方を管理します。普遍的な節約率は測定していません。Codexが最終返信を返すと能動的な操作はいったん終わります。ローカル学習や送信済みのCopilot生成が継続することとは別です。
再起動・利用枠切れに備える
コード、凍結config、データ/foldのhash、親checkpoint、optimizerと乱数状態、節目の予測、所要時間を保存しました。Claude Codeへ引き継げる記録も残しています。再起動後は実プロセスと保存済みcheckpointを確認して二重起動を避け、最後に保存したepochから再開します。Windows起動時の無人自動復旧を構築済みという意味ではありません。
金曜夜からの全体工程と計算時間(発表資料PDFのp.10)
記録上の開始は2026年10月23日(金)22:41:53の共通プロンプト保存、統合戦略v3.1は24日(土)02:15:08の保存です。ファイル時刻に基づく経過は3時間33分15秒。DeepResearch比較・統合の全実働時間を直接計測した値ではありません。
| 記録上の節目(JST) | 共通プロンプト保存からの経過 |
|---|---|
| 10/24 02:15 統合戦略v3.1 | 約3時間33分 |
| 10/26 15:56 公開13本の採点完了 | 約65時間14分 |
| 10/26 20:30 TensorNet LR比較・両fold完了 | 約69時間49分 |
この約70時間には戦略、環境準備、EDA、学習、推論、エラー診断・復旧、資料制作が入り、睡眠・外出・待ち時間も含まれます。人が操作していた時間は未計測です。この表は研究結果がそろった時点までの経過で、最終資料・ブログの仕上げ時間は含めていません。
| 主要ジョブの記録分 | 時間 | 集計対象 |
|---|---|---|
| 自前2019系 | 19時間21分 | 初期10+延長10+LR3epoch×2条件、完了sessionを重複排除 |
| 現代モデルの探索全体 | 20時間05分 | 初期20epoch×7条件、延長80×2、LR追加20×4 |
| 公開13本の全件推論 | 5時間53分17秒 | モデル別の推論session合計 |
| 計 | 約45時間19分 | 未計測の工程を除く下限 |
5時間53分はプロジェクト全体の所要時間ではありません。 公開13本推論だけの記録です。45時間19分も完全なGPU稼働総時間ではなく、初期pilot、診断microbench、旧A単体の推論、CPU前処理、EDA、失敗処理、中断ロス等は別です。2019最初10epochは再起動・BIOS停止をまたぐため、3つのsession末尾(epoch2・3・10)を足し、完了epoch分だけで7時間27分05秒としました。既知の部分epoch中断ロスだけでも約8分26秒あり、上表には加えていません。epoch3→4では時計がリセットしても秒数が減らないため、単純な差分検出ではなく再開履歴で区切りました。
主要ジョブ45時間19分と経過69時間49分は異なる集計です。並行作業があるので足しません。戦略3時間33分も経過時間の内数です。
| 対象 | 初期20 | 追加80 | 累計100 | 追加20・通常lr | 追加20・低lr | 累計120・低lr |
|---|---|---|---|---|---|---|
| TensorNet方向128 fold0 | 1:07:56 | 4:36:41 | 5:44:37 | 1:08:24 | 1:08:45 | 6:53:22 |
| TensorNet方向128 fold1 | 1:08:13 | 4:40:05 | 5:48:18 | 1:08:31 | 1:08:26 | 6:56:44 |
時:分:秒、学習・検証・保存込み。経路別の表と、試した全条件の集計は区別します。低lr120の2本の経路累計は13時間50分06秒。ただし探索では通常lrの対照も実行するため、現代モデル全探索の20時間05分とは一致しません。親20/100epochの共有計算は一度だけ数えます。小数秒を合計してから丸めるため、表示された秒の足し算と1秒程度ずれる場合があります。
作者は当時1モデルの学習を3〜5日と報告しています。13本なら逐次換算で39〜65モデル日ですが、異なる当時の計算環境の報告です。RTX3060での全再学習時間にそのまま換算できません。公開重み再生の実測と全再学習の未測定部分を区別します。
コンペとデータを理解する
何をするコンペ? — 「分子の中の2原子」を選び、Jを当てる
このコンペの名前は Predicting Molecular Properties です。分子の形や原子の種類を手がかりに、
指定された2つの原子のscalar coupling constant(スカラー結合定数、J)を予測する回帰問題です。
回帰とは、カテゴリを選ぶのではなく、84.8のような連続した数値を予測することです。
Jは、原子核の磁気的な影響が電子を介して別の原子核へ伝わる相互作用を表し、NMRスペクトルの分裂に関係します。
単位はHz(ヘルツ)です。分子内の原子の並び方や周囲の環境によって値が変わります。
Jは正にも負にもなるので、負の数も有効な正解です。
例えば同じメタン分子でも、HとCの組と、HとHの組では予測する値が違います。
分子1個に対して数値を1つ出すのではなく、指定された原子対1組に対して数値を1つ出します。
学習時は正解のJが与えられ、testではJが隠されています。testの各行に対してJを予測し、提出します。
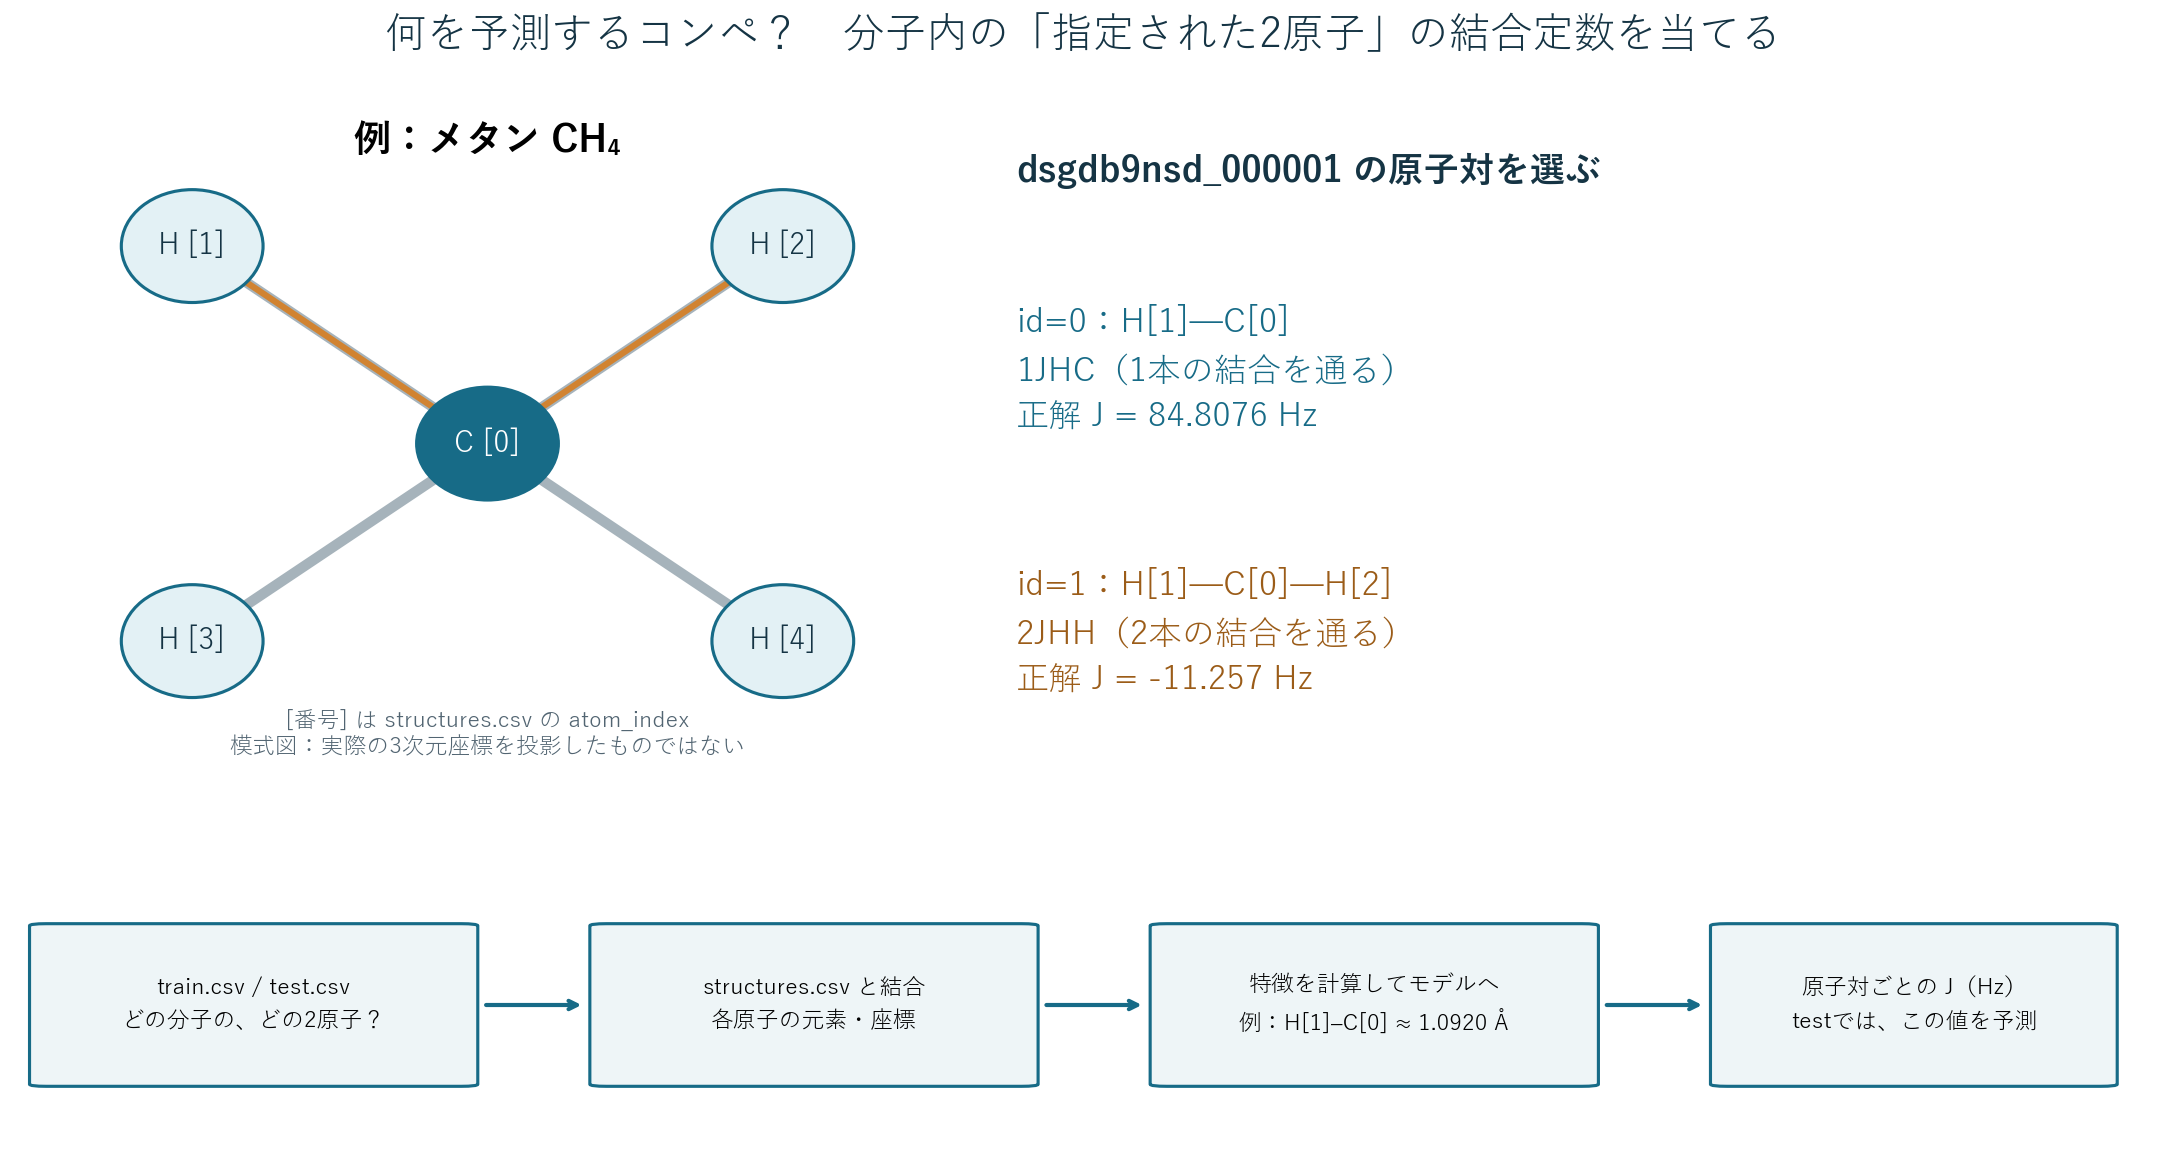
この図は概略説明用です。メタンの結合関係を描いた模式図で、実座標の縮尺・3次元方向は表していません。
概念CGは実座標の測定図ではありません。
train.csvを見てみる — 1行は「問題と正解のセット」
以下は実際の旧 train.csv の先頭6行です。説明用に作った架空のデータではありません。
| id | molecule_name | atom_index_0 | atom_index_1 | type | scalar_coupling_constant |
|---|---|---|---|---|---|
| 0 | dsgdb9nsd_000001 | 1 | 0 | 1JHC | 84.8076 |
| 1 | dsgdb9nsd_000001 | 1 | 2 | 2JHH | −11.257 |
| 2 | dsgdb9nsd_000001 | 1 | 3 | 2JHH | −11.2548 |
| 3 | dsgdb9nsd_000001 | 1 | 4 | 2JHH | −11.2543 |
| 4 | dsgdb9nsd_000001 | 2 | 0 | 1JHC | 84.8074 |
| 5 | dsgdb9nsd_000001 | 2 | 3 | 2JHH | −11.2541 |
| 列 | 意味 | 最初の行での読み方 |
|---|---|---|
| id | 原子対の行を識別するID | 0。提出の予測と行を対応させるための番号 |
| molecule_name | どの分子か | dsgdb9nsd_000001。同じ名前なら同じ分子 |
| atom_index_0 | 1つ目の原子の番号 | 1 → この分子の原子番号(index)1(H) |
| atom_index_1 | 2つ目の原子の番号 | 0 → この分子の原子番号(index)0(C) |
| type | 結合経路の本数と元素の組 | 1JHC → 結合1本を通るHとCの組 |
| scalar_coupling_constant | 予測したい正解のJ(Hz) | 84.8076。この列が目的変数 |
最初の行は「分子 dsgdb9nsd_000001 の原子1と原子0を選ぶと、正解のJは84.8076 Hz」と読みます。
2行目は同じ分子の原子1と原子2の組で、正解は−11.257 Hzです。
同じ分子名が繰り返されるのは、対象の原子対を変えた別の問題が複数あるためです。
atom_index_0 の末尾の0は『1つ目の端点』という列名であり、分子内の原子番号(index)0という意味ではありません。
その列の値が1なら分子内の原子番号(index)1です。atom_index_1も同様に、列の値を使って2つ目の原子を探します。
idとmolecule_nameは照合のキーです。分子名は元素記号や化学構造式そのものではありません。
structures.csvを見てみる — 1行は「原子1個の情報」
次は、同じ分子 dsgdb9nsd_000001 の全5原子です。座標は表示しやすい桁数に丸めています。
この分子にはCが1個とHが4個あるので、メタン CH₄ に対応します。
| molecule_name | atom_index | atom | x | y | z |
|---|---|---|---|---|---|
| dsgdb9nsd_000001 | 0 | C | −0.01269814 | 1.085804 | 0.008000996 |
| dsgdb9nsd_000001 | 1 | H | 0.002150416 | −0.006031318 | 0.00197612 |
| dsgdb9nsd_000001 | 2 | H | 1.011731 | 1.463751 | 0.0002765748 |
| dsgdb9nsd_000001 | 3 | H | −0.5408151 | 1.447527 | −0.8766437 |
| dsgdb9nsd_000001 | 4 | H | −0.5238136 | 1.437933 | 0.9063973 |
| 列 | 意味 | 読み方 |
|---|---|---|
| molecule_name | 原子が属する分子 | train.csvと同じ名前で対応付ける |
| atom_index | 分子内の原子番号(0始まり) | 0から始まる。同じ分子の中で原子を識別する |
| atom | 元素記号 | H=水素、C=炭素、N=窒素、O=酸素、F=フッ素 |
| x / y / z | 原子の3次元座標(Å) | 3つの値で空間内の位置を表す。1 Å = 10⁻¹⁰ m |
atom_indexは分子ごとに0から振り直されます。別の分子の原子0と区別するため、
molecule_nameとatom_indexの2列を組み合わせて原子を探します。
座標には負の値があっても正常です。原点や分子の向きを変えるとx/y/zは変わりますが、原子間距離は変わりません。
structuresは原子の表で、どの原子対を予測するかやJの正解は書かれていません。
また、化学結合の一覧が直接入っているわけでもありません。
2つのCSVをどう結び付ける? — id=0を実際に読む
まずtrainの最初の行から分子名と分子内の原子番号(index)1・0を取り出し、structuresから次の2行を探します。
| atom_index | molecule_name | atom | x | y | z |
|---|---|---|---|---|---|
| 1 | dsgdb9nsd_000001 | H | 0.002150416 | −0.006031318 | 0.00197612 |
| 0 | dsgdb9nsd_000001 | C | −0.01269814 | 1.085804 | 0.008000996 |
このように「キーを使って別の表から情報を付け足す」操作を**結合(join / merge)**と呼びます。
1つ目の原子用と2つ目の原子用に、structuresを2回結合します。
得られた2点の座標から、直線距離を計算できます。
距離 = √((x₁−x₀)² + (y₁−y₀)² + (z₁−z₀)²)
この原子対の距離は 約1.091953 Å です。H–Cの距離などを入力にし、正解の84.8076 Hzに近い値を出すようモデルを学習します。
この例の距離は特徴量(モデルへの入力)、Jは目的変数(当てたい答え)です。
Jが距離だけで決まるとは限らないため、後のEDAで分子の大きさ・周囲の原子・構造特徴との関係を調べます。
1J / 2J / 3Jは何が違う?
先頭の数字は、2原子を結ぶ共有結合経路の本数です。直線距離の短・中・長という階級ではありません。
1JHCはH–Cのように1本、2JHHはH–C–Hのように2本を通る原子対です。
3JHHの経路例はH–C–C–Hです。ただし、この例は中間原子が常にCという意味ではありません。
メタンの模式図ではH[1]とC[0]が1JHC、H[1]とH[2]が2JHHに当たります。
test.csvとsample_submission.csvの役割
test.csvには、trainと同じ分子名・分子内の原子番号(index)・typeがありますが、正解列 scalar_coupling_constant がありません。
同じ手順でstructuresを結合して特徴量を作り、モデルにJを予測させます。
sample_submission.csvは提出ファイルの見本です。idと予測した scalar_coupling_constant の2列を作ります。
見本に入っている数値はtestの正解ではありません。今回使用する旧testは2,505,542行あり、その全行の予測が必要です。
ここまでを踏まえ、まずEDA(探索的データ分析)で「どんな分子・原子対があり、何がJと関係しそうか」を図で確認します。
今回のデータの範囲
旧trainは4,658,147行・85,003分子、旧testは2,505,542行・45,772分子。
structuresは2,358,657原子行・130,775分子です。train/test間の分子重複は0です。
ID連続性、sampleとのID順一致、欠損、重複原子キー、原子対の座標被覆、有限値、SHA256をスクリプトで検査しました。
既存の記事で確認済みの旧版を使用します。
現行の公式sample_submissionと旧testでは行数が352行異なります(前の記事を参照)。この差を、現行testの行を足して埋めることはしません。旧データ4ファイルを組で使います。
2026年10月7日の全0提出による採点確認は過去の記録であり、今回の学習成果・再提出ではありません。
現在の公式trainは読み込みません。旧test分子の計算値やhidden labelsも使いません。
評価と検証を先に決める
スコア = 8タイプそれぞれの log(MAE) の平均です。logは自然対数、小さいほど良い指標です。
タイプごとの件数によらず8タイプは等重みです。全行の通常MAEだけではモデルを判断できません。
全タイプのMAEを半分にできれば、スコアは log(0.5) ≈ −0.693 改善します。
指標を安全に計算するためMAEの下限は1e-9としています。
同一分子の行をランダムに分けると、検証側の分子を学習時に見てしまいます。
そこで分子名を並べ、seed=20261024で5分割し、foldファイルとhashを固定しました。
EDAからの特徴候補はfold0で探索し、最終採用前に他foldでも確認します。
EDAと構造の6クラスタ候補
構造特徴の作り方
元素数H/C/N/O/F、総原子数、重原子数、重心からの距離、回転半径、全原子間距離の平均・標準偏差・最大、
座標共分散の固有値の計15特徴を分子ごとに作ります。生のx/y/zはクラスタリングに使いません。
これらは分子を平行移動・回転しても変わらず、原子の並べ替えにも依存しません。
固有値は形の広がりを表す座標共分散の値で、質量重み付き慣性モーメントではありません。
図中の inertia_0/1/2 はこの固有値です。
原子対の学習では、2原子の距離・逆距離、各端点の近傍距離3本、1.8 Å以内の近傍原子数、重心からの距離も使います。
1.8 Åの近傍数は幾何特徴であり、化学結合の次数や共有結合グラフと同一ではありません。
端点特徴は和と絶対差にし、2原子を交換しても同じ値になるようにしています。
8タイプの件数
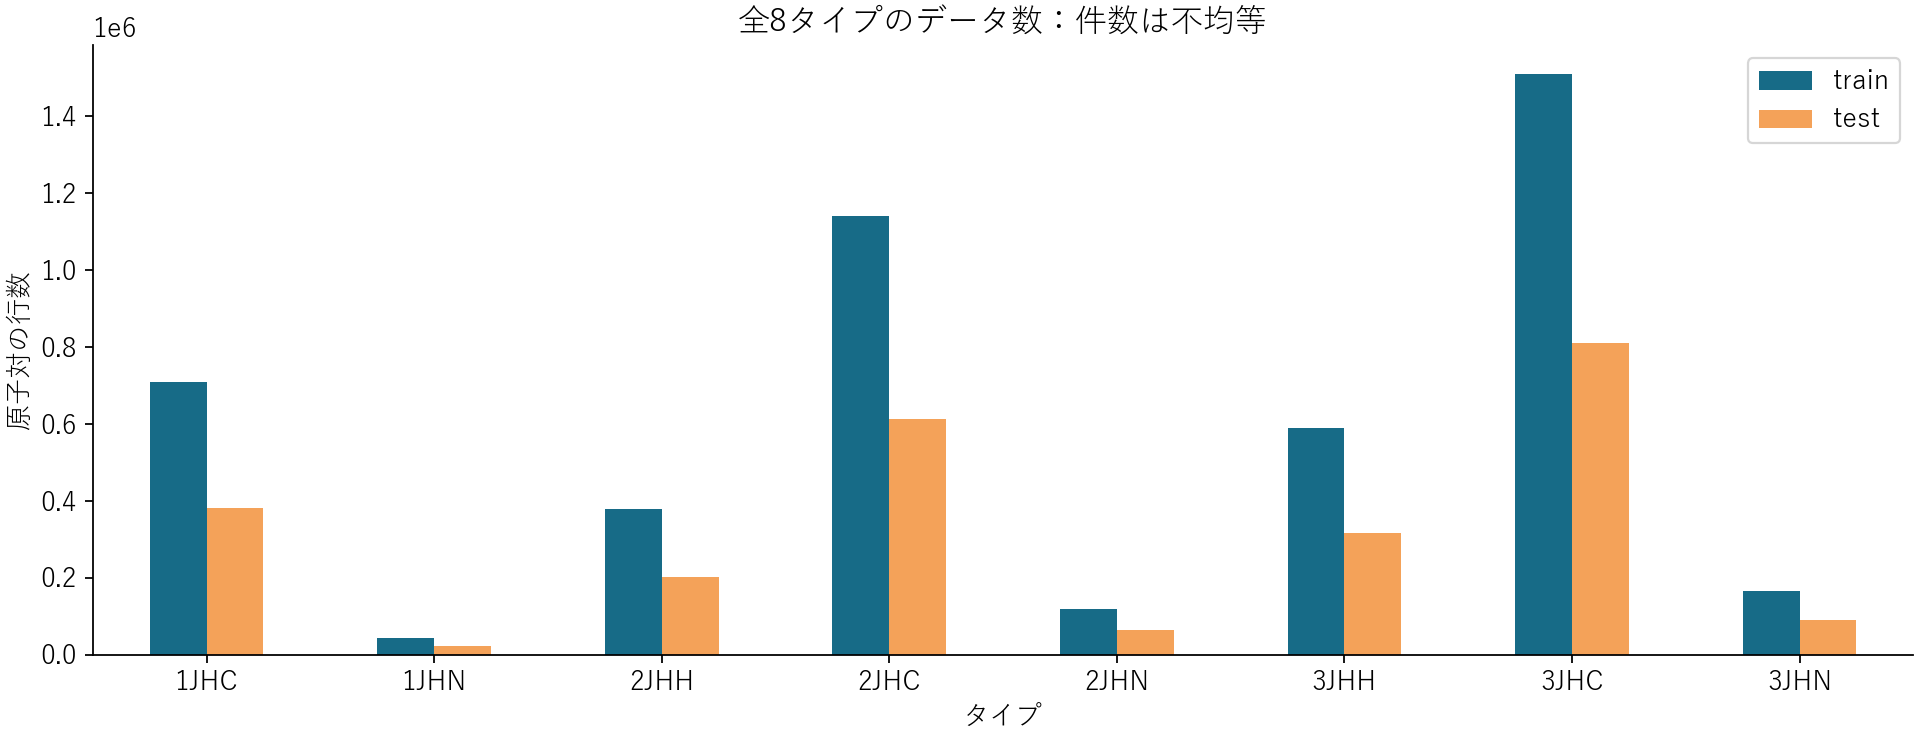
3JHCや2JHCの行数が多く、1JHNは少数です。件数の多いタイプだけに合わせると、等重みの評価で不利になります。タイプ別のMAEを必ず残します。
trainとtestの構成
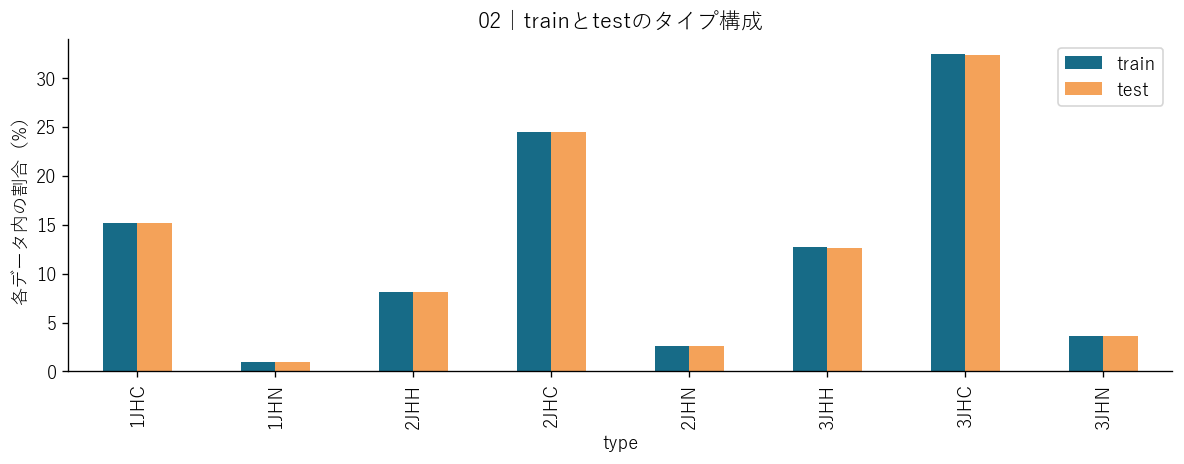
タイプ割合を比較します。似た割合でも条件付き分布や分子構造が完全に同じとは限りません。分布が重なる図だけで分布差なしと断言しません。
タイプ別の目的変数
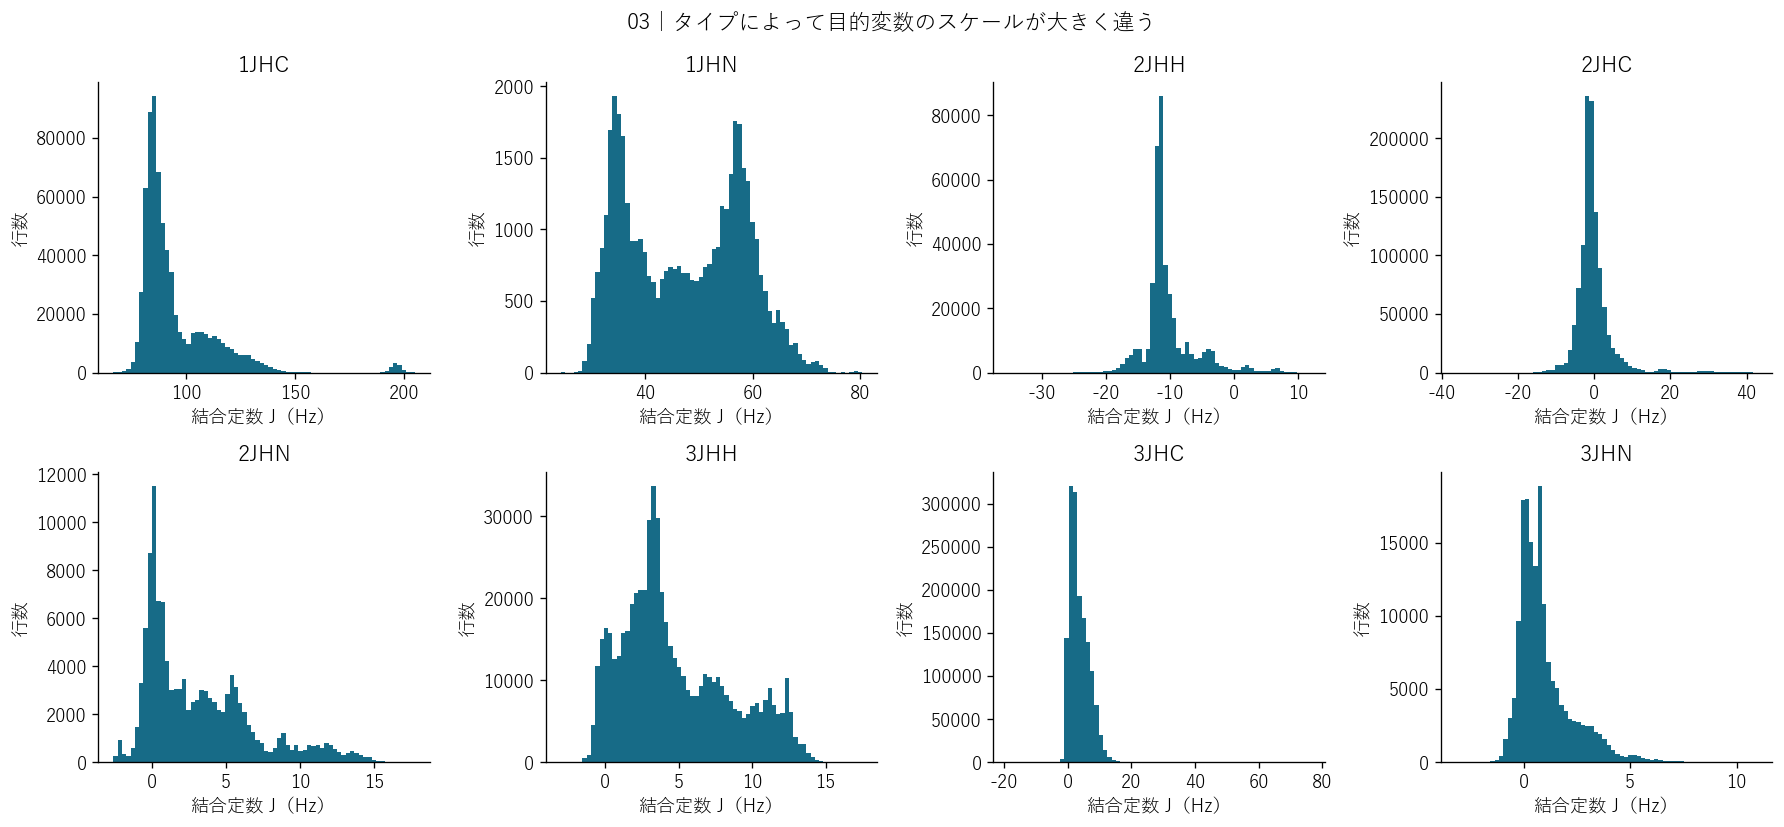
1JHCと3JHNでは値の大きさも分布も違います。生のHzで同じ損失を全行平均すると、大きいスケールや多数派の影響が強くなります。タイプ別モデルや学習側だけで計算した標準化を候補にします。
中央値とばらつき
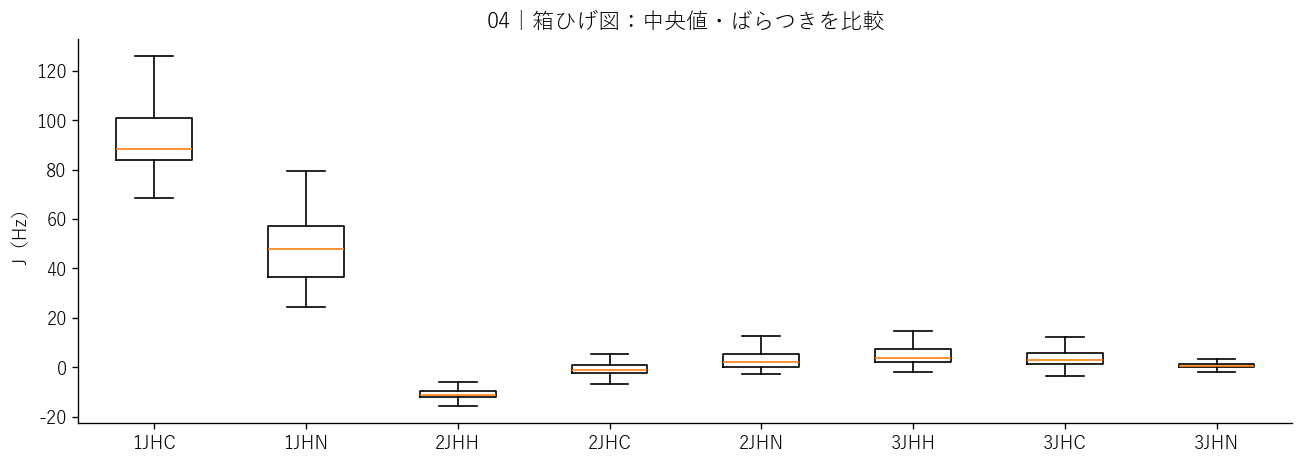
箱は中央50%、線は中央値。外れ値は図から省略していますが、学習データから削除したわけではありません。大きい値を自動的に誤りと決めないことが大切です。
分子の大きさと行のまとまり
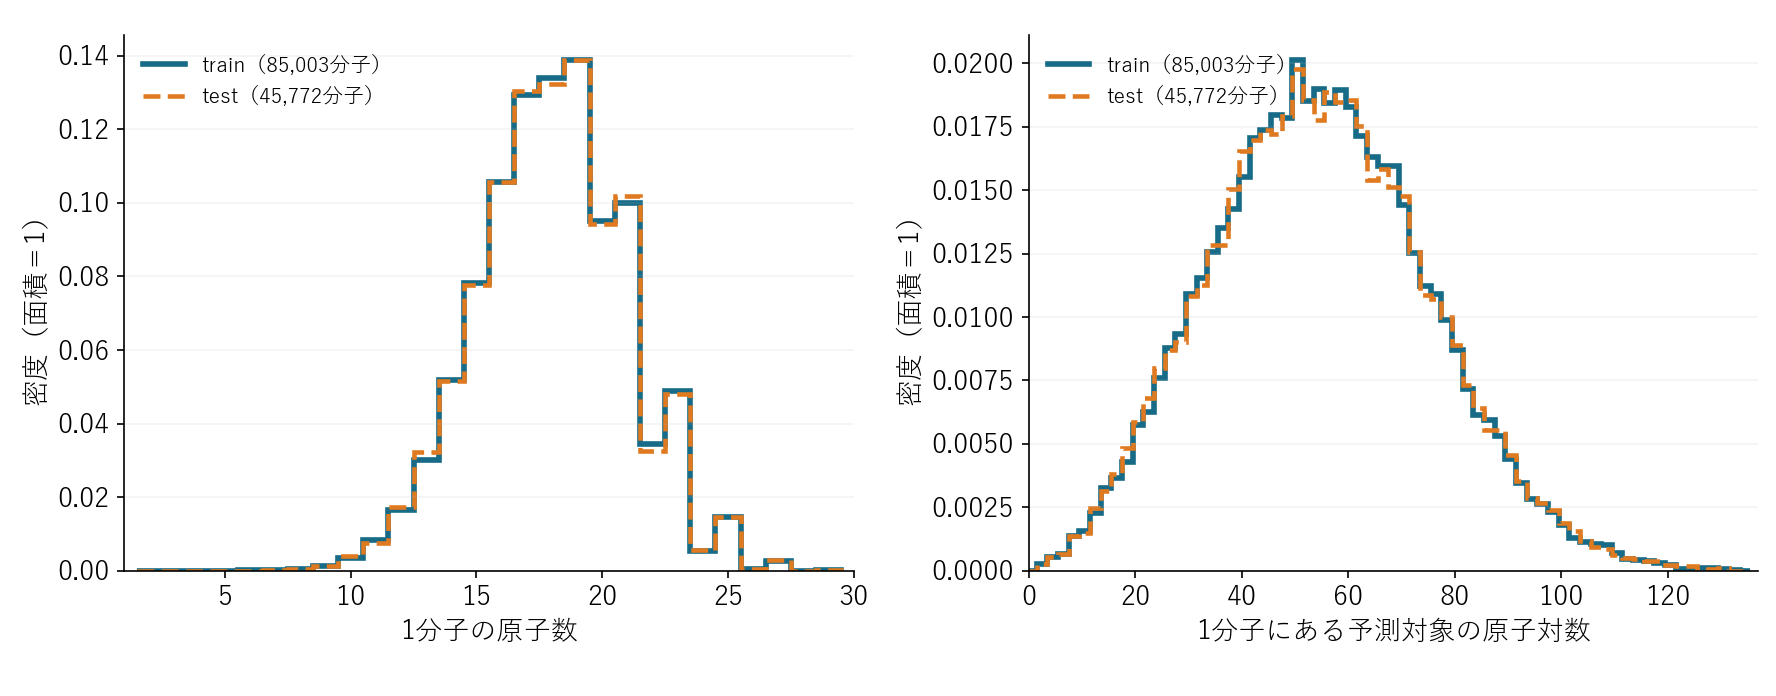
原子数と予測対象ペア数を示します。分子ごとに行数が違うため、分子平均の誤差と行平均の誤差は同一ではありません。GPUでは大きい分子やトークン数も計測します。
どんな元素を扱うか
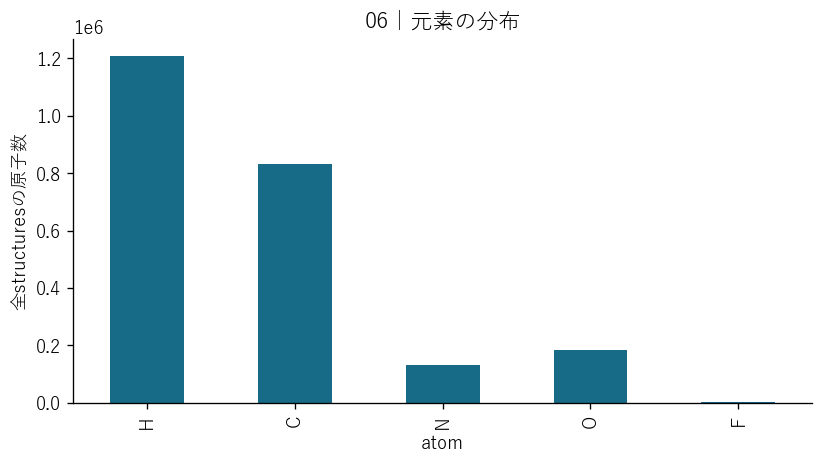
structures全体の元素数です。Fなどの少数元素は、局所環境の表現や失敗例の切り口になります。trainのラベル数そのものとは異なります。
原子間距離だけで説明できるか
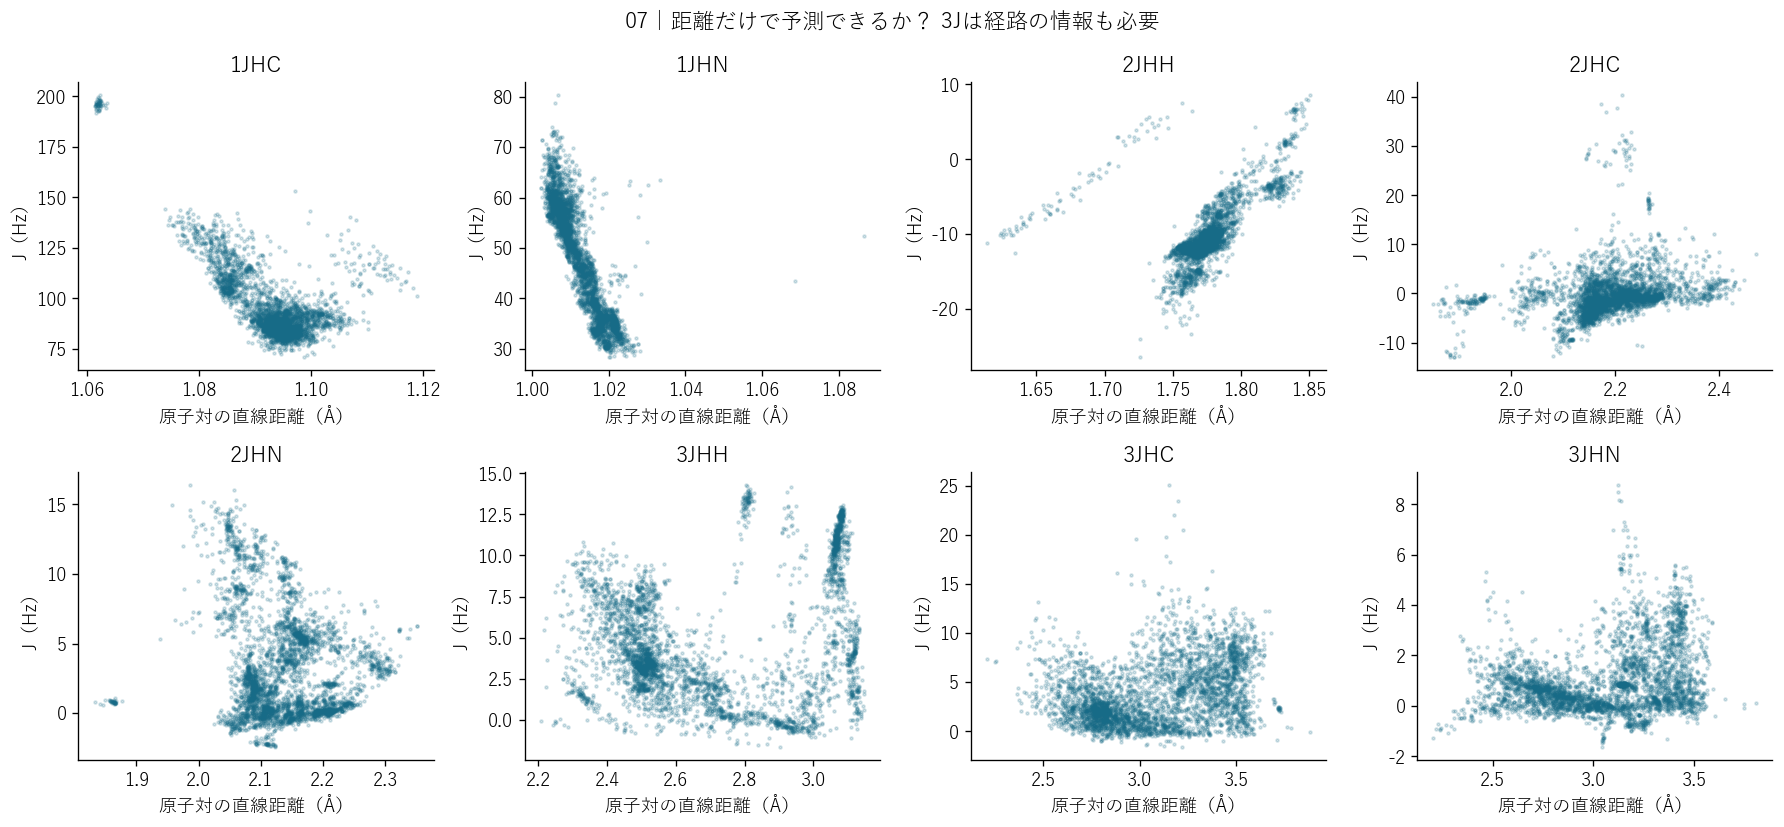
各タイプ4,000行を固定seedで抽出しました。距離との関係は見えますが同じ距離でも幅が残ります。距離ベースラインに局所環境、角度・経路情報を追加する理由になります。
距離分布を見る
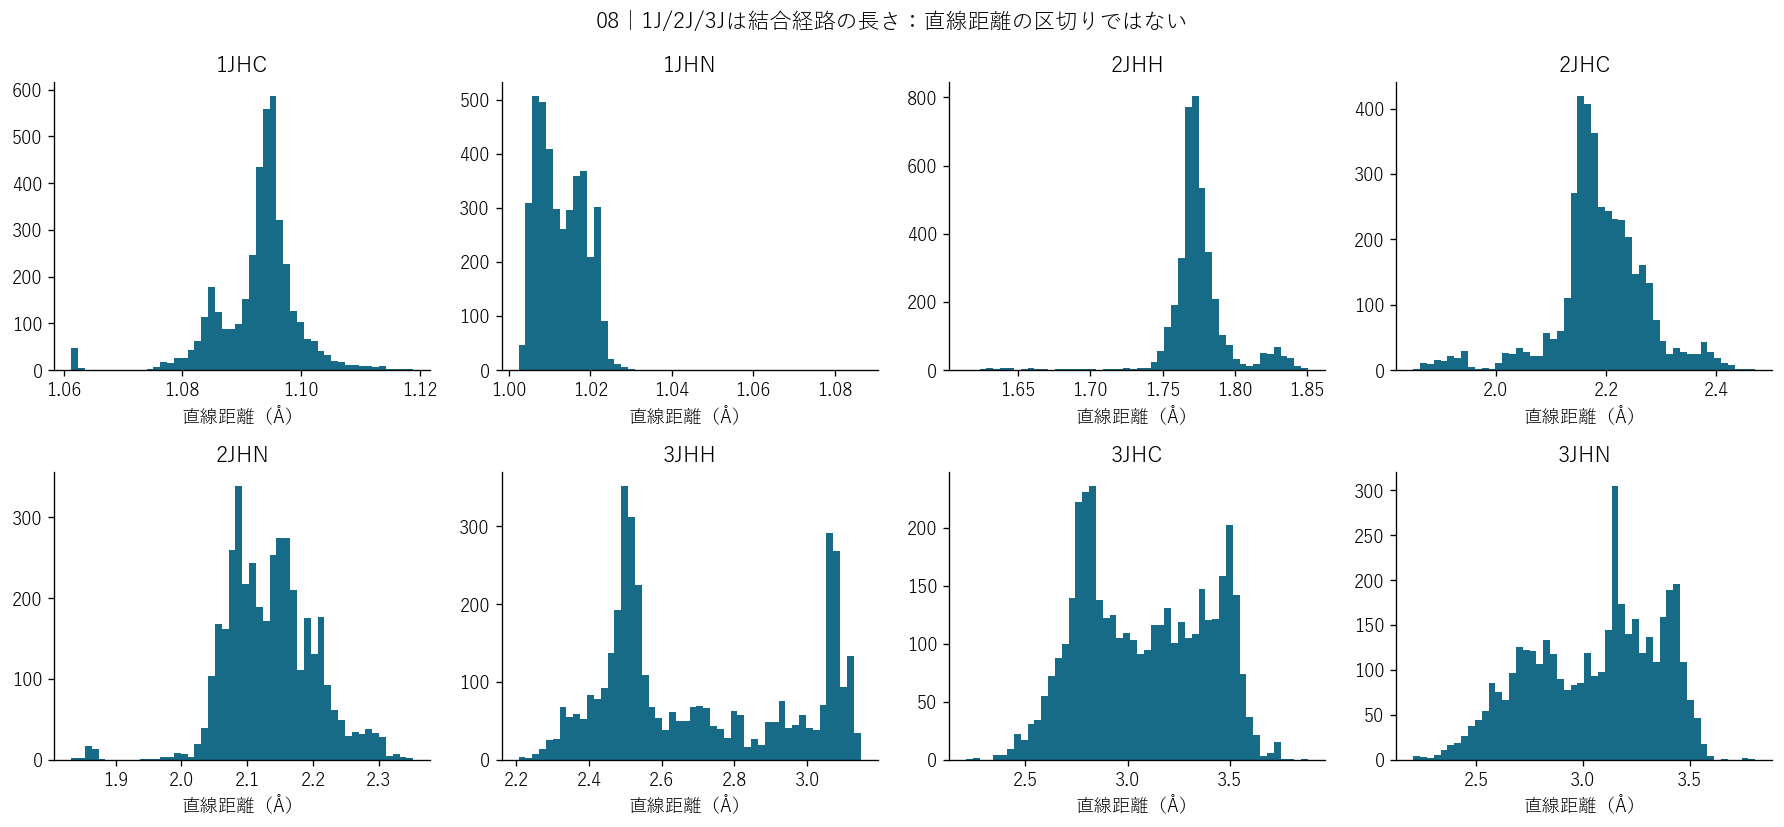
前の原子間距離とJの図と同じ標本です。経路が同じ本数でも直線距離は連続的に変わります。距離の閾値だけで1J/2J/3Jを置き換えないようにします。
特徴同士の相関
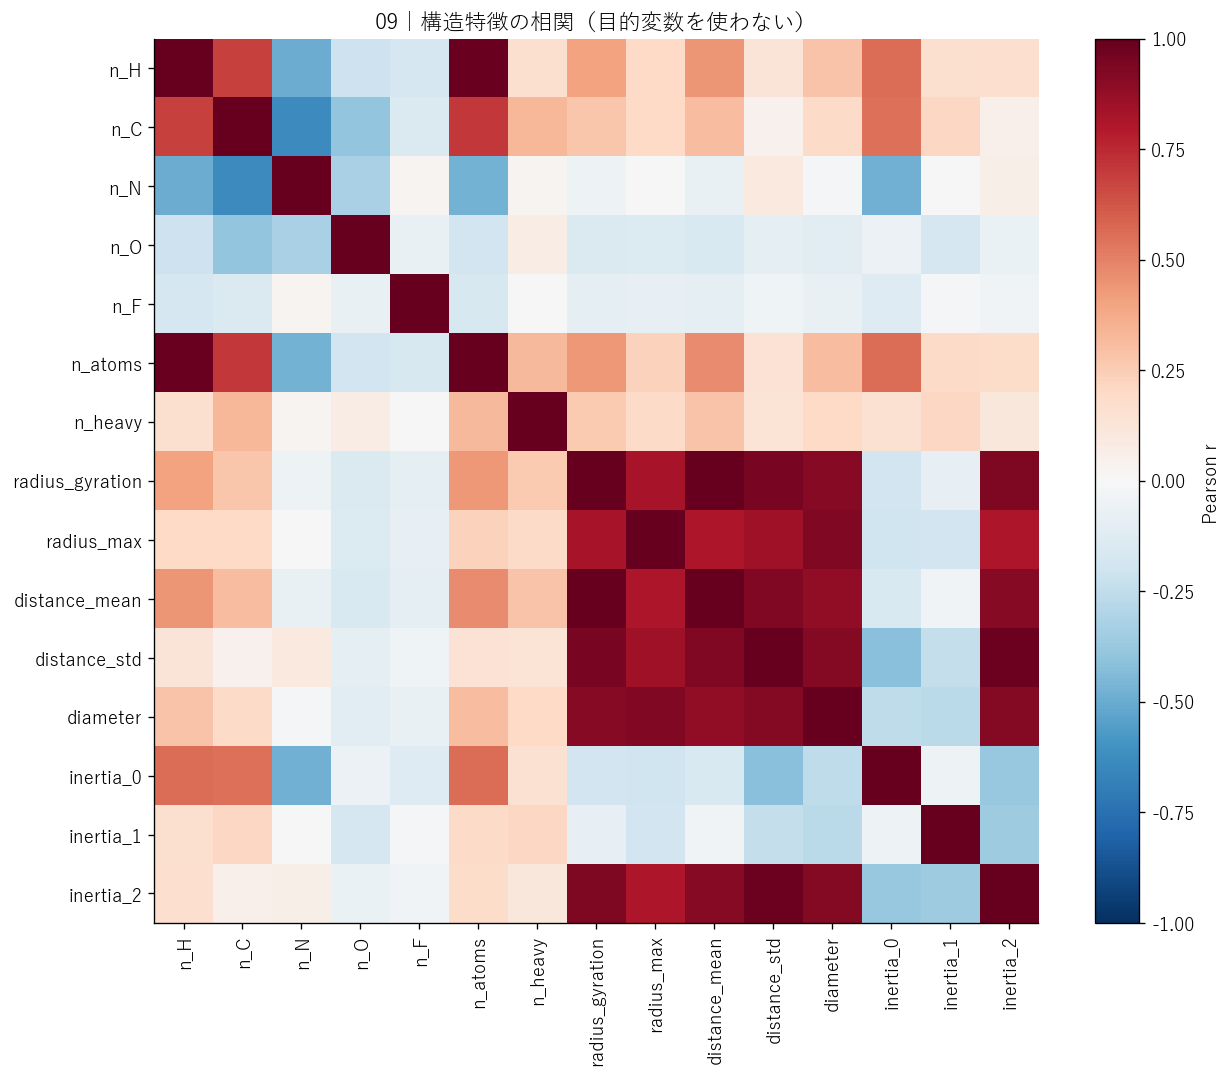
原子数と分子サイズなど関連した特徴が並びます。標準化してk-meansへ入れますが、相関した特徴を複数入れること自体も距離の重み付けに影響します。今回のクラスタは化学的に唯一の分類ではありません。
分子単位の5分割
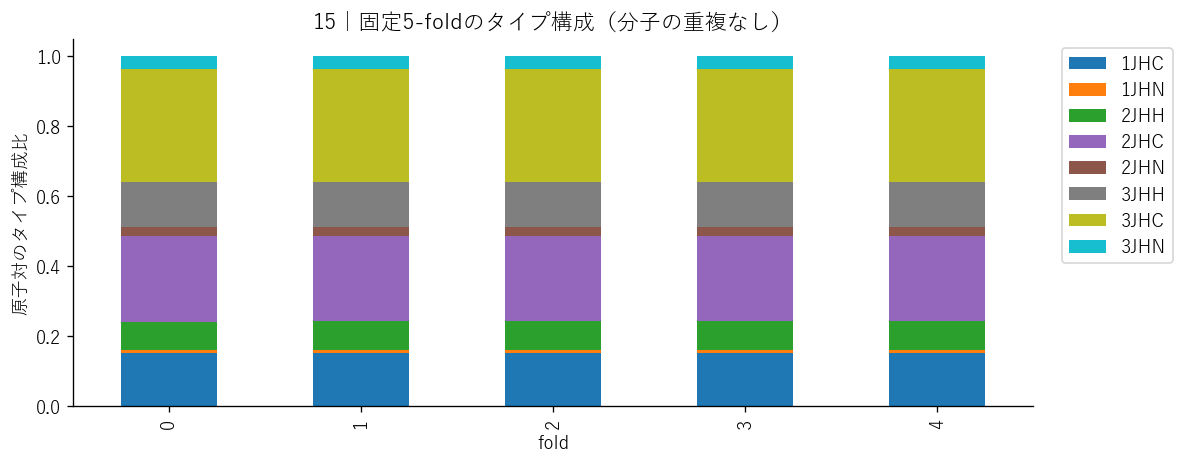
同じ分子は1つのfoldにだけ入ります。今回は分子をランダム5分割しており、タイプで厳密に層化した分割ではありません。タイプ構成の偏りを検査し、全OOF集計で評価します。
Jの全体分布:大きな山と小さな山
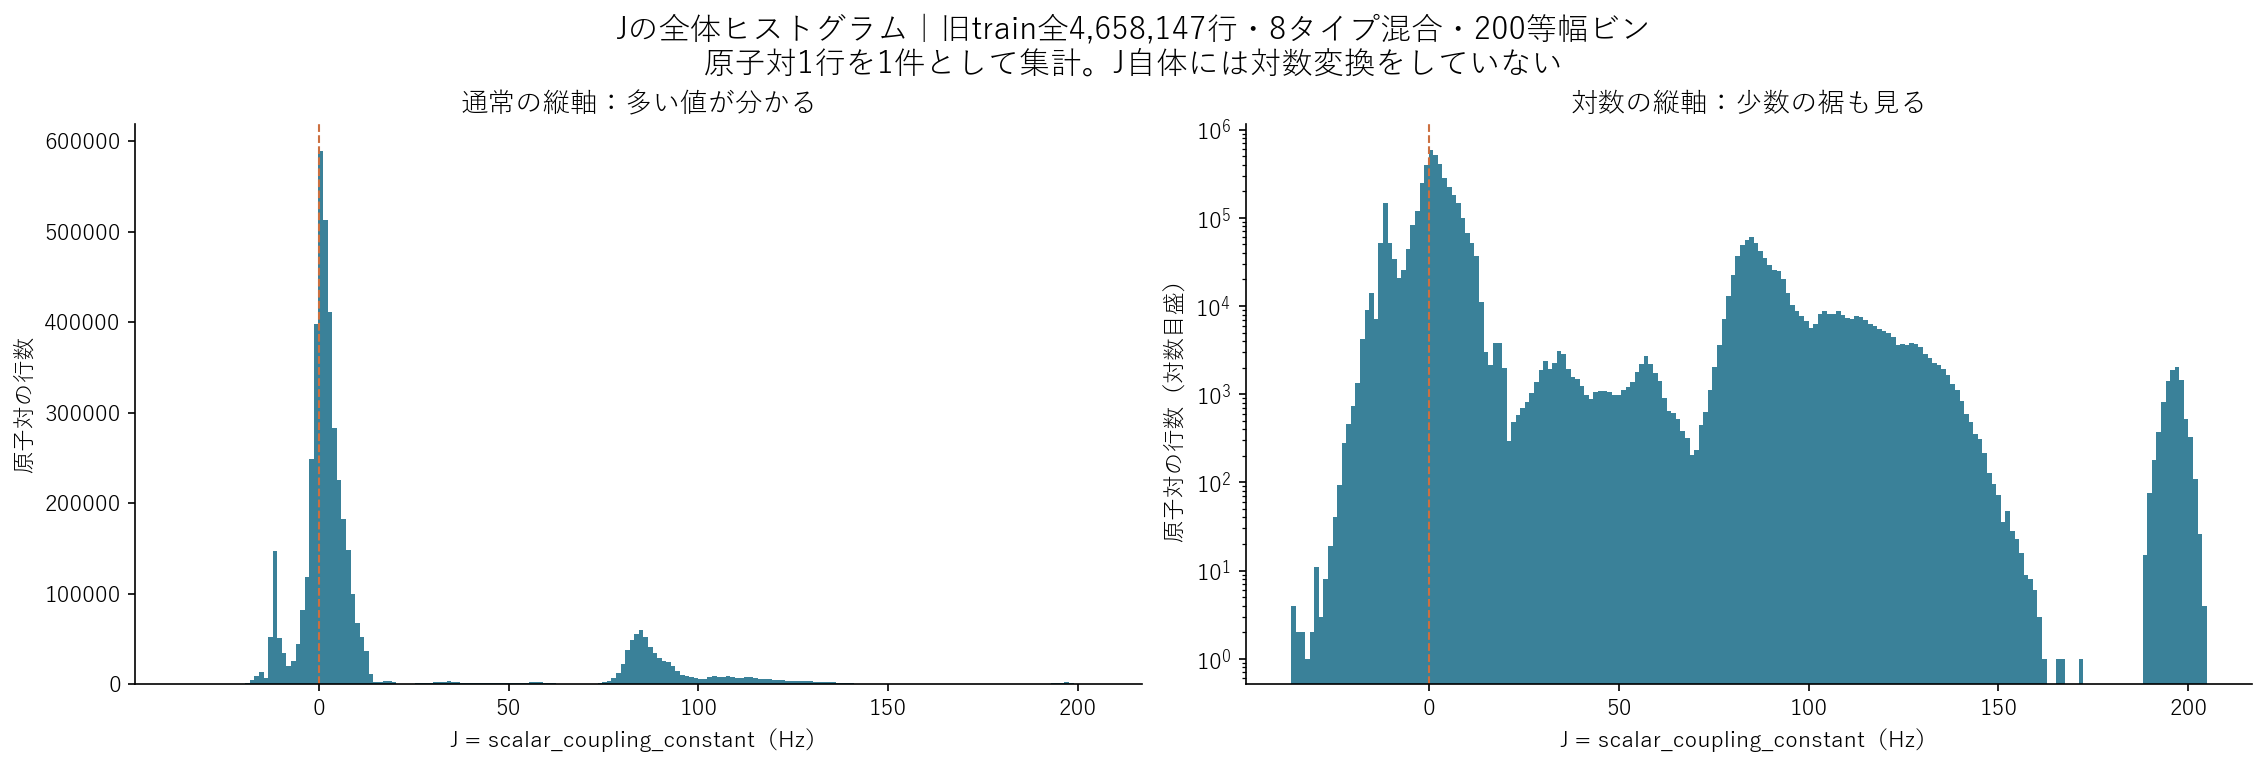
旧train全4,658,147原子対のJを集計しています。右図は件数の縦軸だけを対数目盛にしています。J自体は対数変換していません。複数の結合タイプが重なっているため、全体の山をそのまま化学種と解釈しません。
山の由来を結合タイプ別に確認
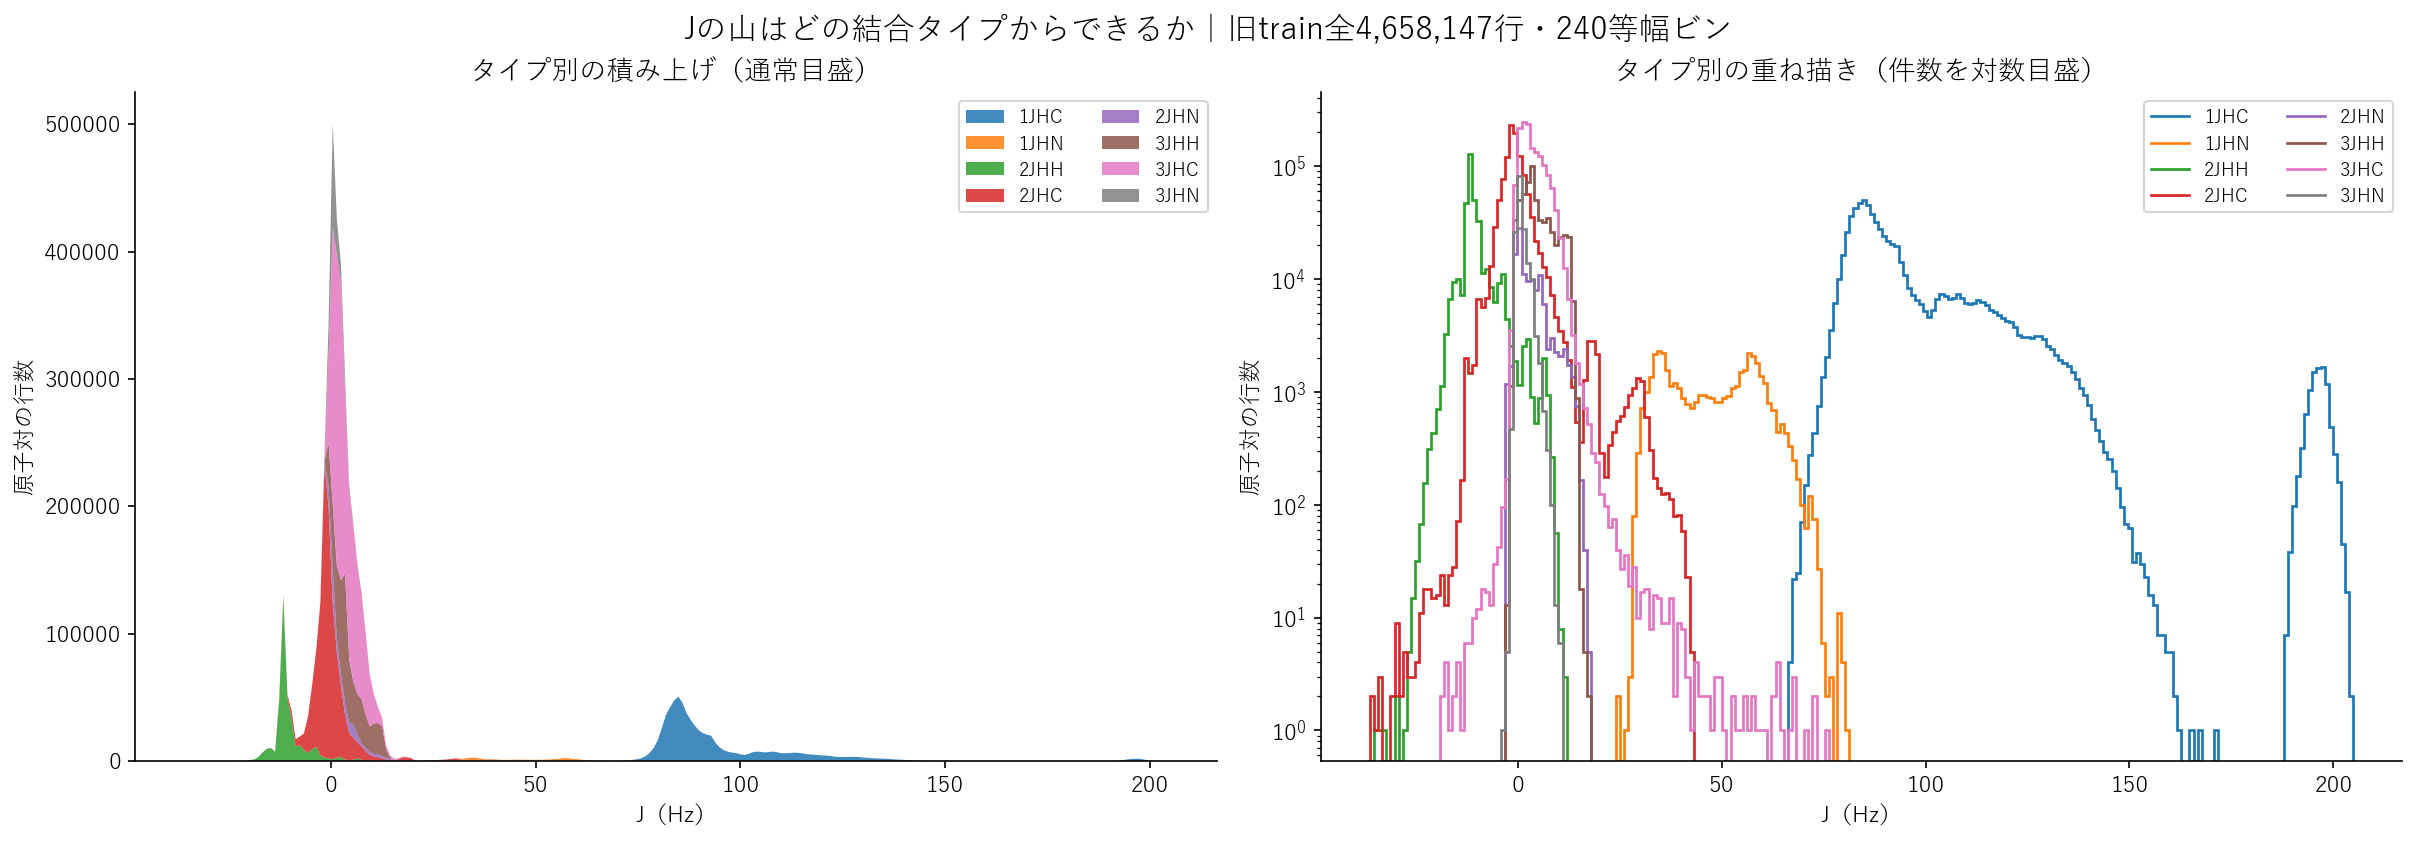
負のJの山には2JHH、0付近には複数のタイプ、30~60 Hz付近には1JHN、大きな正の値には1JHCが多く含まれます。タイプと山は一対一ではありません。
J分布の通常表示・対数表示・谷分割を並べて見る
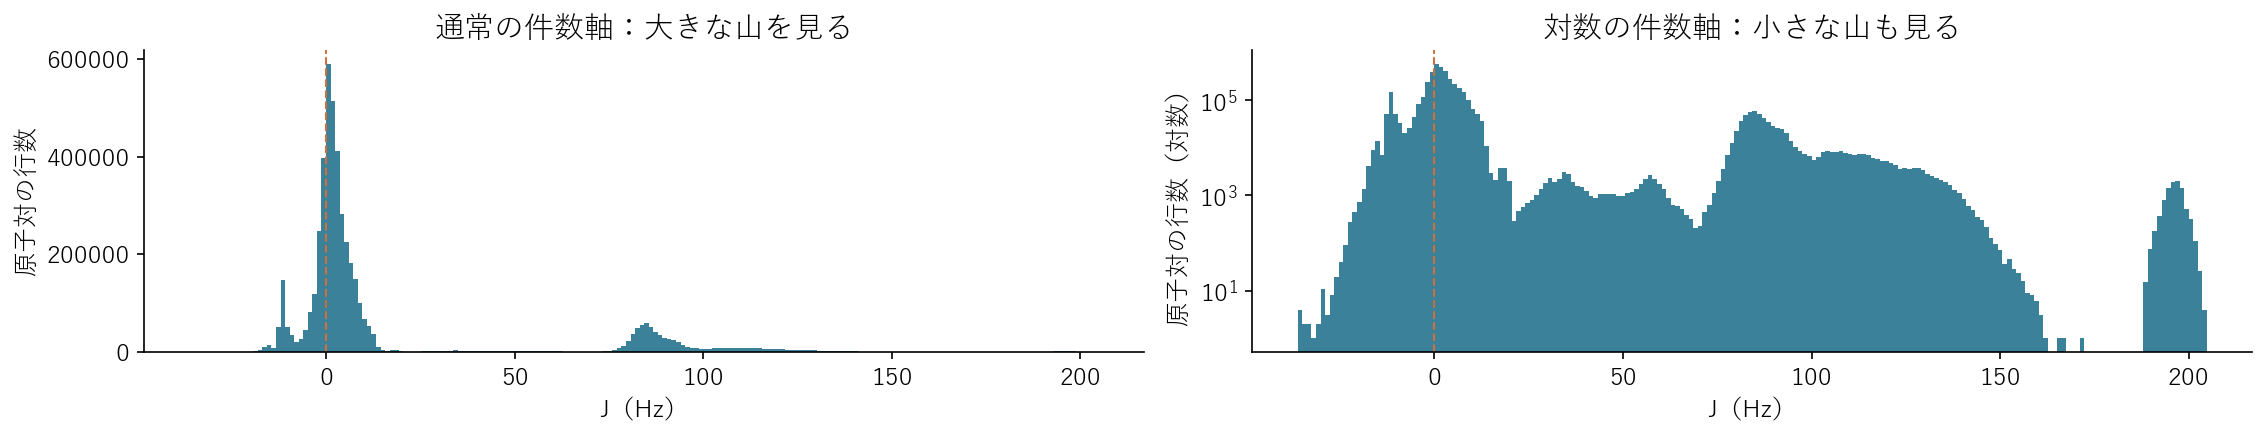
同じ全旧train4,658,147原子対・同じ200ビンで、右だけ件数軸を対数にしています。Jそのものの対数変換ではありません。
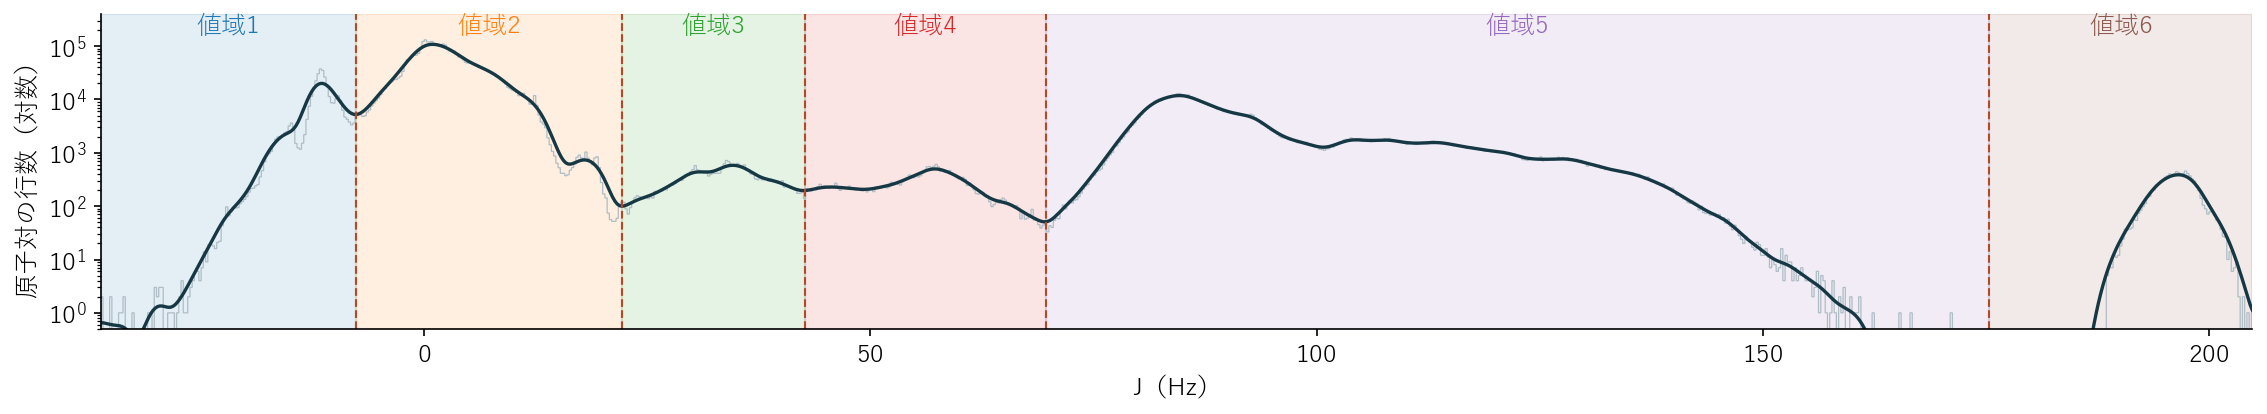
こちらは0.25Hzビンの件数を帯域幅1Hzで平滑化したものです。小さな山・谷から6値域を観察して分子構造を6群に分ける探索案を得ました。J値域と分子構造クラスタは別分類です。
対数ヒストグラムの谷から6つの値域を考える
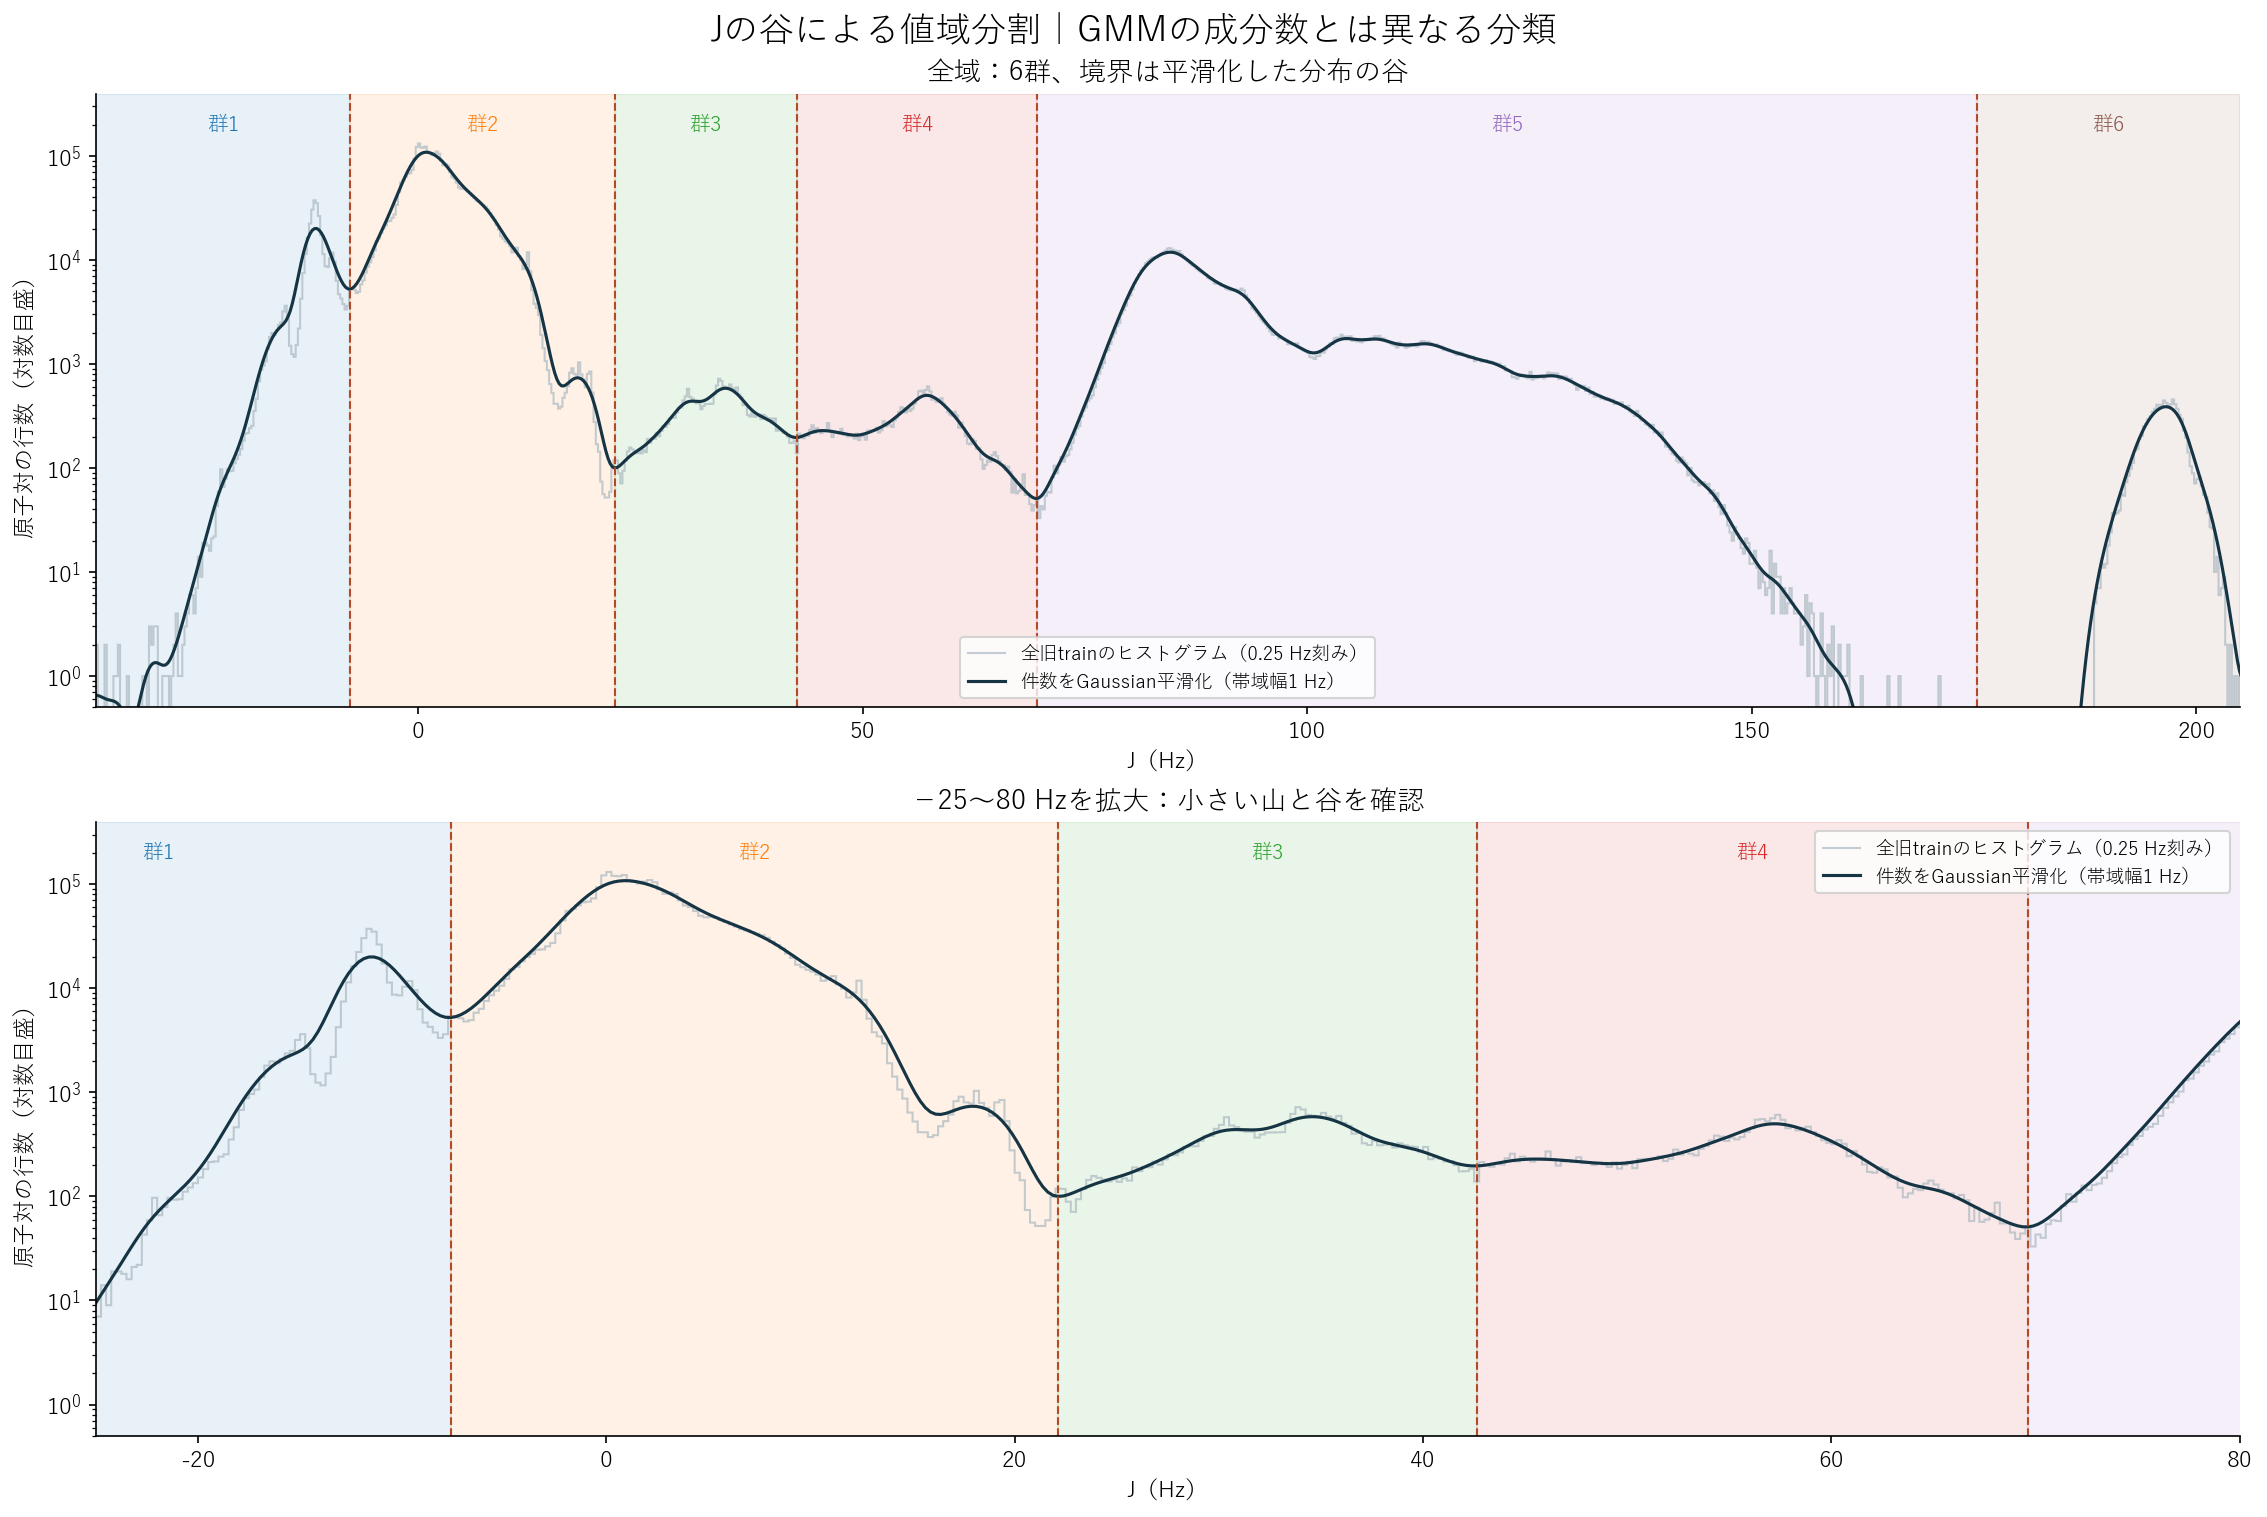
0.25 Hz刻みの件数を帯域幅1 Hzで平滑化し、目立つ山の間の谷を境界にしました。帯域幅0.5~1.5 Hz、ビン幅0.125~1 Hzでも6群となり、固定5-foldの各分子集合でも6群でした。谷の位置には変動があるため、以下の境界は説明用の目安です。
| Jの値域群 | Jの範囲の目安(Hz) | 原子対の割合 |
|---|---|---|
| 1 | −∞ ~ −7.6 | 7.19% |
| 2 | −7.6 ~ 22.1 | 76.45% |
| 3 | 22.1 ~ 42.6 | 0.57% |
| 4 | 42.6 ~ 69.6 | 0.56% |
| 5 | 69.6 ~ 175.4 | 15.04% |
| 6 | 175.4 ~ ∞ | 0.20% |
なぜ分子構造のクラスタ数も6を候補にするか
Jの対数ヒストグラムを谷で分けると6群が読み取れたことから類推し、分子構造のk-meansでも6クラスタを候補にしました。
ただし、Jの値域群は原子対の正解値による分類、ここからの構造クラスタは分子の入力特徴による分類で、対象と基準が異なります。
両者が一対一に対応するという仮説ではなく、6が構造分類の最適数と証明されたわけでもありません。
教材として解釈できる粒度と、今後の予測へつながる仮説を得るための候補です。
構造クラスタには、元素数・分子サイズ・距離分布・座標共分散の固有値の15特徴を使います。
固定fold1~4の68,002学習分子だけで標準化とk-meansをfitし、fold0の17,001分子とtestへ適用しました。
クラスタを作る際に目的変数Jは使っていません。クラスタ番号C0~C5は便宜的な番号で、大小関係を意味しません。
学習分子の3,000分子標本でのシルエット係数は0.189、別初期値とのfold0割当の一致度ARIは0.989でした。
初期値には比較的安定していますが、明確に離れた6種類の化学種があるという証拠ではありません。
6クラスタの構造プロフィール
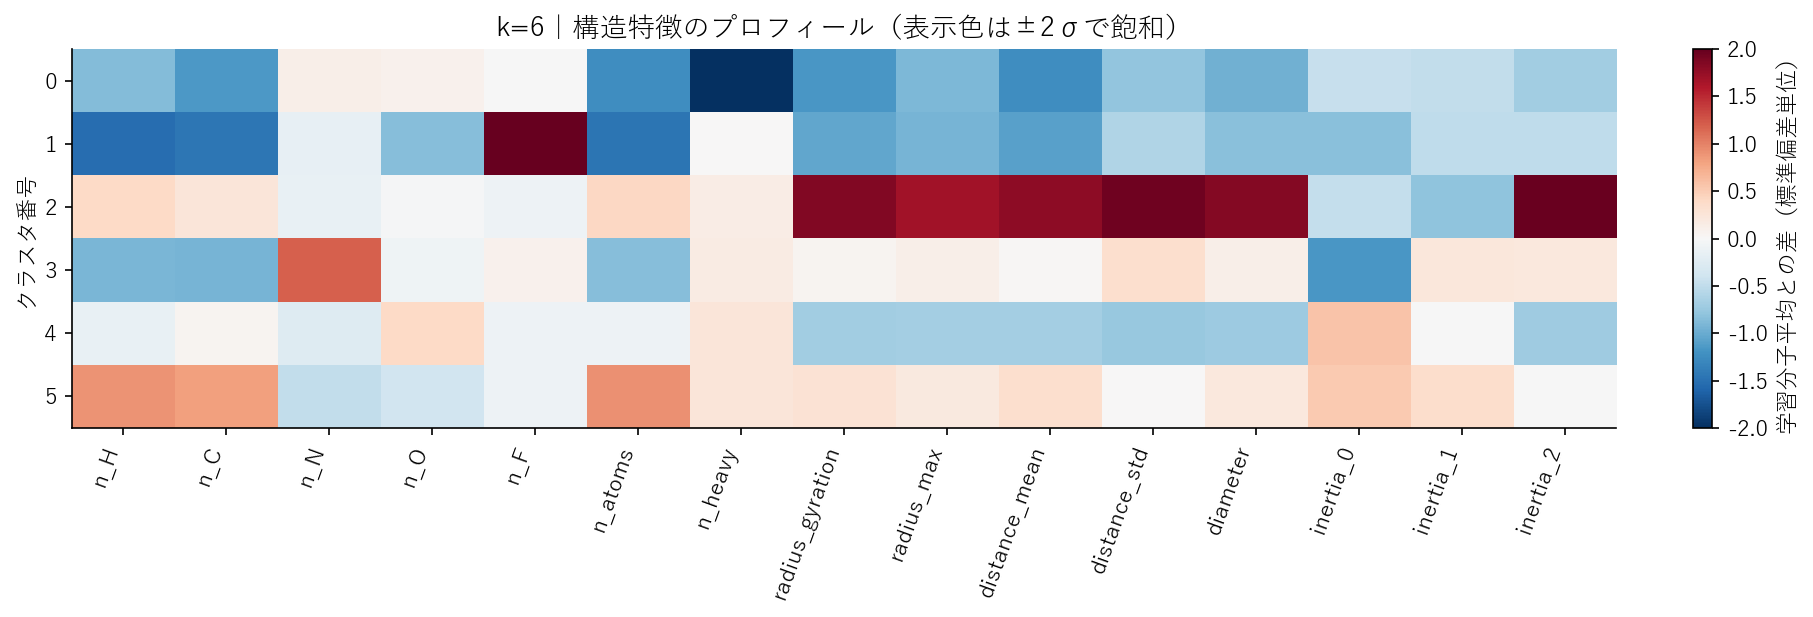
色は学習分子平均との差を標準偏差で割ったものです。元素数・形・広がりの複数の特徴が組み合わさって群ができています。相関する形状指標を複数含むため、その選び方自体も距離へ影響します。
6クラスタの意味づけ仮説
| 構造群 | 意味づけ仮説 | 根拠と今後調べたいこと |
|---|---|---|
| C0 | 重原子が少なめの小さい分子 | 平均重原子数7.60、直径5.61 Å。サイズの異なる分子として層別に確認する。 |
| C1 | 複数のFを含む少数群 | 平均F数2.72。Fが周囲の電子環境に関係する仮説。学習側331分子と少数なので共有モデル内の特徴を優先する。 |
| C2 | 長軸が強く伸びた分子 | 平均直径8.34 Å、長軸割合0.785。経路・角度・二面角の違いを調べる候補。環や分岐は参考標本では比較的少ない。 |
| C3 | Nが多く薄い形の分子 | 平均N数2.27。参考標本では芳香族・sp2構造が比較的多く、元素と局所結合環境の関係を検証する。 |
| C4 | Oが比較的多くコンパクトな分子 | 平均O数1.75、直径5.83 Å。参考標本では複数の環・分岐が多く、環の大きさや複数経路を調べる候補。 |
| C5 | C・Hが多い分子 | 平均C数7.38、H数11.79。参考標本では非芳香族の環構造が多く、周囲の原子環境の違いを調べる候補。 |
環・芳香環・sp2・分岐の記述は、各群から無作為に最大50分子を選び、座標から結合を推定できた分子についての参考情報です。推定失敗もあるので、群全体の確定した化学分類や比率とは扱いません。長軸割合は最大固有値/固有値合計で、大きいほど一方向へ伸びた形です。
全分子の推定結合グラフでも確認しました
最初は各群の少数の参考標本を見ましたが、その後、旧データ全130,775分子でも座標から結合グラフを作りました。
クラスタ作成に使っていないfold0の17,001検証分子では、C3の約60%に芳香族結合があり、C4の約77%が独立な環を複数持ち、C5の約90%が芳香族結合を持たない環状分子でした。
C2は、複数の環を持つ割合や重原子間の分岐が比較的少なく、細長い群という仮説と整合します。C0は小さい群ですが、環が少ない群という意味ではありません。
結合と芳香族の判定は座標からの推定であり、独立に与えられた正解ラベルではありません。また、独立な環の数はグラフの指標で、化学的な環の数え方が一つに決まる意味ではありません。
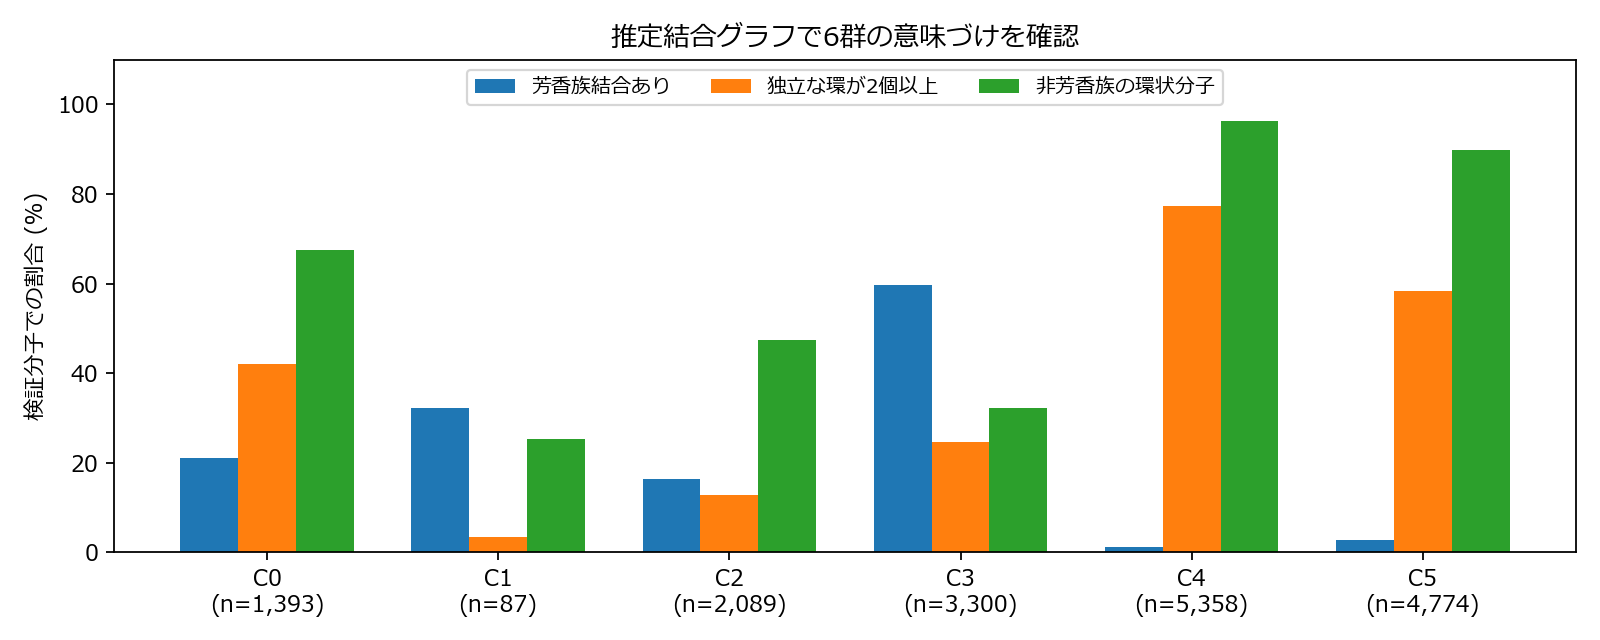
これで構造の意味づけには根拠が増えましたが、予測への有効性は別に検証します。
最初の軽量モデルの全5分割OOFでは、元の幾何特徴に各クラスタ中心までの距離(6列)を追加しても改善せず、この条件では不採用でした。
群ごとの誤差解析には引き続き使います。詳細は後述の「EDAの特徴追加はOOFで改善しなかった」に記載しています。
中心に近い代表分子で仮説を確認
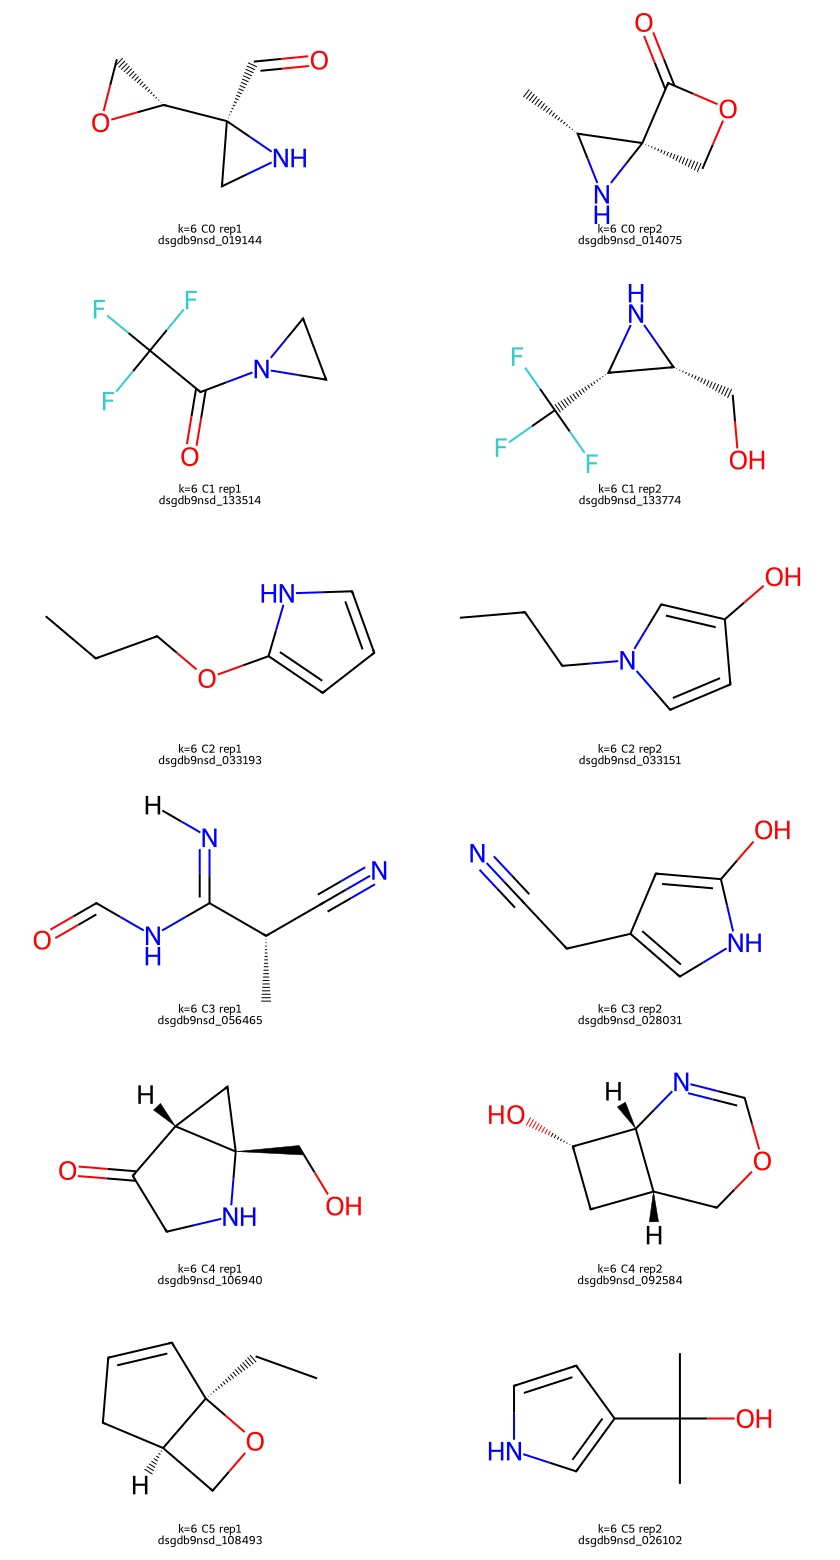
各群の学習分子からクラスタ中心に近い2分子を選びました。図は推定した結合グラフの2次元表示で、実座標をそのまま投影したものではありません。代表例だけで群全体の性質を断定しません。
t-SNE・UMAPで6クラスタの分布を見る
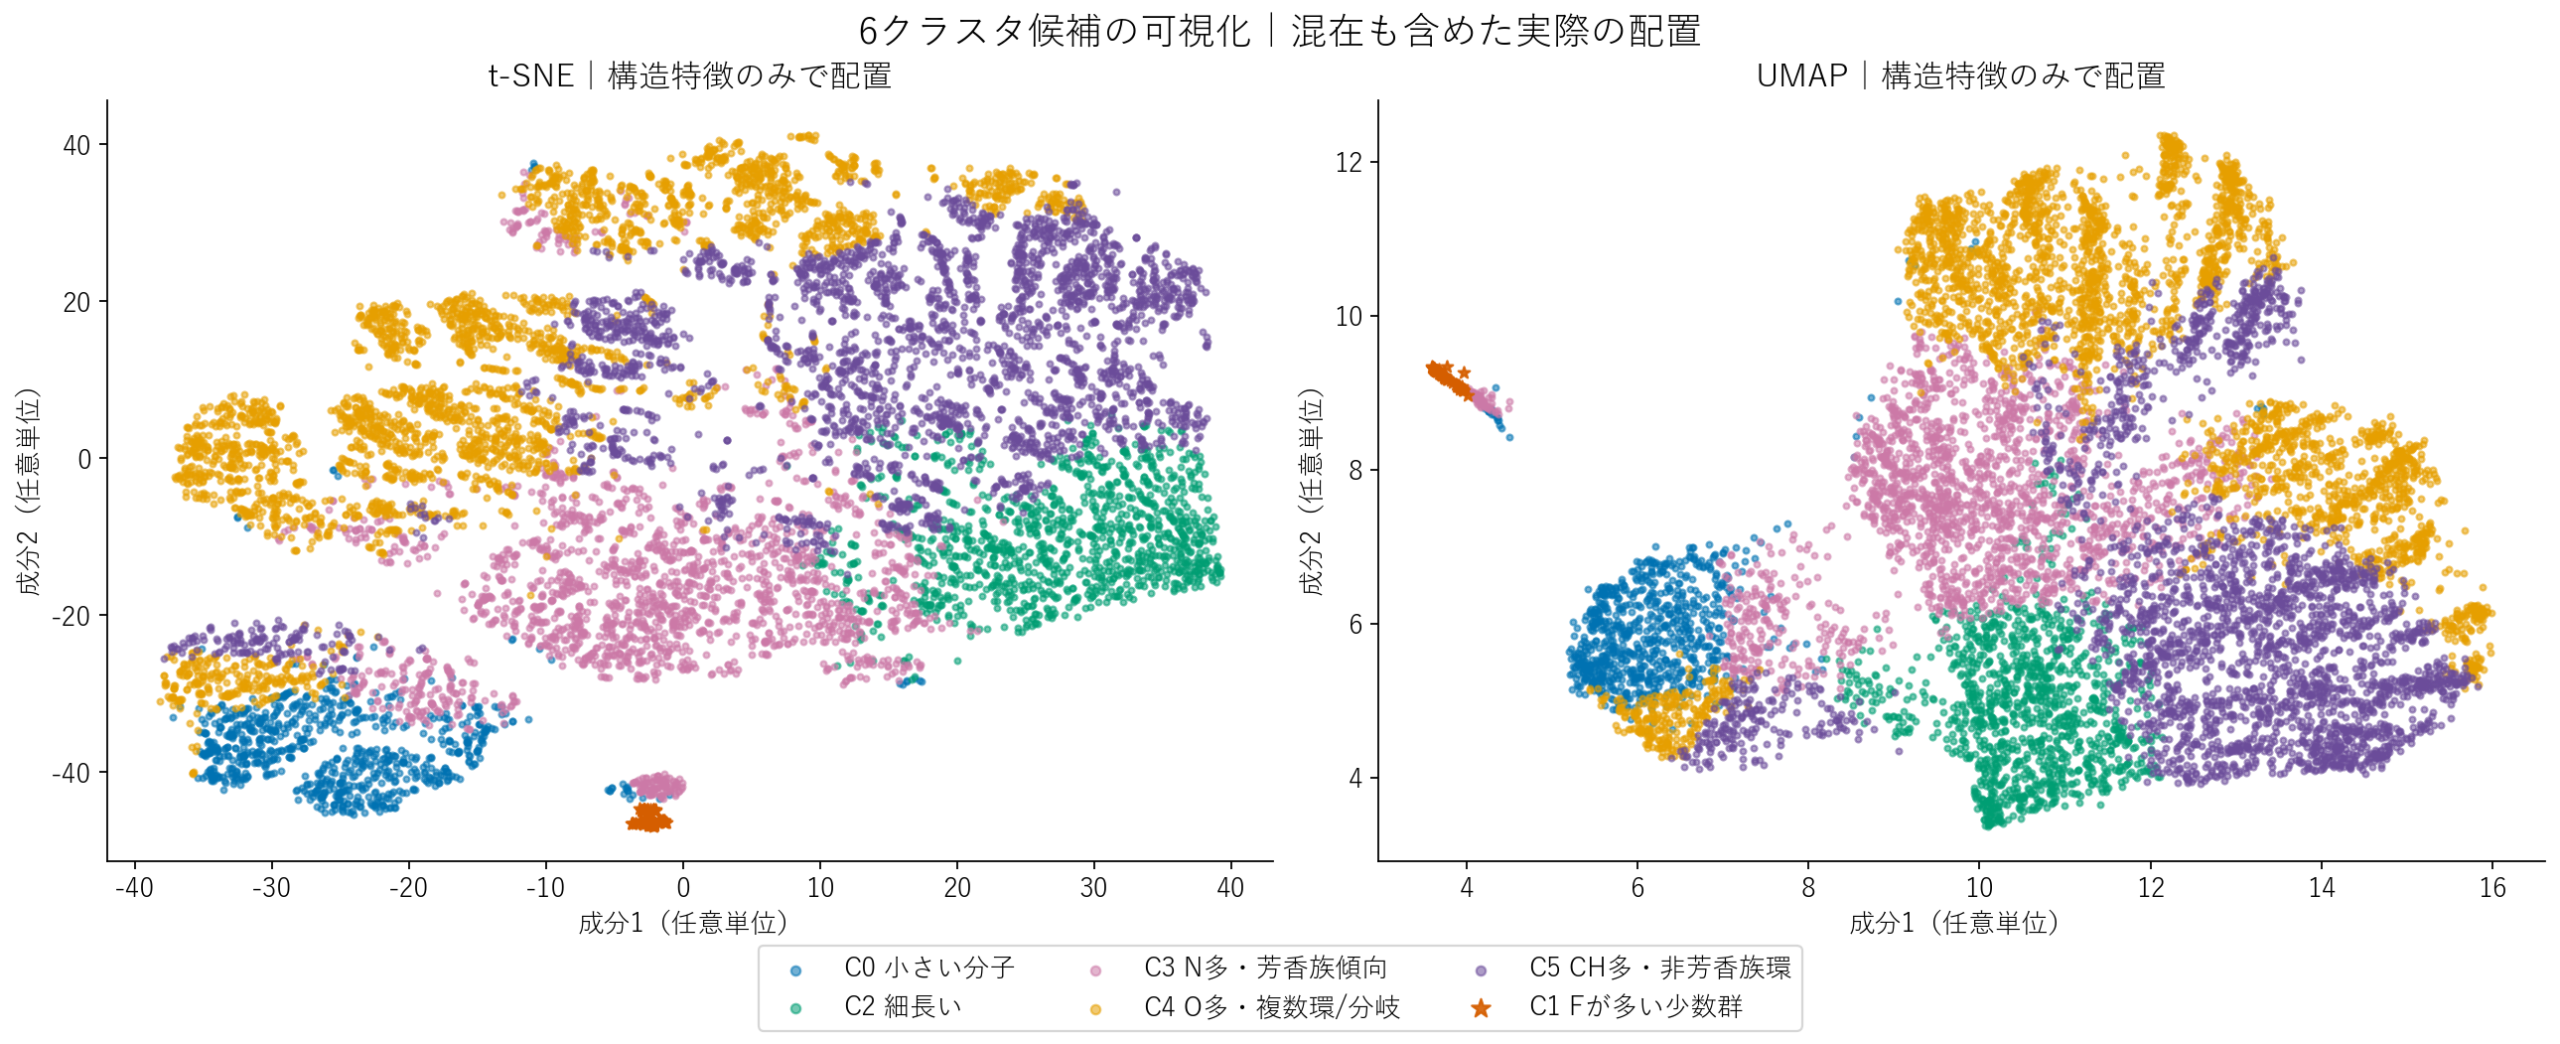
同じ10,000分子(train 6,500・test 3,500)を表示しています。構造特徴だけで配置し、固定したk-meansの群で色を付けています。クラスタ番号やJを配置の入力へ入れず、配置後に点を移動していません。見やすい配色・凡例と、少数群の星形マーカーで読み取りやすくしました。混在する部分はそのまま表示しています。
描画設定を比較し、近傍保持指標が0.95以上の候補の中から、色分けの見分けやすさ(2次元でのシルエット係数)が良い設定を選びました。大きな群の分布を見るため、局所的な近傍保持と見分けやすさのトレードオフを許容しています。この0.95は描画上の基準であり、統計的に確定した閾値ではありません。図を読みやすくするための調整であり、6群の妥当性を独立に検証した結果ではありません。
| 手法 | 選んだ設定 | 近傍保持指標 | 2次元の分離係数 | 設定の詳細 |
|---|---|---|---|---|
| t-SNE | tsne_p200 | 0.978 | 0.138 | {"perplexity": 200, "max_iter": 1200, "learning_rate": "auto", "init": "pca", "seed": 20261024, "fit": "joint train/test inputs; no labels"} |
| UMAP | umap_n200_d0.15 | 0.951 | 0.124 | {"n_neighbors": 200, "min_dist": 0.15, "seed": 20261024, "fit": "train 6500 inputs; test transformed; no labels"} |
近傍保持指標(trustworthiness)は2,000分子標本で近傍数15、分離係数は3,000分子標本で評価しています。trustworthinessは0~1の指標で、1に近いほど元空間の近傍関係を保ちます。t-SNEは表示対象のtrain/test構造を同時に配置、UMAPは表示用train 6,500分子にfitしてtestをtransformしています。島の間隔や面積は、元の特徴空間の距離・存在比をそのまま表しません。
t-SNE:1群ずつ強調して位置を確認
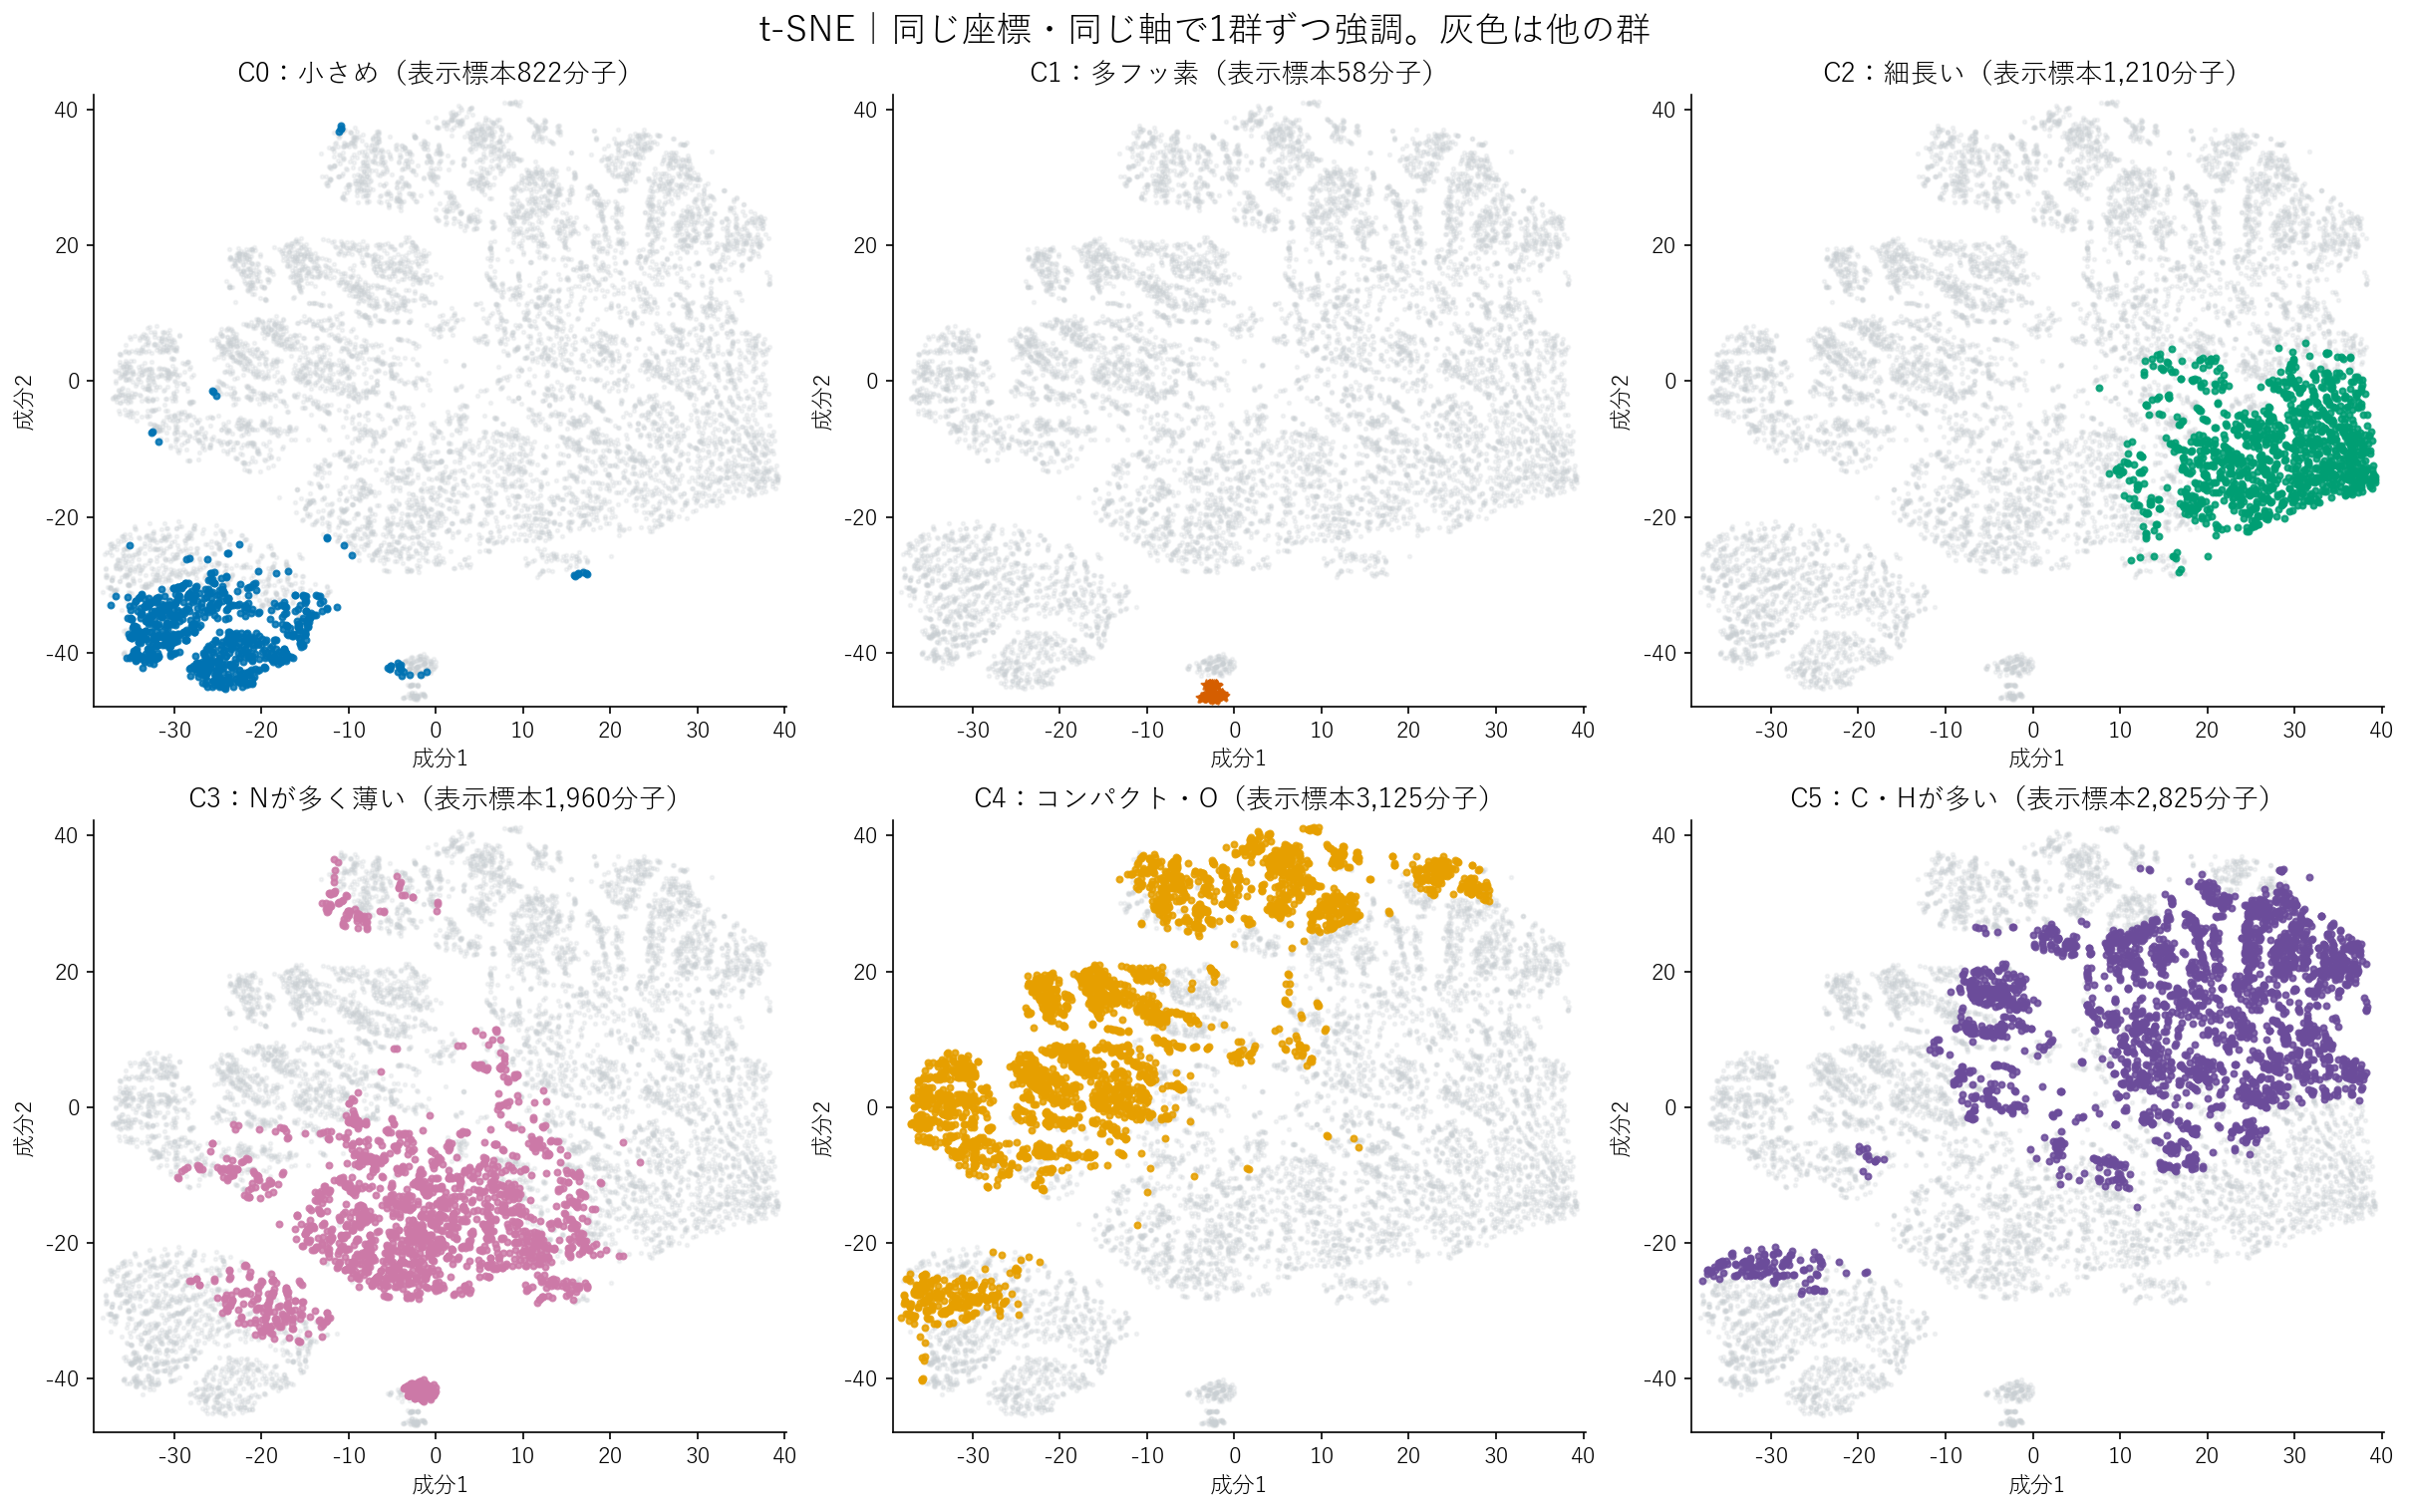
全パネルで同じ座標・同じ軸範囲です。灰色は他の群。色の重なりを減らして各群の広がりを確認しますが、点の位置は変えていません。
UMAP:1群ずつ強調して位置を確認
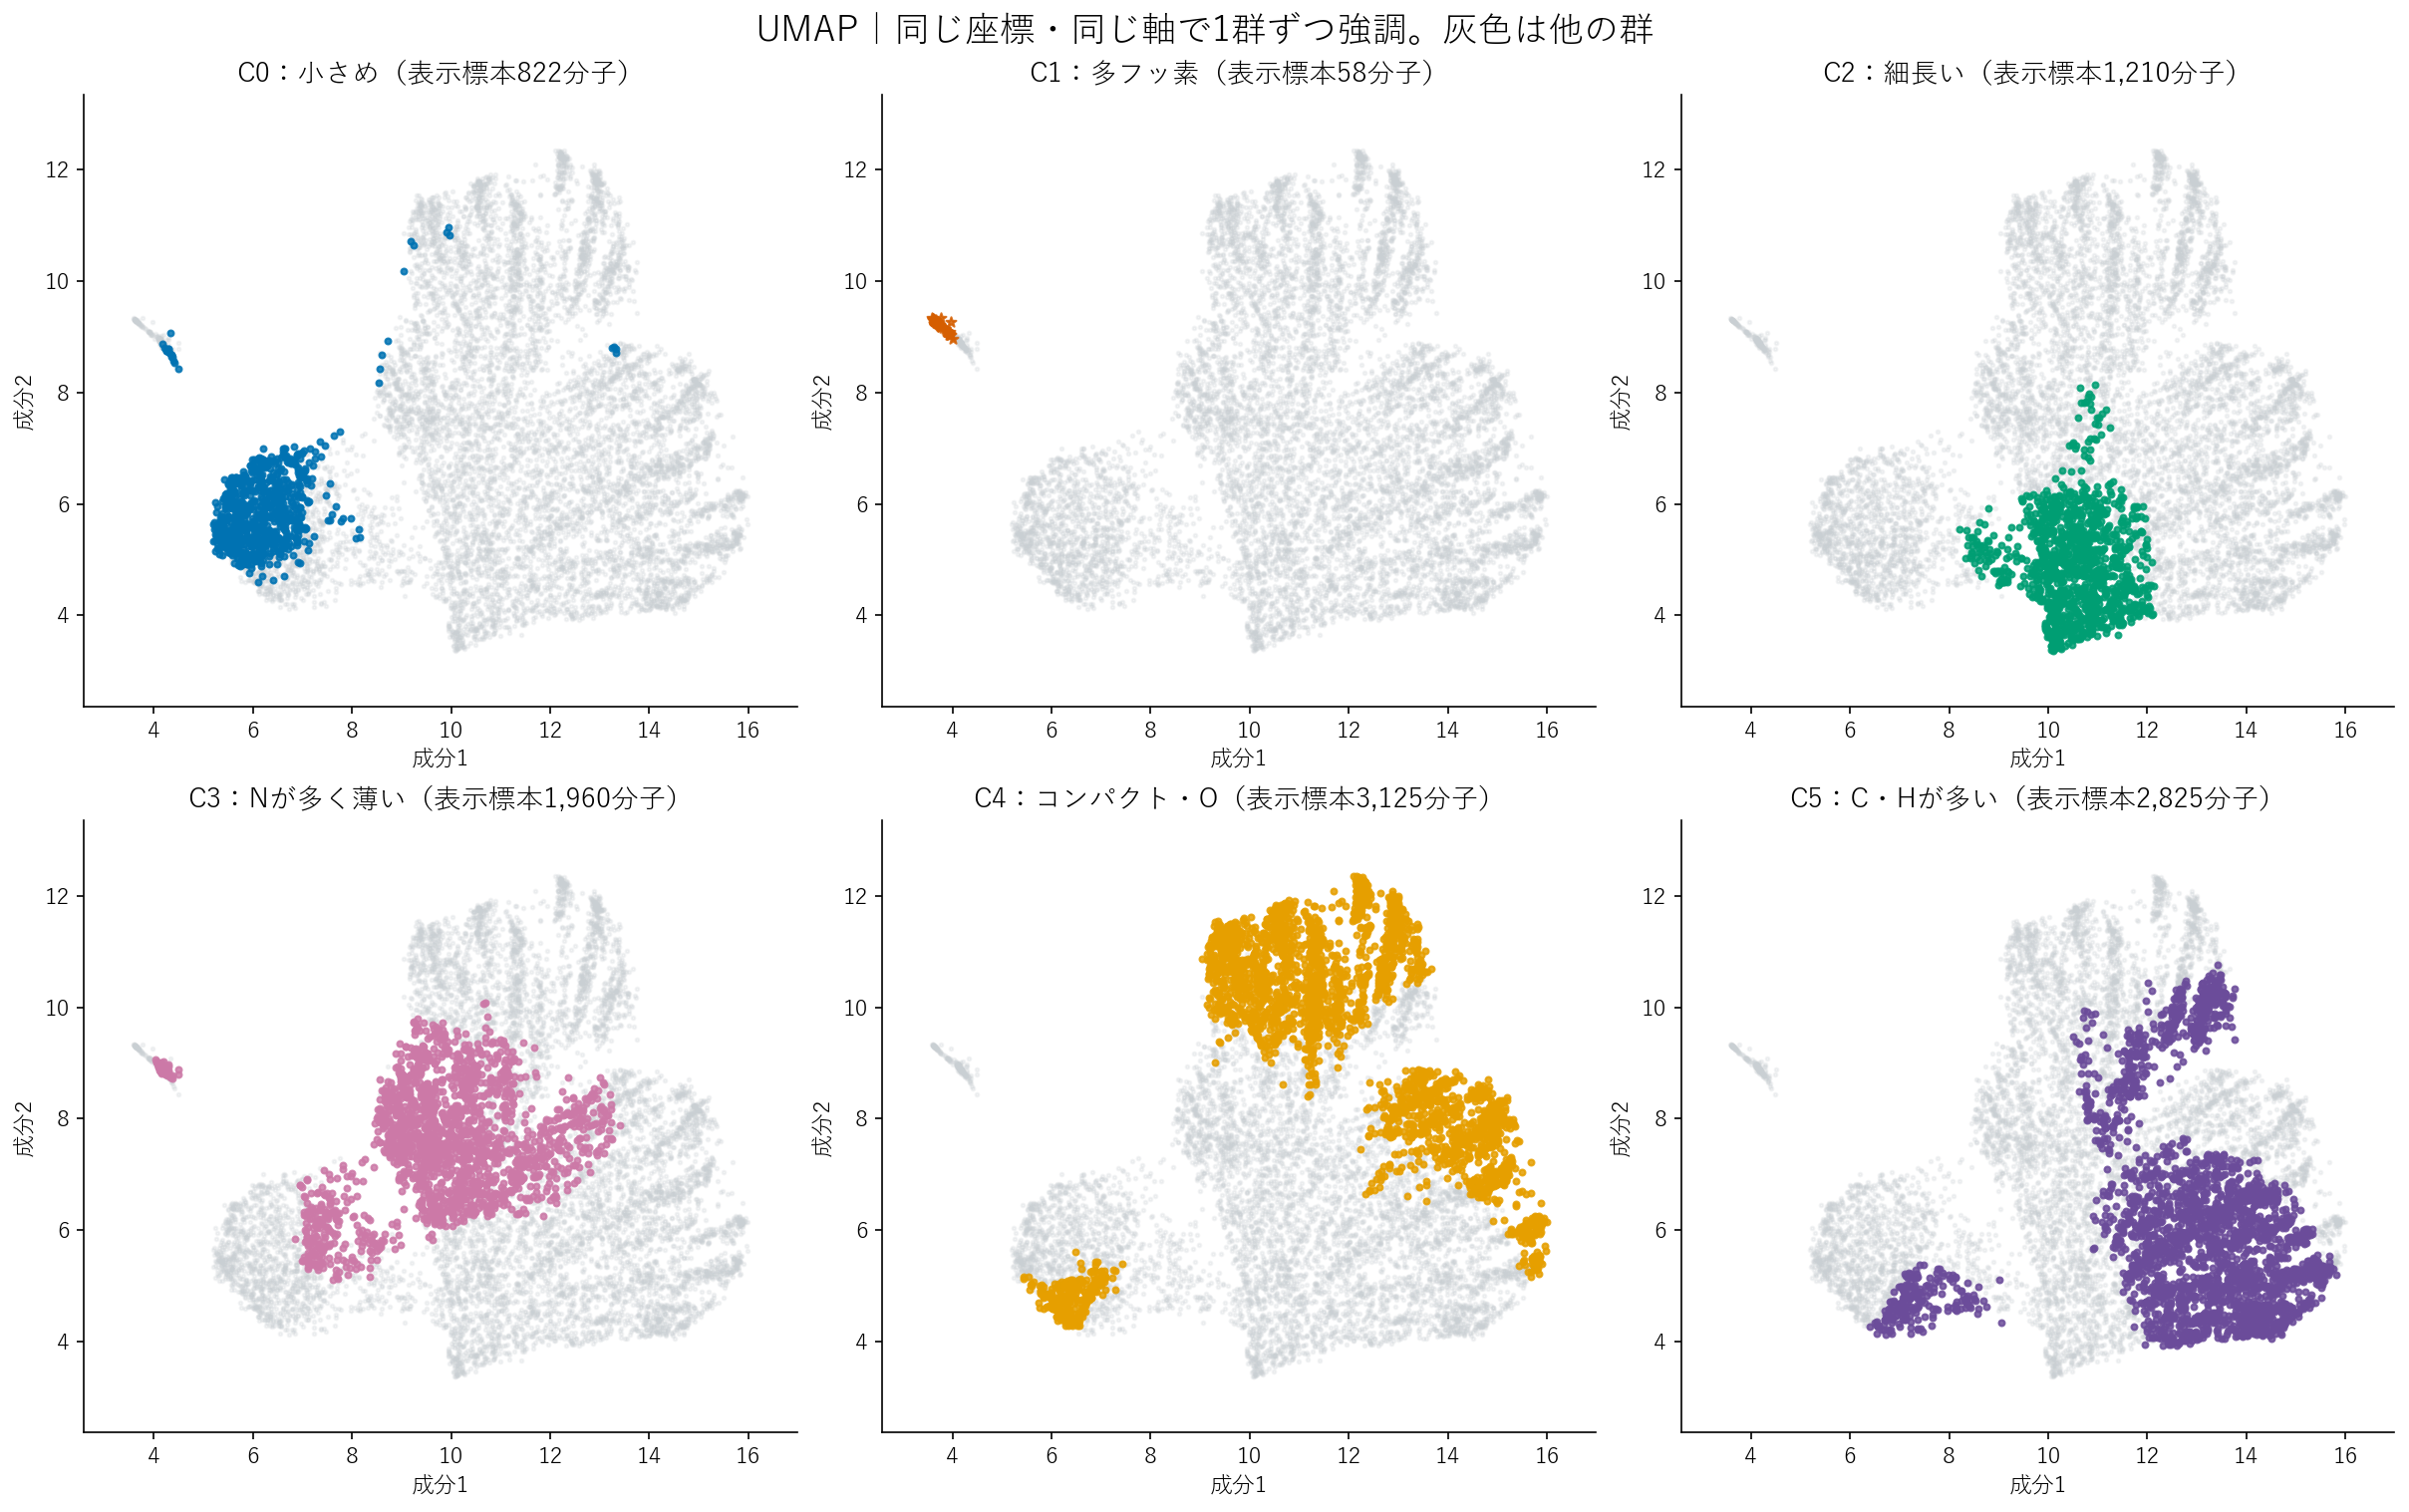
全パネルで同じ座標・同じ軸範囲です。各群が地図の一か所だけにあるとは限らず、同じ群が複数の島に分かれることもあります。
同じ地図をJの分位点で色分けする
この図では、分子平均Jの経験分位順位で色を配分しました。色barは対応するHzを表示しますが、色間隔は非線形です。J値や座標を変更・再fitせず、色だけを調整しています。6500分子の平均Jは約7.48〜79.94Hzで、80%点は約18.92Hzなので、線形配色では大部分が同じ低値色に偏っていました。test3500分子のJは不明のまま灰色です。
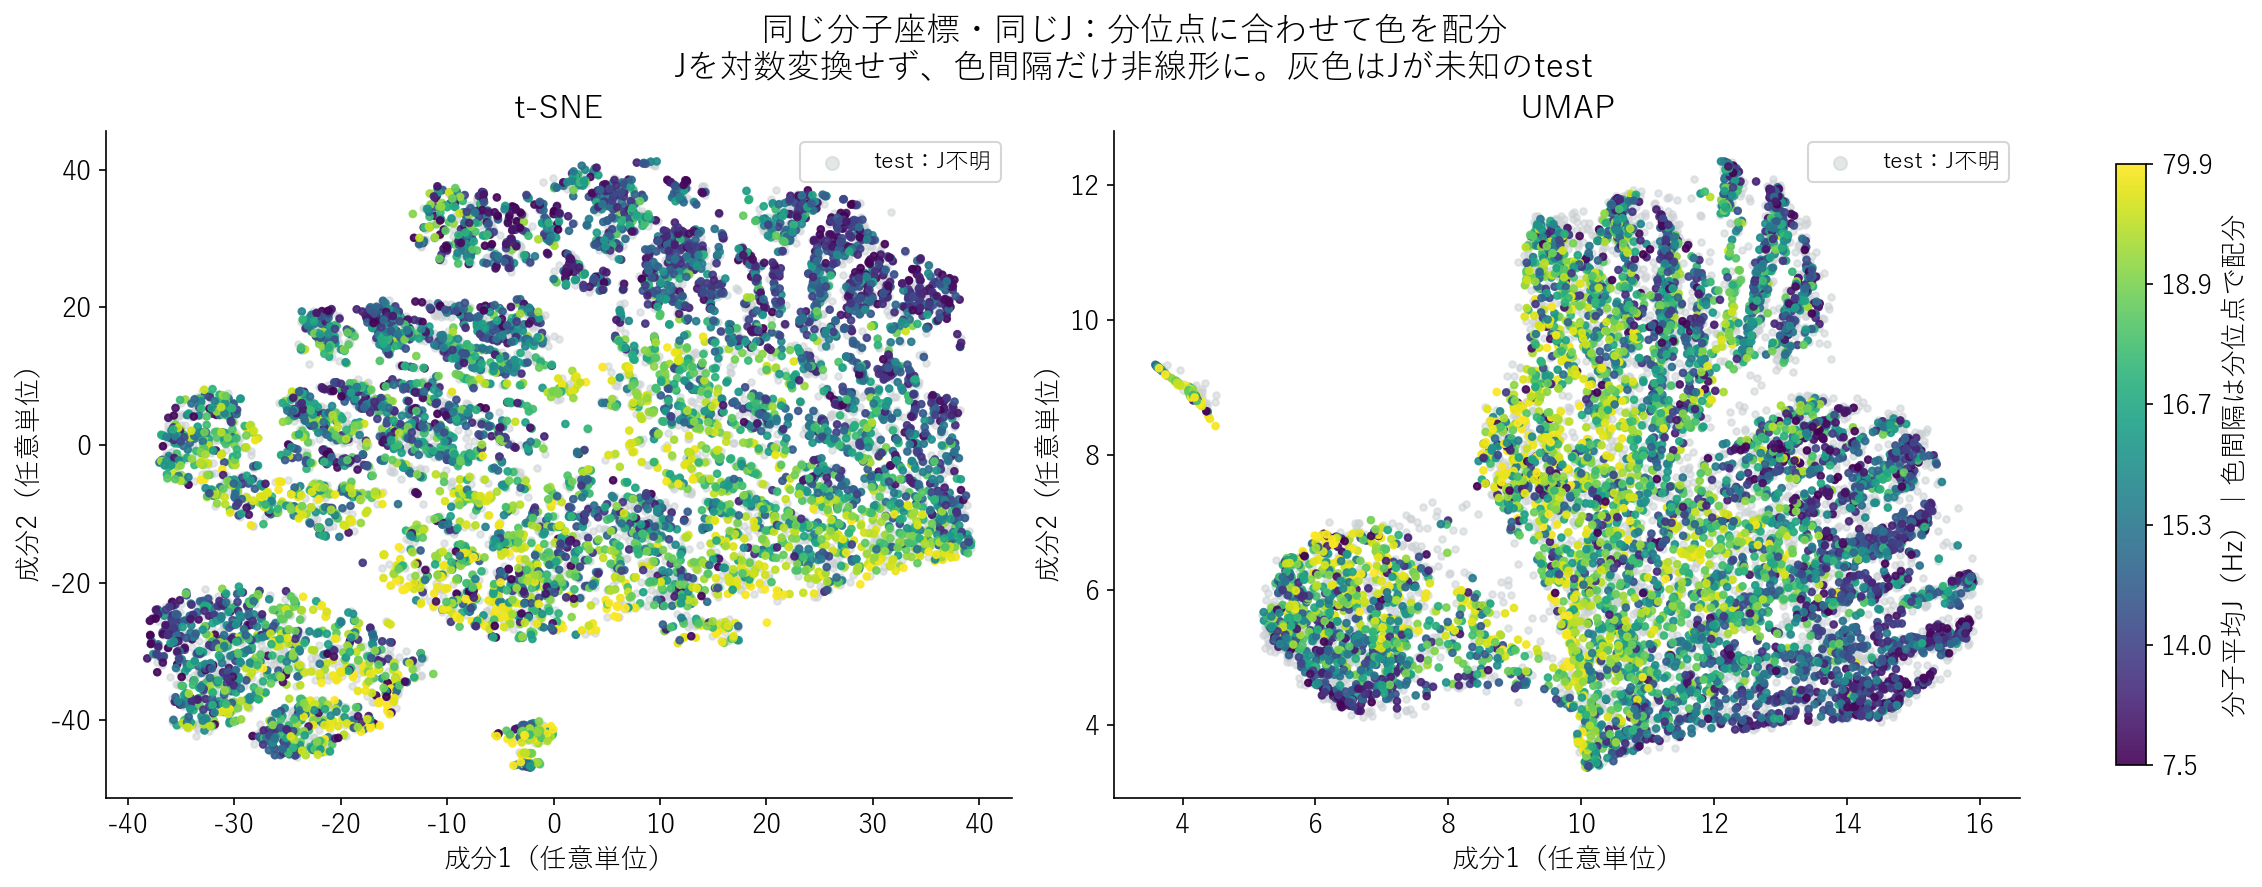
1点は1分子なので、分子内の全原子対の平均Jで色を付けています。分子内の結合タイプ構成でも平均値が変わるため、次のタイプ別図と併読します。
t-SNE:タイプ別のJとの関係
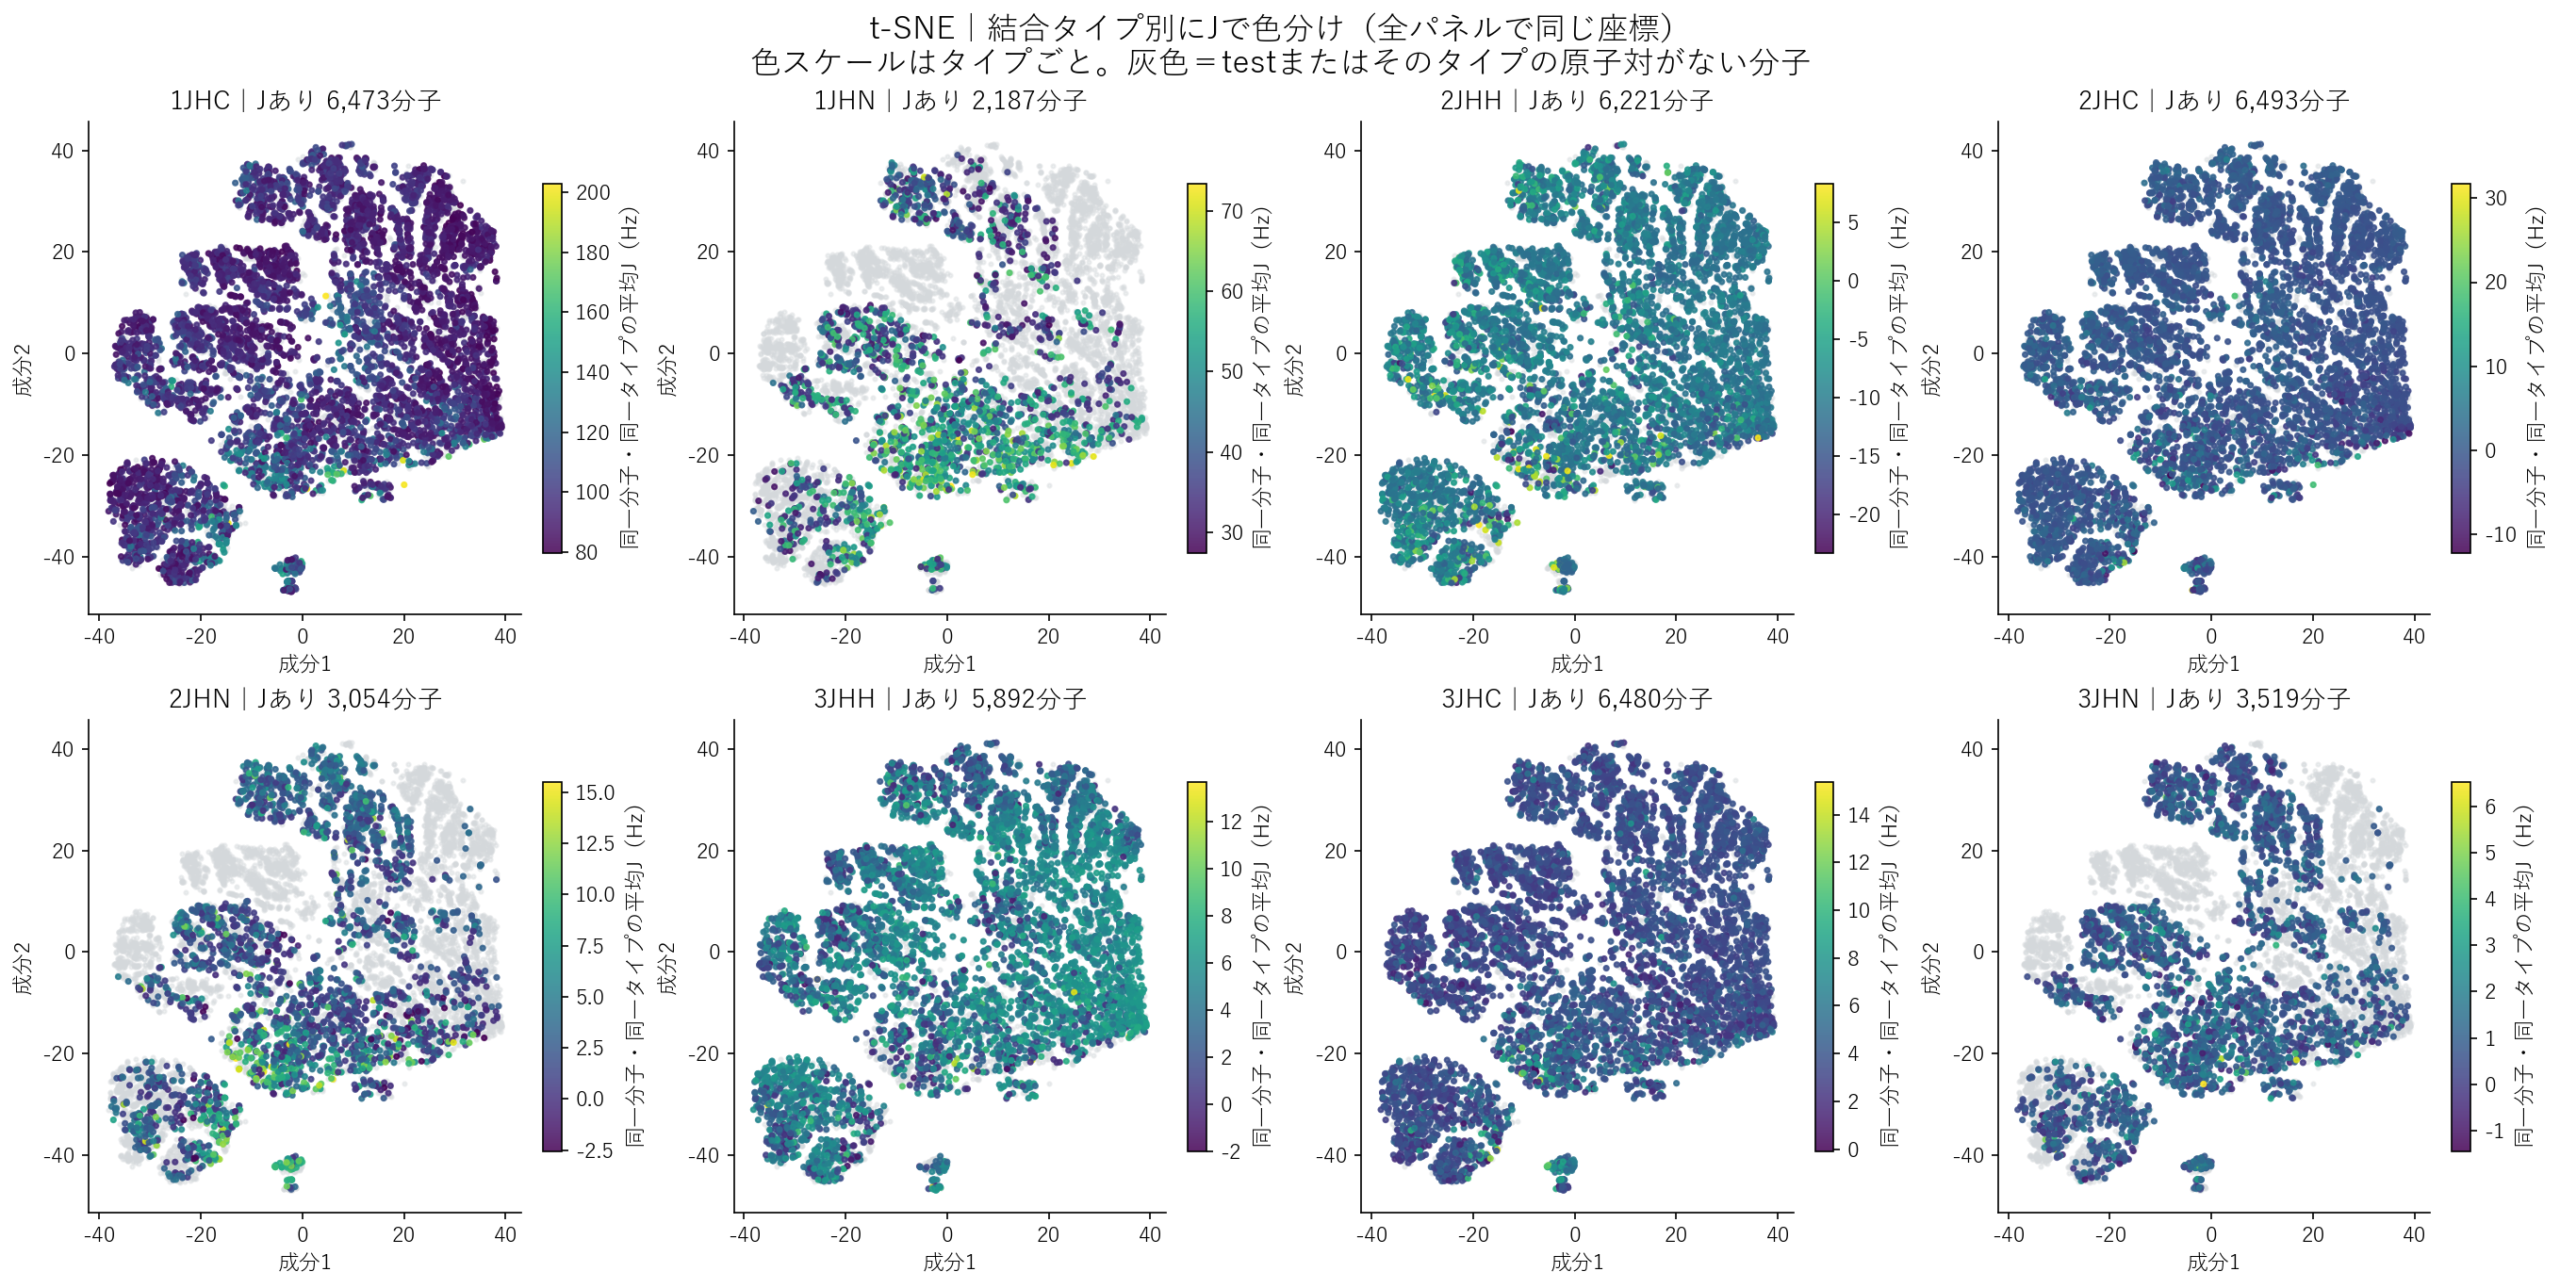
同じ選択済み座標で、同一分子・同一タイプの平均Jを表示します。タイプごとに色スケールが異なります。灰色はtest、またはそのタイプの対象原子対がない分子です。
UMAP:タイプ別のJとの関係
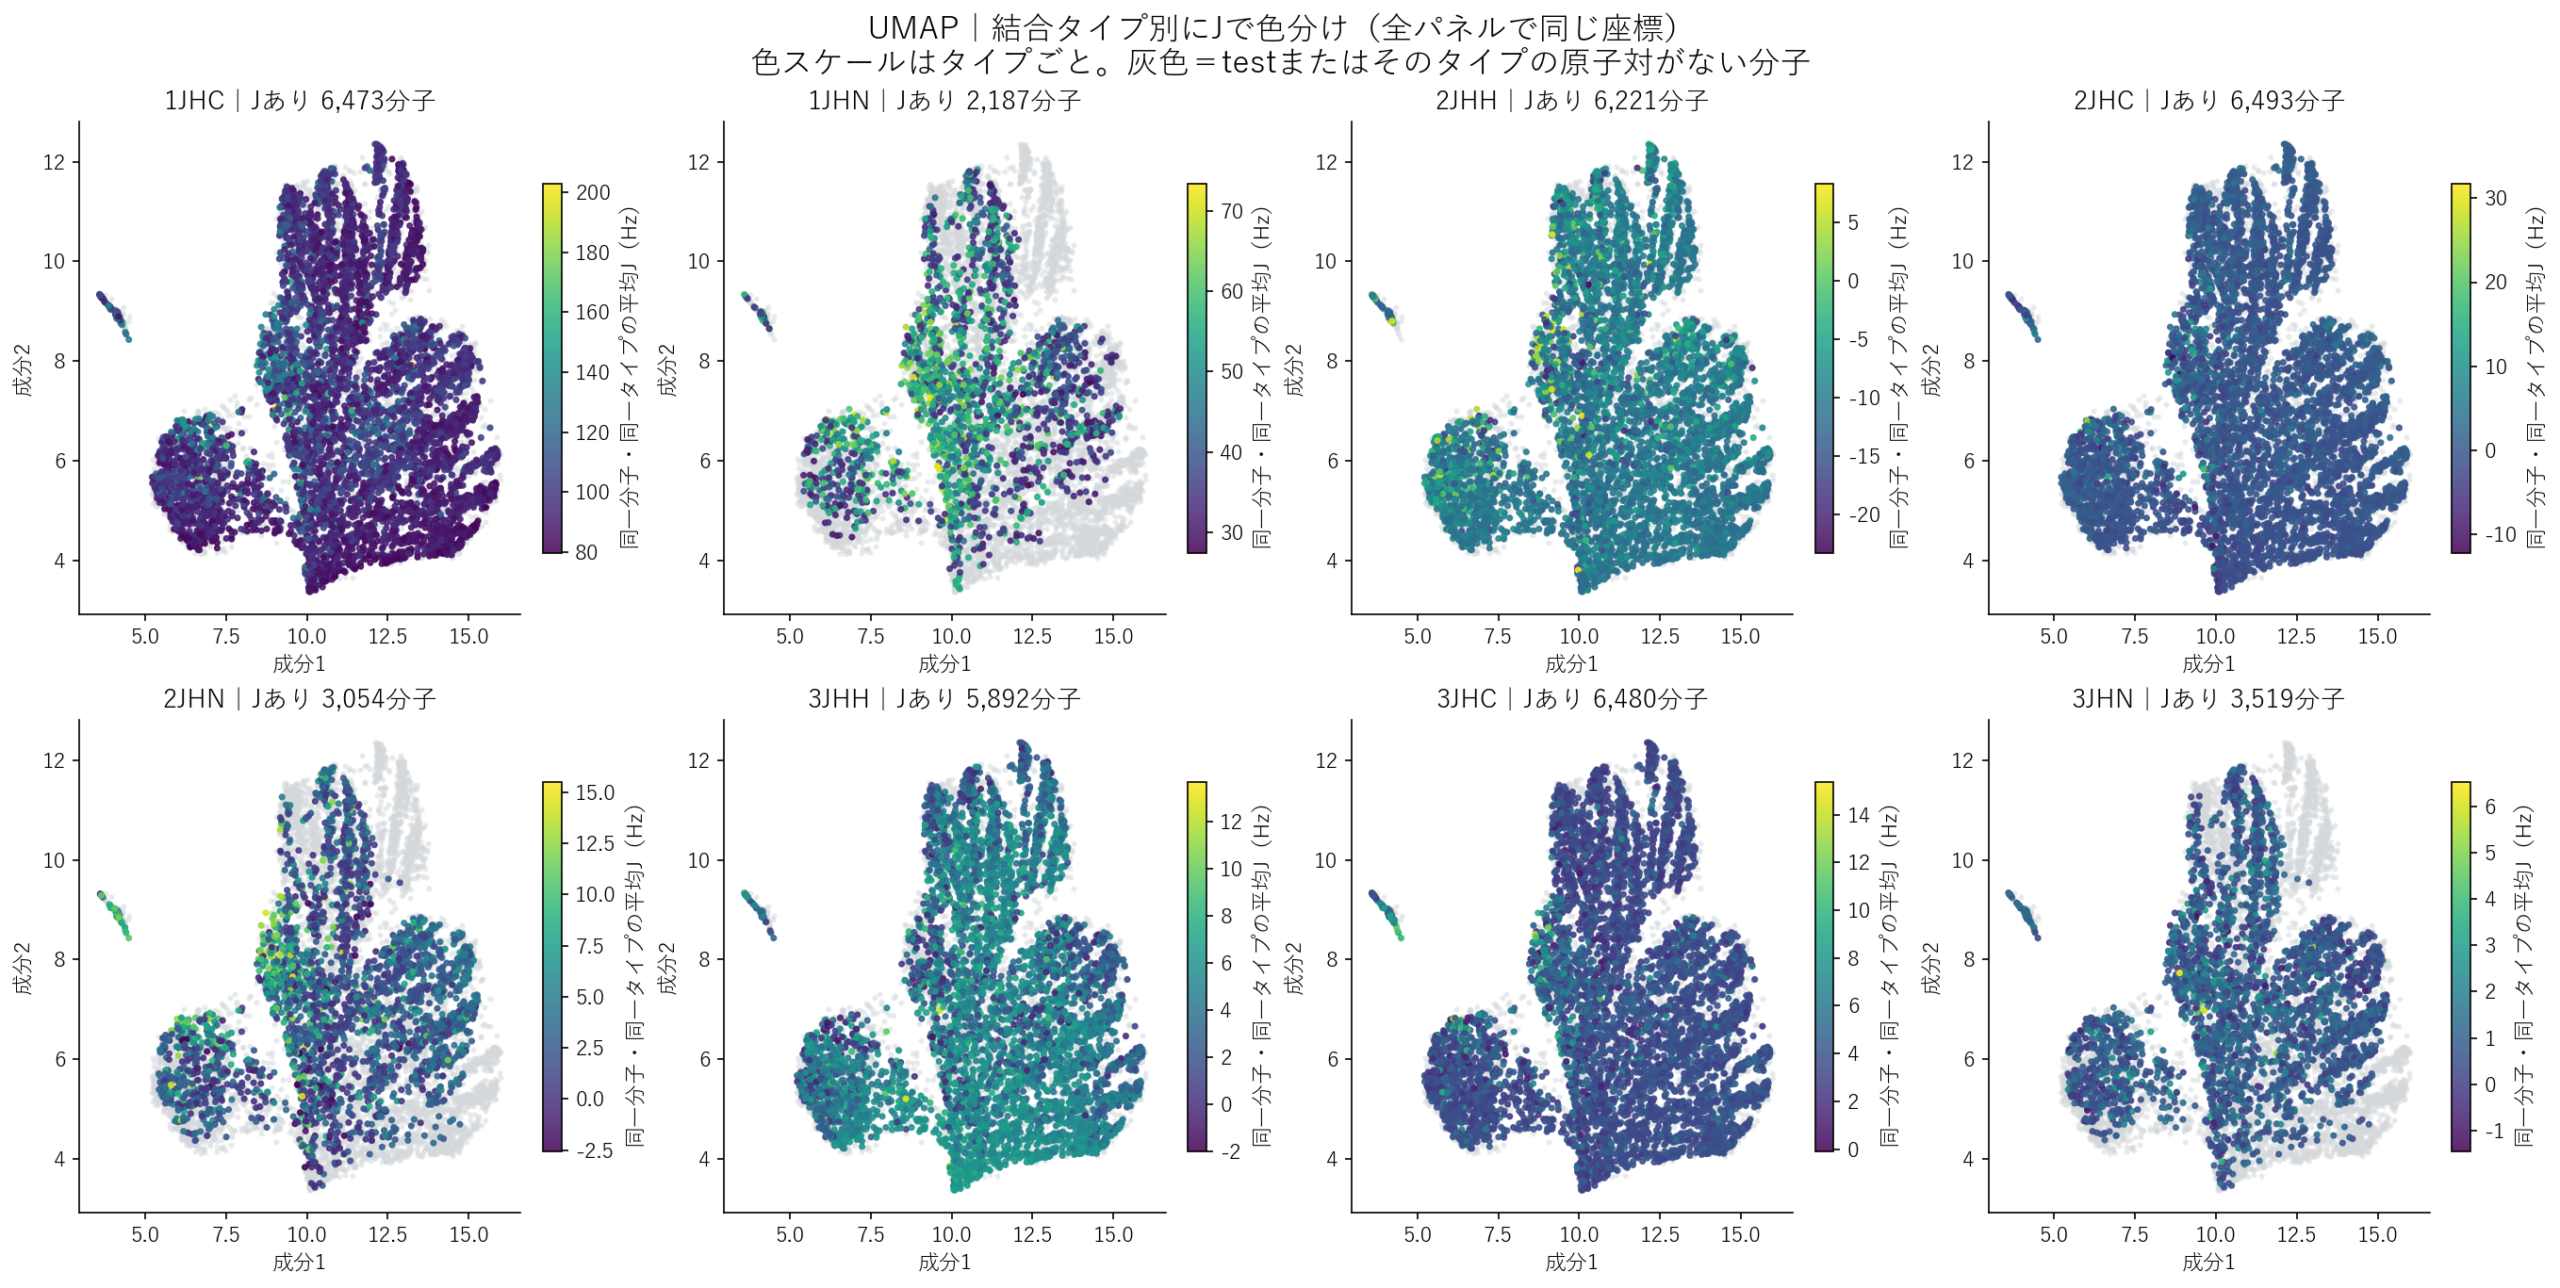
配置にJを使っていません。色の偏りは予測へ向けた仮説の手掛かりで、予測精度の実証ではありません。
クラスタごとのタイプ内Jの偏り
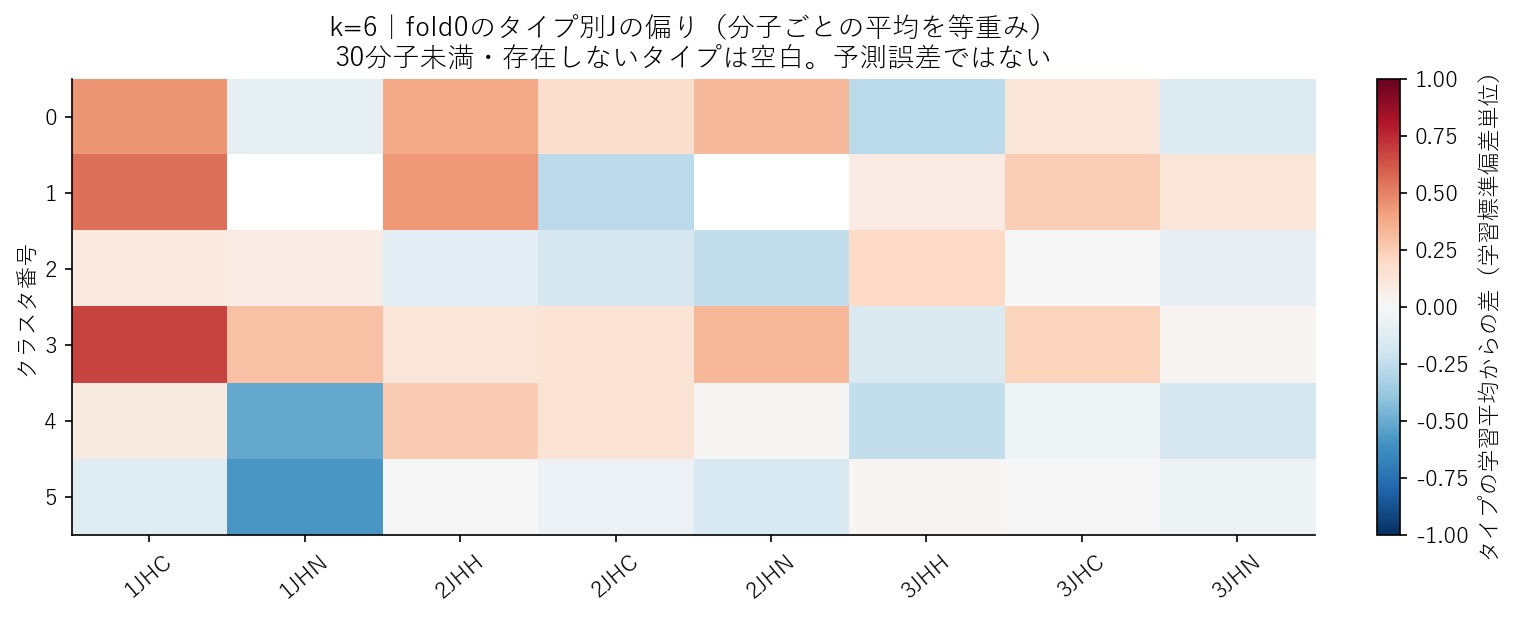
fold0の分子ごと・タイプごとの平均Jを等重みで集計しました。タイプの学習平均と標準偏差で標準化し、30分子未満のセルは表示していません。これは目的変数の偏りで、予測誤差の図ではありません。
今後の予測へつなげる仮説
まず、6つの中心までの距離と、形・元素組成の連続特徴を、分子全体の文脈として試す価値があります。
さらに、N/O/Fの個数だけでなく対象原子からの結合経路距離、環・芳香族・分岐、角度・二面角を調べます。
Fが多い少数群は、独立したモデルへ分けるより、共有モデルの特徴や層別誤差解析に使うことを優先します。
クラスタは元の15特徴から作った再表現なので、新しい情報やスコア改善が自動的に加わるわけではありません。
各foldの学習側だけでscaler・k-meansをfitしてOOF特徴を作り、追加したときのタイプ別MAEと公式指標を比較して採否を決めます。
Jの谷の群番号はtestでは正解Jがないので、そのまま予測器の入力へ入れません。
分子モデルの推論アルゴリズム
共通:文章生成ではなく、教師ありの数値回帰
旧trainの既知のJを使ってパラメータを学習し、testでは元素・座標・指定した原子対などからJを出力します。分子全体へ1個のJを出すモデルではありません。量子化学計算をそのまま解いているわけでも、LLMが説明文からJを作文しているわけでもありません。
Graph TransformerとGNNの関係
広い意味ではGraph Transformerは、グラフを扱うニューラルネットワークの仲間です。厳密な分類では、近傍の情報を集約するmessage-passing GNN(MPNN)と、広域のattentionを使うGraph Transformerを区別することもあります。
代表的なGCN・GraphSAGE・GAT単体は今回実装していません。一方、TensorNetは3次元の幾何情報を扱うGNNの仲間として実施しているので、「GNNは未使用」と説明しません。すべてのGNNが近傍1回の処理だけ、すべてのGraph Transformerが完全接続、という一般化もしません。
一般的な位置づけ:GraphGPS論文。この文献を説明に使うことと、今回GraphGPSを学習したことは別です。
第1段階:Bosch Graph Transformer
元素・座標 → 前処理で原子/原子対/三原子組を作る → 埋め込み → attentionとFFNを反復 → 原子対別の回帰出力 → J [Hz]
- 分子を数値表現へ変換します。 原子の元素・周囲のラベル、原子対の種類・距離、三原子組の角度などを使います。部分電荷などの派生量も前処理に含まれます。これは今回の構造6クラスタを入力する処理とは別です。
- 分子内から情報を集めます。 attentionは、現在の特徴どうしの関連度と、距離などの関係情報を使って集約の重みを計算します。「どの情報をどの程度取り込むか」を学習する仕組みとして説明できます。ただし、重みそのものを化学的因果の証明とはしません。
- 表現を更新します。 重み付き集約と小さな全結合ネットワーク(FFN)を繰り返し、対象原子対の周囲を表す特徴を更新します。モデルAは10層です。文章の前後関係を使うのではなく、分子の関係を使います。
- Jを数値として出します。 原子対の種類に対応する回帰出力を選び、学習時のスケールを戻してHz単位のJを得ます。分類ラベルや文章を生成する処理ではありません。
モデルAは原子・原子対・三原子組を扱い、四原子組は使いません。公開A〜Mの一部には四原子組を扱うものもあります。原子対は、通常の化学結合だけを意味しません。コンペの対象には複数結合を隔てた原子対も含まれます。
13本は別の分子を予測しているのではありません。 同じ旧testへ各モデルが予測を出し、タイプごとに原本の9本を選び、各原子対の中央5予測を平均します。各モデル内のattentionと、モデル間のensembleは別の操作です。
実装出典:Bosch公式コード(使用した版の識別情報は配布ZIPに記録)。対応ファイルは models/model_A/graph_transformer.py の GraphLayer.forward と GraphTransformer.forward、集約は src/predictor.py。
第2段階:TensorNetと原子対の方向読み出し
元素・座標 → 近傍原子との幾何学的な情報交換 → 原子ごとのテンソル表現 → 指定原子対に沿って情報を取り出す → 小さな回帰ネットワーク → J [Hz]
TensorNetは、分子を回転すると内部の方向表現も対応して変わるように扱います。最終的に欲しいJは分子全体の向きに依存しない数値なので、最後は回転に依存しない量へまとめます。今回の実装ではTensorNetの3×3のテンソル表現を、対象原子対の単位方向ベクトルに沿って縮約し、両端の情報や距離・タイプ表現と合わせてJを出しました。
技術的な補足:両端のテンソルXに対する uᵀXu、両端テンソルの要素積の和、両端の原子特徴の和・差の絶対値・要素積などを組み合わせます。分子全体を回転・平行移動する検査、鏡映、原子対の端点を入れ替える検査を実分子入力で行いました。数値誤差の許容範囲で不変性を確認しています。
初期モデルは幅64、方向読み出しを追加した比較、その後は幅128を試しました。幅は内部の特徴チャネル数で、原子数でもクラスタ数でもありません。今回のTensorNetは2層です。元のTensorNetをCHAMPS原子対回帰へ適応した実装であり、モデル名だけで精度が上がるとみなしません。
実装根拠:固定TorchMD-Net2.6.2のTensorNetと、今回の tensornet_pair.py、tensornet_pair_directional.py、tensornet_pair_wide.py。MACEは未実施です。
図にするときの注意
- 化学結合の棒と、情報の流れを示す点線・光の線を区別します。
- attentionの線は実測された電子の流れではありません。生成CGは概念図と明記します。
- 化学結合を無制限に増やした炭素や、実測値を装うJを描きません。
- モデル内の推論と、13モデルの予測を組み合わせるensembleを混同しません。
公開重みは、誰がどこで何のために公開したのか
配布元はBosch Researchの公式リポジトリ BCAI_kaggle_CHAMPSです。2019年の優勝チームhybridの解法を再現するため、前処理・モデル別コード・設定・集約処理と、学習済みモデルの取得手順が公開されています。作者READMEの「解法を再現する手順」という説明に基づく目的であり、公開義務や商用配布の意図までは推測しません。
get_saved_models.shはA〜MのGoogle Drive配布先を指定します。「A」は優勝解法全体の名前ではなく13本のうち1本の識別名です。READMEには①保存済み予測を集約、②公開checkpointから推論して集約、③ゼロから学習、の3経路があり、今回は②をRTX3060で実行しました。取得済みコードは、再現に使った版を固定して保存しています。モデル別の対応コードでstrict互換監査を行い、元のモデル順・タイプ別9本選択・中央5本平均を再生しました。
作者のモデル概要によれば、最終13モデルは全学習データで訓練されています。この重みを使って今回の学習データへ予測しても、分子が未見の自前OOF予測にはなりません。公開重みの再生、自前の学習・検証、全モデルの再学習は明確に分けます。
解法と実験結果
以下は実施した解法と確定結果の詳細です。固定20対100epoch、続く追加20epochの学習率比較は完了しました。低いスコアほど良く、異なる評価方法の数値を混ぜて順位づけしません。
LightGBMで特徴量を段階的に検証する
LightGBMは特徴量の寄与を調べるため、分子単位の固定5fold・タイプ別300木で使用しました。条件を固定した軽量な比較であり、LightGBMを最高性能まで調整した実験ではありません。
| 累積して入力する特徴 | 完全5fold OOFスコア |
|---|---|
| 原子対の距離だけ | +0.716809 |
| + 周辺の幾何情報 | −0.163717 |
| + 元素組成 | −0.179634 |
| + 分子全体の形状 | −0.180087 |
周辺の構造情報は有益でした。一方、全体形状の追加による差はごく小さく、不確実性も踏まえて解釈します。「EDAの特徴はすべて無意味」という結果ではありません。TabPFNは今回未実施で、テーブル系モデル全体の限界を測ったとも言えません。
EDAの特徴追加はOOFで改善しなかった
LightGBMの完全5fold OOFでは、上表の4段階すべての特徴(距離・周辺幾何・元素組成・分子形状)を含む基準のスコアが−0.180087057、これに各クラスタ中心までの距離(6列)を追加すると−0.179597868でした。差は+0.000489189で、この条件では不採用です。
EDAの6クラスタ案そのものは、構造の仮説整理やタイプ×クラスタの残差分析に使っています。「6クラスタ案はすべて不採用」ではありません。各foldの学習分子だけで前処理・クラスタをfitし、化学的な意味づけと予測効果を別々に評価します。J分布を谷で分けた6群は構造クラスタの正解ラベルではありません。
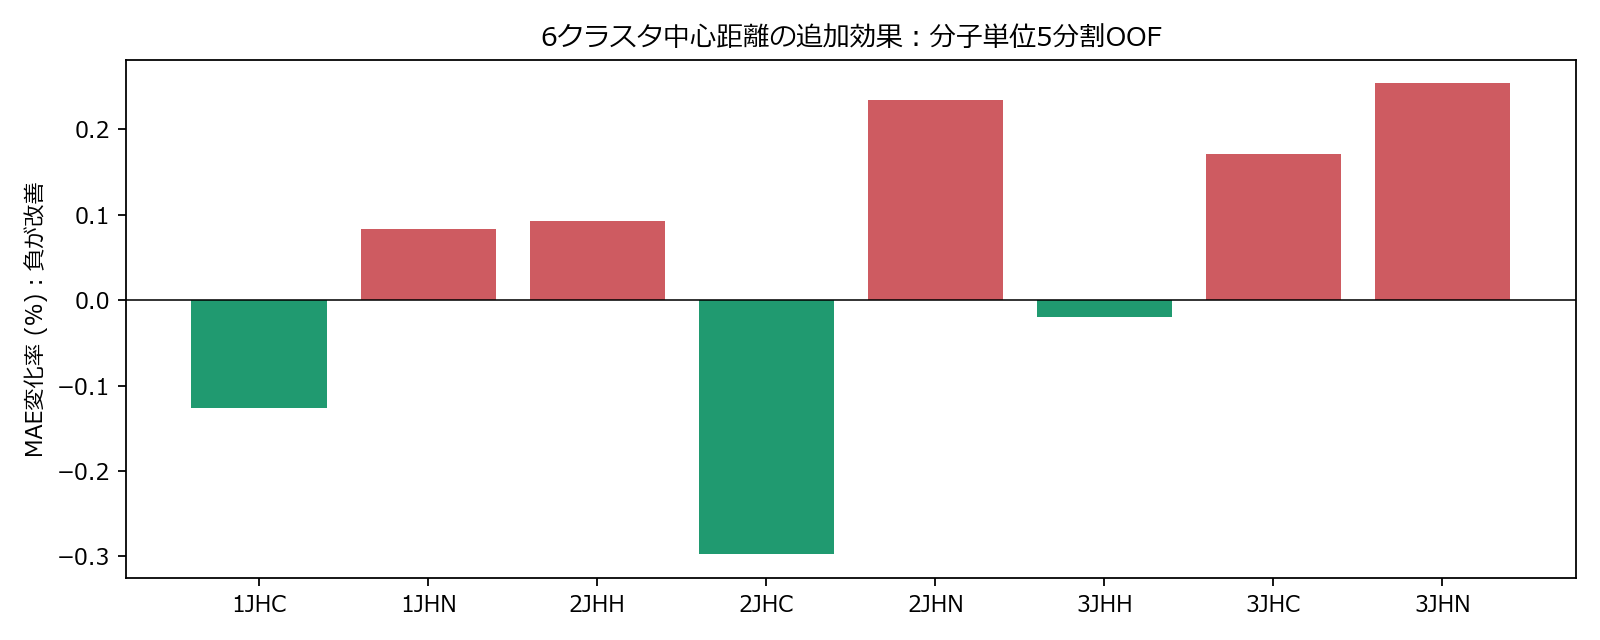
クラスタリングは既存特徴の再表現です。解釈しやすい群ができても、新しい情報が増えるとは限りません。一方、この6群は後のモデルで「どの構造に誤差が残るか」を調べる用途に使えました。
第1段階:公開13モデルのKaggle参照結果
| 対象 | Public | Private |
|---|---|---|
| 公開モデルA単体 | −3.01545 | −3.00370 |
| 公開A〜M・公式集約 | −3.23528 | −3.22754 |
| 歴史首位hybrid | — | −3.23968 |
A単体の提出IDは57613469、13本集約は57657490です。13本集約は2026年10月26日15:56に採点結果を取得しました。歴史首位の値は、筆者が確認したPrivate leaderboard画像によります。同じPrivate列での差は+0.01214、8タイプMAEの幾何平均比に換算すると約1.0122倍です。これは全行の算術平均MAEの比やタイプごとの比ではありません。
確認した歴史Private上位表では、首位−3.23968と2位−3.22349の間に相当する値です。Late採点の参照比較であり、当時の参加順位や入賞を取得したという意味ではありません。筆者としては、RTX3060での公開重み再生として合格点と考えています。歴史首位との完全一致・全再学習・自前OOFは達成と呼びません。
13モデルは全部必要?
原本の公式集約では、A〜Mの13本から結合タイプごとに9本を選び、各原子対の予測を並べた中央5本を平均します。タイプごとに組み合わせが異なるため、公式手順全体の再生には13本の予測を使います。各成分を6桁小数へ丸める処理も再現しました。モデル名の原本順とA〜Mのアルファベット順は異なるので、対応表も検査しています。
全13本を旧test2,505,542行へ適用し、行数・ID一意性・旧sampleの順序・有限値・hashを確認しました。別経路で公式maskから集約を再計算した最大絶対差は5.684×10⁻¹⁴でした。候補hashを凍結してから、許可された1回を提出しました。公開Aの既存参照との微小な数値差も記録し、ビット同一の予測とは主張しません。スコアを見てモデル選択や集約重みを調整していません。
誤差分析から学習率の対照比較へ
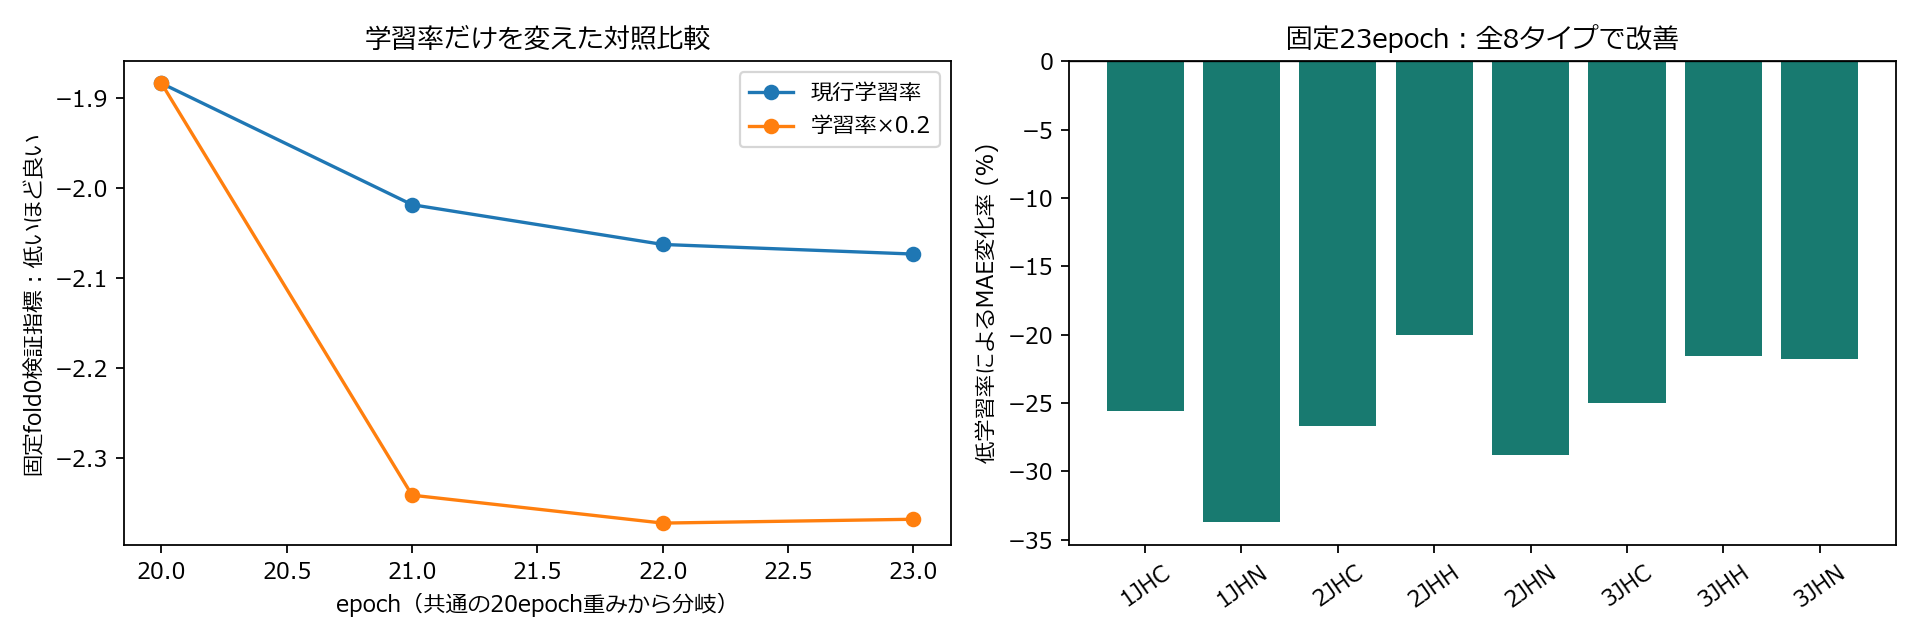
自前2019系では途中epochで構造群×タイプのbiasが変化しました。そこで固定補正を急がず、同じ20epoch checkpoint・optimizer・乱数状態から、現行scheduleと学習率1/5で各3epoch追加しました。
| 23epoch終了時 | スコア |
|---|---|
| 現行学習率 | −2.073714108 |
| 学習率1/5 | −2.368255747 |
差は−0.294541639。対応あり分子bootstrap1000回の95%区間は[−0.299624744,−0.289025750]で、全8タイプ・48セルでMAEが改善しました。同じ監視fold0での単一seed探索結果であり、別foldや完全OOFでの確認は未実施です。区間は再学習や条件選択すべての不確実性を含みません。
第2段階:方向情報と幅の効果
公式TorchMD-Net 2.6.2のTensorNetバックボーンへCHAMPS用の原子対読み出しを実装しました。TensorNetは現代モデルの小型ベースラインとして用いており、2026年の最新技術全体の代表ではありません。2層、batch32、学習率0.0005、FP32、同じ分子fold・seedで固定20epochを比較しました。
| モデル | 探索fold0 | 確認fold1 | fold0学習・検証・保存 |
|---|---|---|---|
| 初期64 | −1.164366 | −1.180464 | 40.6分 |
| 方向64 | −1.493998 | −1.437380 | 41.8分 |
| 方向128 | −1.672117 | −1.712256 | 67.9分 |
原子ごとのスカラー要約だけでは原子対方向の情報を失う可能性を考え、原子対に沿ったrank2テンソル縮約を読み出しに加えました。その後、学習小標本と検証誤差が近いことを手がかりに、幅だけ64から128へ変更しました。
fold1の確認条件は結果を見る前に固定しました。このfold1での方向情報追加の差は−0.256916、分子bootstrap95%区間[−0.261448,−0.252033]、全8タイプと47/48セルでMAEが改善。幅拡大の差は−0.274876、区間[−0.279560,−0.270209]、全8タイプと46/48セルで改善しました。検証は17,001分子・928,633原子対です。
EDAの6群は、改善が一部の構造だけに偏っていないかを調べる誤差診断として役立ちました。 クラスタ特徴自体による改善とは区別します。単一seed・2foldの確認で、完全5fold OOFではありません。自前2019系のスコアにはまだ届いていません。
第三原子の追加は不採用
幅128方向モデルに第三原子との距離・角度を使う補正枝だけを追加しました。固定20epochの主比較は−1.672117から−1.668034で、差+0.004083。分子bootstrap95%区間は[−0.000168,+0.008639]です。3JHCのMAEは14.25%減る一方、1JHNは25.32%増えました。
全体改善の根拠を得られなかったため不採用としました。最良epochの値を取り出して主要比較の結論を置き換えません。化学的に自然な追加でも全体の精度を上げるとは限らない、という負例です。
比較条件の注意:自前2019系との違い
初期64→方向64→方向128は、読み出しと幅を別に変えた比較です。自前2019系は公開Aと同じ構造でも、固定fold・cutoutなし・BF16など学習条件が元解法と違い、20epoch後の追加3epochだけ低lr(倍率0.2)にしました。これらは同一の学習条件・同一計算予算の勝負ではありません。
学習時間だけの延長比較
幅128方向モデルを親20epochから100epochへ延長しました。モデル・学習率・batch・FP32・fold・前処理を固定し、optimizerとshuffle/torch/CUDAの乱数状態を復元しました。
| fold | 20epoch | 固定100epoch | 追加80epochの時間 |
|---|---|---|---|
| 0 | −1.672117 | −1.953720 | 4時間36分41秒 |
| 1 | −1.712256 | −1.948653 | 4時間40分05秒 |
fold0の差は−0.281603、分子bootstrap95%区間は[−0.286962,−0.276675]で、全8タイプ・48セルで改善しました。fold1の差は−0.236397で、全8タイプ・47/48セルで改善。分子bootstrap95%区間は[−0.241356,−0.231810]です。追加80epochは両fold計約9時間17分でした。両foldを観測した後で計画した比較なので、新たな独立検証とは呼びません。最良epochは補足、主比較は固定20対100epochです。
最後の20epochの学習率比較
各foldの同じ100epoch重み・Adam・shuffle/torch/CUDA乱数状態から、学習率0.0005対0.0001で各20epochを追加しました。変更因子は学習率だけ、主比較は固定120epochです。fold1をfold0の成績で選別せず、結果観測前に定めた時間予算で両条件を実行しました。全4条件は10月26日20:30までに完了しました。
| fold | 通常lr0.0005 | lr0.0001 | 差 | 分子bootstrap 95%区間 |
|---|---|---|---|---|
| 0 | −2.003803 | −2.208615 | −0.204811 | [−0.210165, −0.199689] |
| 1 | −1.992448 | −2.212999 | −0.220551 | [−0.224756, −0.215883] |
上表のlr0.0001は、全120epochを低い学習率で学習した意味ではありません。同じ100epoch親から追加した101〜120epochだけが対象です。スコア列は各条件の絶対CV値、「差」と95%区間は低lr−通常lrです。
両foldで全8タイプ・構造6群×タイプの全48セルのMAEが改善し、分子bootstrap1000回の95%区間も改善側でした。17,001分子ずつ、原子対数はfold0が931,526、fold1が928,633です。ID・分子名・タイプ・targetの整合、セル別の標本数も照合しています。
ただし、絶対値で見たbiasが改善したのはfold0が40/48、fold1が43/48セルです。MAEの全セル改善を、全セルの偏り解消と読み替えません。最小セルはfold0が42行・22分子、fold1が37行・22分子で、少数群には慎重な解釈が必要です。
| タイプ | fold0のMAE低減率 | fold1のMAE低減率 |
|---|---|---|
| 1JHC | 17.02% | 20.15% |
| 1JHN | 32.30% | 25.17% |
| 2JHC | 13.74% | 19.03% |
| 2JHH | 26.98% | 31.17% |
| 2JHN | 17.05% | 18.77% |
| 3JHC | 10.28% | 11.93% |
| 3JHH | 20.04% | 20.69% |
| 3JHN | 7.74% | 9.34% |
この結果は「100epochまで学習した今回のモデルに、追加20epochという同じ予算を使うなら、学習率を下げた方が良かった」という知見です。構造6群を入力して精度を上げた実験ではありません。群別の誤差を調べる用途と、クラスタを特徴に加える効果を区別します。
両foldは既に観測しており、単一seedでの探索です。区間は固定予測に条件付きで、再学習や条件選択の不確実性は含みません。新たな独立検証や完全5fold OOFとは呼びません。最良epochは副次的で、固定120epochの主比較を置き換えません。自前2019系fold0の低lr23epoch−2.368256をまだ超えていません。Kaggleへの追加提出はしていません。
学習・予測と完全再現の費用
第1段階の実測時間
自前モデルA構造の10→20epochは約7時間31分、学習率比較の追加3epochは現行約2時間11分・低学習率約2時間12分でした。共通の親20epochを二重加算しません。今回の13本再生では工程タイマーを保存しました。公開Aの全件推論セッションは17.05分、13本のセッション合計は5時間53分17秒でした。GPU区間の合計は5時間48分59秒です。GPU区間も処理区間の時間であり、カーネルだけをプロファイルした純演算時間ではありません。入力準備・モデル初期化などを含む全工程の時間とは区別します。
| fold0モデル | 20epochの学習・検証・保存 | 旧test全件の予測 |
|---|---|---|
| 初期64 | 40.6分 | 17.15秒 |
| 方向64 | 41.8分 | 17.50秒 |
| 方向128 | 67.9分 | 24.79秒 |
| triangle | 72.5分 | 29.24秒 |
RTX3060 12GBでの実測です。test入力準備は別途40.12秒。これらのtest予測は最良重みを使い、Kaggleへ追加提出していません。前処理、検証、保存、CSV出力、ensemble、提出・採点待ちは分けて記録します。親20epochと追加80epochを二重計上しません。
公開重みで予測を再生する場合と、全13モデルを一から再学習する場合では費用が異なります。全13本の推論セッションは実測済みですが、全13本を一から再学習する総時間は未実測です。短期ジョブから長期再学習を外挿した値は推定として扱い、実測時間と並べて確定値のように説明しません。
13本再生の工程別時間と、復旧
| 工程 | 実測 |
|---|---|
| 13本の推論セッション合計 | 5時間53分17秒 |
| 上記のうちGPU処理区間合計 | 5時間48分59秒 |
| 公式予測の集約 | 18.81秒 |
| Kaggleアップロード | 18.36秒 |
| アップロード完了から採点取得まで | 75.67秒 |
最後の時間は75秒間隔のポーリング待ちを含み、Kaggleサーバーだけの採点時間ではありません。入力テンソル作成、モデルロード、CPU独立再検算、失敗した初期試行・診断・復旧はこのセッション合計と別です。GPU区間を推論セッションへもう一度足すことはしません。工程別・モデル別の元表も保存しました。
提出待機コードは、日本語を含む許可JSONをWindowsの既定文字コードで読んで停止しました。まだ送信前だったことを台帳で確認し、UTF-8-sigを明示した新版で復旧しました。予測値と集約条件は変えていません。通信が不明なまま再送するのではなく、送信前のattempt記録と受付IDで二重提出を防ぐ設計です。
学習率比較4条件の追加計算時間
| fold | 通常lr・追加20epoch | 低lr・追加20epoch |
|---|---|---|
| 0 | 68.40分 | 68.75分 |
| 1 | 68.52分 | 68.44分 |
全4条件の学習・検証・保存は計16446.42秒(4時間34分06秒)。親100epochやCPU比較を重複加算しません。120epoch重みの旧test予測時間は未計測で、20epoch時点の各最良重みの予測時間とは分けています。
未達の理由:事実と仮説を分ける(発表資料PDFのp.23)
公開13本のPrivateは−3.22754、作者の歴史首位−3.23968との差は+0.01214です。これはタイプ別MAEの幾何平均比で約1.0122倍に相当します。全行MAE比や各タイプ一律1.22%差を意味しません。原本の集約は独立に再計算し最大差5.684e-14、ID・有限値・行数・hashも検査済みです。それでも首位との完全一致には至らず、差の原因は未特定です。
作者READMEによる勝者の環境はLinux13台、RTX2080 Tiを4基載せた5台(20GPU)、V100 32GBを1基載せた2台、V100 16GBを1基載せた6台、合計28GPUです。モデルを異なる機械で学習した説明であり、全28GPUを同時に使ったとは読めません。今回のRTX3060は学習可能な規模や探索時間を制約しますが、同じ重み・同じ入力を推論するだけで必ず低精度になるわけではありません。
A単体の既存参照との差は最大約0.001099Hz、平均約0.000002634Hzでした。前処理ライブラリ、丸め、PyTorch/cuDNN/GPUの数値挙動、公開成果物と最終提出の一致などは監査候補ですが、この微小差がスコア差全体の原因だと証明したわけではありません。RTX3060だからという説明で片付けません。
現代モデルは小型2層TensorNetを原子対Jの回帰へ適応させた構成で、単一seed、限られた特徴・学習予算で試しています。作者のGraph Transformerは原子・原子対・三原子組のmeta-graph、化学環境の細分類や部分電荷等を組み込み、複数モデルを長期学習して集約しています。同じ予算・同じ特徴条件の比較ではありません。今回、幅、学習時間、学習率の改善でスコアは一貫して良くなりましたが、fold0低lr120の−2.208615は自前2019系fold0低lr23の−2.368256に届きませんでした。
小型構成の表現力、Jに適した入力・読み出し、最適化予算が不足していた可能性はあります。ただし原因を単独に切り分けたわけではなく、「2026年の技術では2019年を超えられない」という結論にはしません。公開13本のKaggleスコアと自前CVを直接差し引くことも避けます。
公開重み+現代モデルのアンサンブル・stacking
誤差が補完的なら、単体で弱いモデルを混ぜても改善する可能性があります。まずは複雑なstackingより、同じ分子foldのclean OOFを使う単純加重平均やタイプ別平均で確認します。重みを決めるデータと評価するデータを分け、ID・type・targetを照合し、分子単位で不確実性を評価します。
ただし今回の公開13本は全trainで訓練済みです。公開重みの学習内予測とTensorNetのOOFを混ぜてstackerを学習・評価しても、公正なCVにはなりません。自前2019系とTensorNet双方のclean OOF、または学習範囲が確認できる本当のOOFが必要です。現時点では混合実験も追加提出も未実施で、改善の保証はありません。LBを見て混合率を反復調整する方針にはしません。
実行環境と数値精度の追加考察
首位との差には、当時と現在の実行環境・計算精度・前処理の違いが寄与した可能性があります。計算設定による予測差は確認しましたが、スコア差への寄与は未検証です。RTX3060固有の精度不足とは断定できません。モデルAの同じ6,901行で、参照予測との差を比較しました。
| matmul TF32 / cuDNN TF32 | 最大差 [Hz] | 平均差 [Hz] |
|---|---|---|
| False / False | 0.00195 | 0.000117 |
| False / True(採用) | 0.000235 | 0.00000229 |
| True / True | 0.0333 | 0.00110 |
これは参照予測への一致度で、正解に対する誤差ではありません。高精度設定が当時の予測に常に近いわけでもありません。全件A比較の最大差0.001099 Hzとは標本範囲が異なります。計算精度についてはPyTorch公式の数値精度に関する文書も参照してください。
TensorNetの方向読み出しを図で確認する
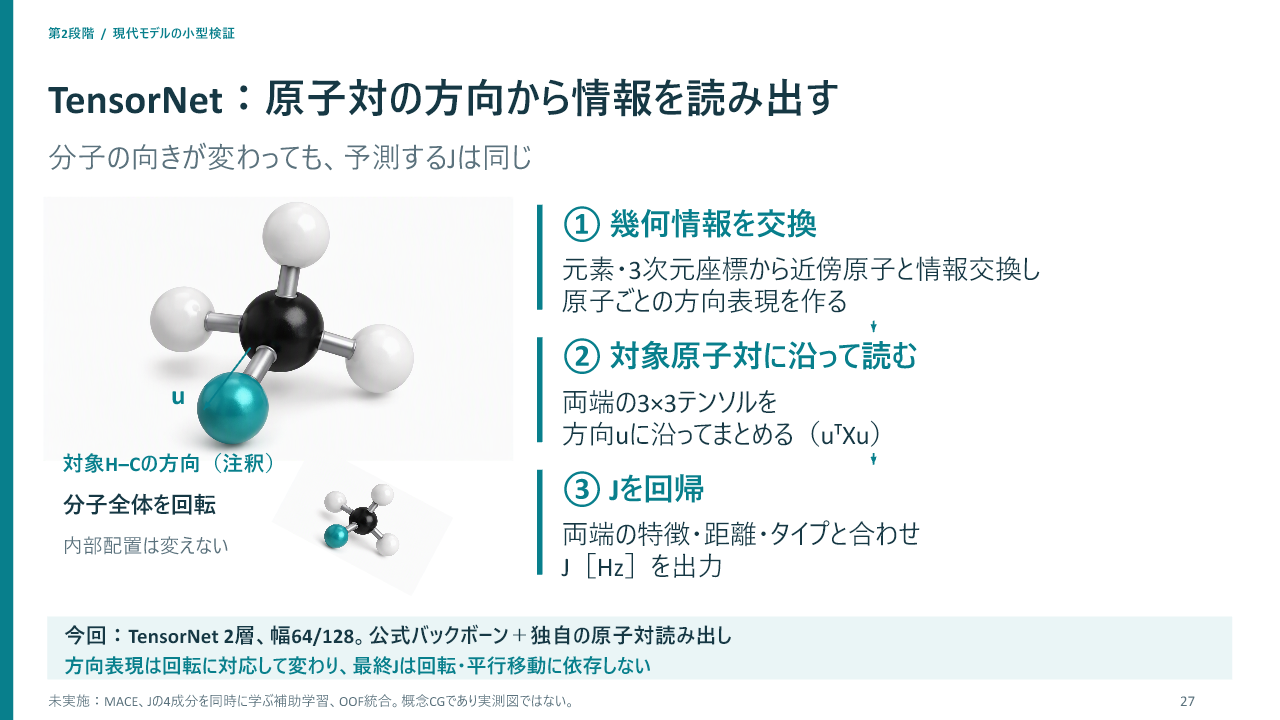
元素・座標から原子の方向表現を作り、対象原子対の方向uに沿ってuᵀXuとして読み出し、両端特徴・距離・タイプと合わせてJを予測します。回転に伴いテンソルとuが一緒に変わると読み出しは不変です。内部配置を変えてもJが同じ、という意味ではありません。公式TensorNetバックボーンに独自のpair headを加えた小型検証で、MACE・4寄与の補助学習・OOF統合は未実施です。図はCopilotの概念CGと編集可能な説明からなり、実測図ではありません。
補足:改善仮説をどう検証したか
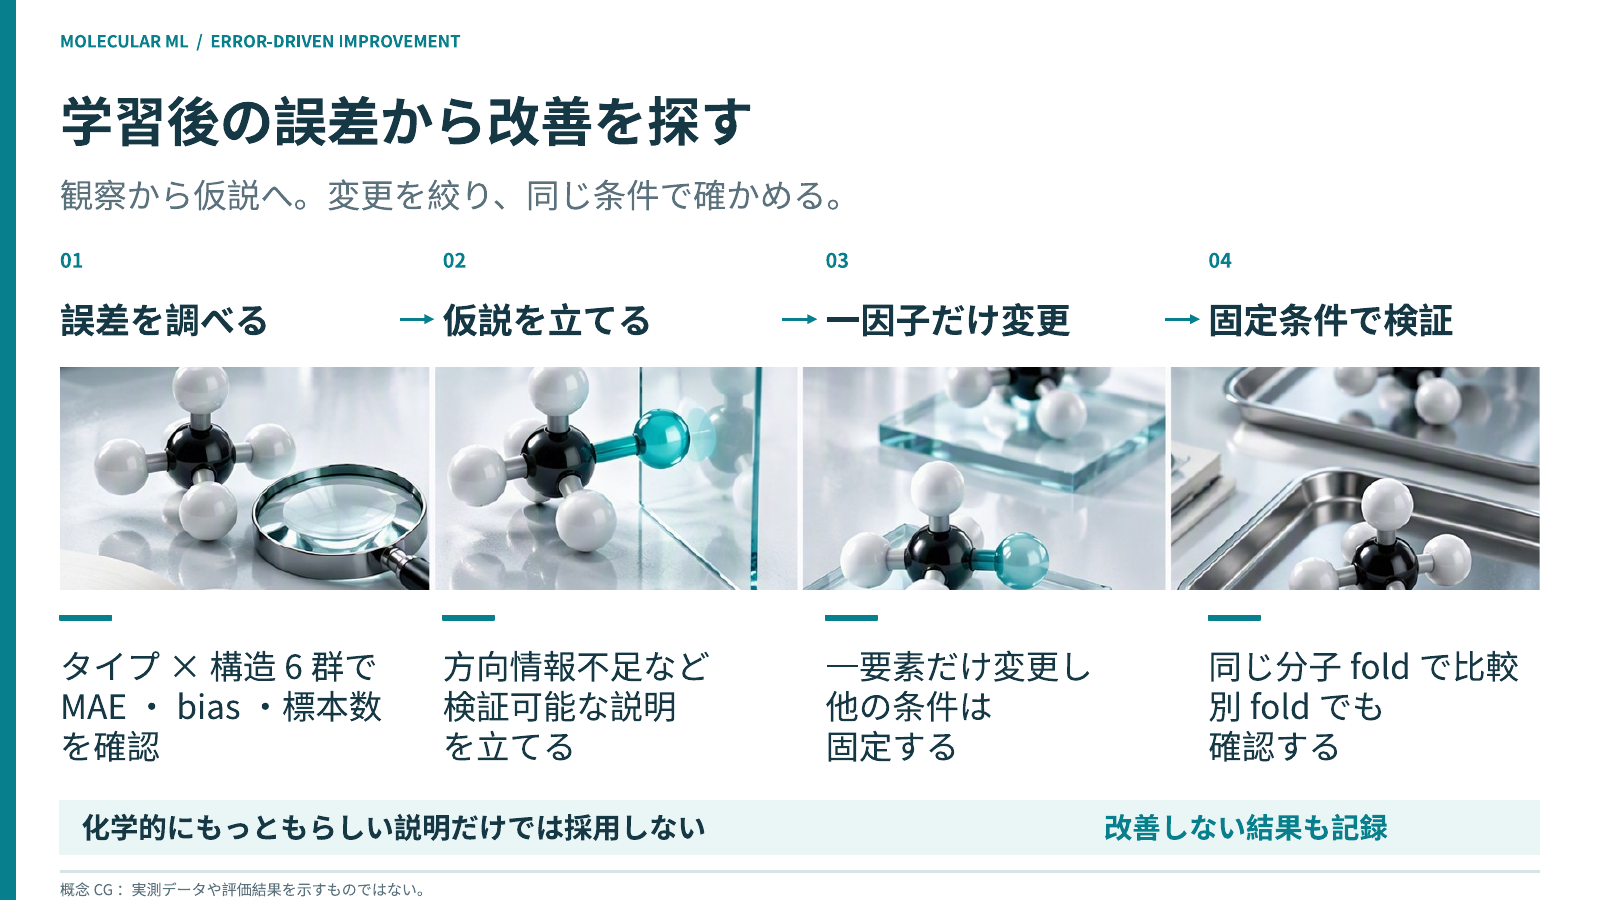
タイプ×構造6群のMAE・bias・標本数から誤差を確認し、検証可能な仮説を立てます。モデルの一要素だけ変更し、同じ分子foldで比較、別foldでも確認します。化学的にもっともらしい説明だけでは採用せず、改善しない結果も記録します。概念CGは実測結果ではありません。方向読み出し・幅は事前固定した別foldで効果を確認したが、100epoch延長は既観測2foldでの探索であり、新たな独立確認ではありません。
結果を読むための用語
| 用語 | 意味 |
|---|---|
| checkpoint / 保存重み | 学習済みの状態。学習を再開したり予測したりする |
| fold / held-out | 分子単位で分けた、学習側とは別の検証集合 |
| OOF予測 | 各分子を学習に使わなかったモデルで予測する |
| ensemble / ブレンド | 複数モデルの予測を組み合わせる |
| 一因子の比較 | 方向・幅・時間など、変更する条件を一つに絞る |
公開重みの参照採点、同じfoldでの探索、事前固定した別foldでの確認、完全5fold OOFを区別します。
入門サンプルを実行する
配布用のZIP内のREADME.md、eda/requirements.txt、eda/sample_eda.pyを使います。1000分子でk-means、t-SNE、UMAP、Jの分布を作るCPUサンプルは23.6秒で実行できました。研究本番の15特徴とは別の簡易12特徴なので、クラスタ番号を本番と対応づけません。元データ、秘密情報、モデル重みは配布コードに含めません。必要な旧データはREADMEの案内に従って別途用意します。
この小規模サンプルはコンペとEDAを理解する入口です。最高スコアの再現を数十秒で達成するプログラムではありません。歴史首位スコアとの完全一致、全モデルの再学習、自前完全OOF、現代モデルで2019系を超える改善は引き続き課題です。
Summary:成果・得られた知見・残る課題
- 公開重み13本の再生でPrivate−3.22754。事前に忠実再現を定義した統合戦略が今回の主成果につながりました。
- Codexを司令塔に、GPU計算中の資料制作、5時間枠の回復待ち、途中からスマホでの外出先確認・指示・通知を組み合わせました。約70時間は睡眠・外出も含む経過時間で、人の実操作時間ではありません。
- EDAの構造理解・仮説生成と予測改善は別。6クラスタ距離特徴量の追加は不採用で、スコア向上のためのクラスタリングEDAの費用対効果は引き続き要検討です。
- 現代モデルは検証の中で改善したものの、今回のスコア更新手法としては未達。首位との差の原因、現代モデルの構成と最適化、自前cleanOOFをそろえた混合評価が今後の課題です。
配布ZIPの使い方:提出用CSVとプログラム
ZIPを展開すると、最上位にMolecular_repro_v1.00フォルダがあります。そこを基準に、次のファイルを使います。
| 目的 | ZIP内のファイル | 必要なもの |
|---|---|---|
| Kaggleに提出するCSV | submission/submission_official13.csv |
既に作成済み。旧test 2,505,542行、列はidとscalar_coupling_constant。 |
| 提出CSVを作成するCPUプログラム | submission/create_submission.py |
同梱の計算済み予測を集約。GPU・元CSV・モデル重みは不要。 |
| CPU集約に使うデータ | submission/official13_predictions.npz |
13モデルの計算済み予測・ID・集約用タイプ番号。test正解ではありません。 |
| 公開重みから再推論するGPUコード | research/scripts/run_reference_family_full_v3.py |
NVIDIA CUDA GPU、公式13重み、旧データ、前処理cache等が別途必要。GPU_INFERENCE.md参照。 |
| 入門EDAのプログラム | eda/sample_eda.py |
旧CSVを別途取得。提出CSVを作るプログラムではありません。 |
GPU再推論の準備:公式重み・旧データ・前処理
- 公式重みを入手:Bosch公式実装BCAI_kaggle_CHAMPSのget_saved_models.shを参照します。スクリプト内に公開A〜MのGoogle Drive取得先と
gdownによる取得処理が記載されています。保存先と対応する各モデルのコード・configを確認して取得してください。モデル重みは本ブログのZIPには同梱していません。 - 旧データを取得・照合:前の記事「Predicting Molecular Properties 旧データ取得でLate Submission」に、旧データ取得先、4CSVの配置、提出ID・行数の確認、現行trainと混ぜない注意点をまとめています。まずこちらで同じ版の入力をそろえてください。
- モデル固有の前処理:前の記事で扱うのは旧データの準備と整合確認までです。Graph Transformer用の原子・結合・三つ組、語彙、正規化情報の作成は別工程です。Bosch公式READMEのData Processingと、ZIP内の
GPU_INFERENCE.mdを参照してください。2019年当時の依存ライブラリと現在の環境の差にも対応が必要です。
前処理スクリプトもZIPに同梱しています。主な対応は次のとおりです。
| 工程 | ZIP内のスクリプト | 内容 |
|---|---|---|
| 原子・結合等の表現作成 | research/scripts/prepare_winner.py |
旧CSVから推定結合・三つ組等を作り、前処理cacheへ保存。公式コードの互換移植も行います。 |
| 公開重み参照用の語彙・正規化・Aの参照推論 | research/scripts/replay_winner.py |
前処理済みデータから語彙・統計を作成し、モデルAの参照予測を生成。公開重み再生用であり、自前OOFへ流用しません。 |
| 13モデルの重み互換監査 | research/scripts/audit_reference_family.py |
モデルごとの構造・checkpoint対応とstrictロードを確認。 |
| 全13本のGPU再推論 | research/scripts/run_reference_family_full_v3.py |
準備済みcache・変換済み重み等から逐次予測し、公式集約。 |
これらは研究実行時のソースで、固定パス・凍結plan・cache等への依存が残ります。展開だけでGPU推論全工程が自動構築されるものではありません。GPUを使わず付属CSVを作り直すだけなら、上の準備は不要で、submission/create_submission.pyだけを使います。
付属CSVは提出ID57657490で採点された正本とSHA256が一致します(Public −3.23528 / Private −3.22754)。CPUコードも実行し、同じCSVをバイト単位で再生成できることを確認しました。このPCでは約16秒でした。これは公式集約の再実行であって、ニューラルネットを16秒で再推論した意味ではありません。
|
1 2 |
python -m pip install -r submission/requirements.txt python submission/create_submission.py --out submission_recreated.csv |
上記はZIPの最上位Molecular_repro_v1.00で実行します。出力CSVのSHA256一致を検査し、検証JSONも保存します。Python/pandasや改行の差があれば完全一致と扱わずエラーを出します。Kaggleへ自動送信する処理は含みません。旧形式のLate Submission用なので、利用時の規約・参加手続き・受付状況は各自確認してください。
元のKaggle train/test/structures CSV・モデル重み・認証情報は再配布していません。更新版ZIPは、提出用CSVと計算済み予測に加え、入門EDA、集計結果、共通プロンプト、研究ソース抜粋を含みます。モデル重みからのGPU推論全工程を一発で構築する配布物ではなく、準備条件はGPU_INFERENCE.mdに明記しています。
発表PDF・再現用データをダウンロード(v1.00)
ZIPにKaggle提出用CSV・CSV生成プログラム・計算済み13モデル予測を同梱しました。 計算済み予測からのCSV再生成はCPUのみで実行可能です。公開重みから予測し直すGPU推論ソースも収録していますが、公式重み・旧データの取得と整合確認・モデル固有の前処理等の別途準備が必要です。