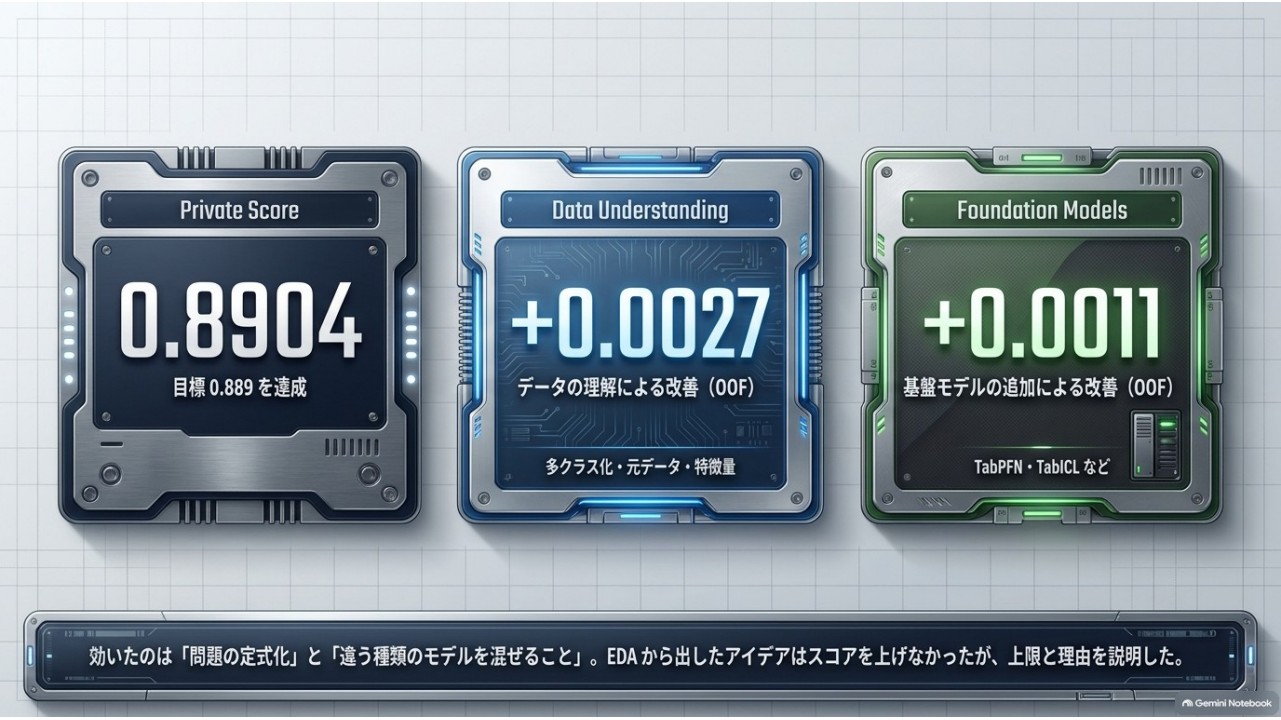
Kaggle Playground Series S4E3「Steel Plate Defect Prediction」に、終了後のLate Submissionで挑戦しました。鋼板の表面欠陥を7種類の確率で予測するコンペです。最終結果はPrivate 0.89042 / Public 0.89649。目標のPrivate 0.889を超えました。
Claude・ChatGPT・Geminiによる上位解法調査から始め、CodexでGBDTを実装。Codex Astraの利用枠が尽きた後は、コードと作業ログをClaude Codeに引き継ぎ、TabPFNやTabICLを追加しました。さらにEDAで残った難問を調べ、効きそうな案も実験しています。その経過を最終版スライドの図と一緒に振り返ります。
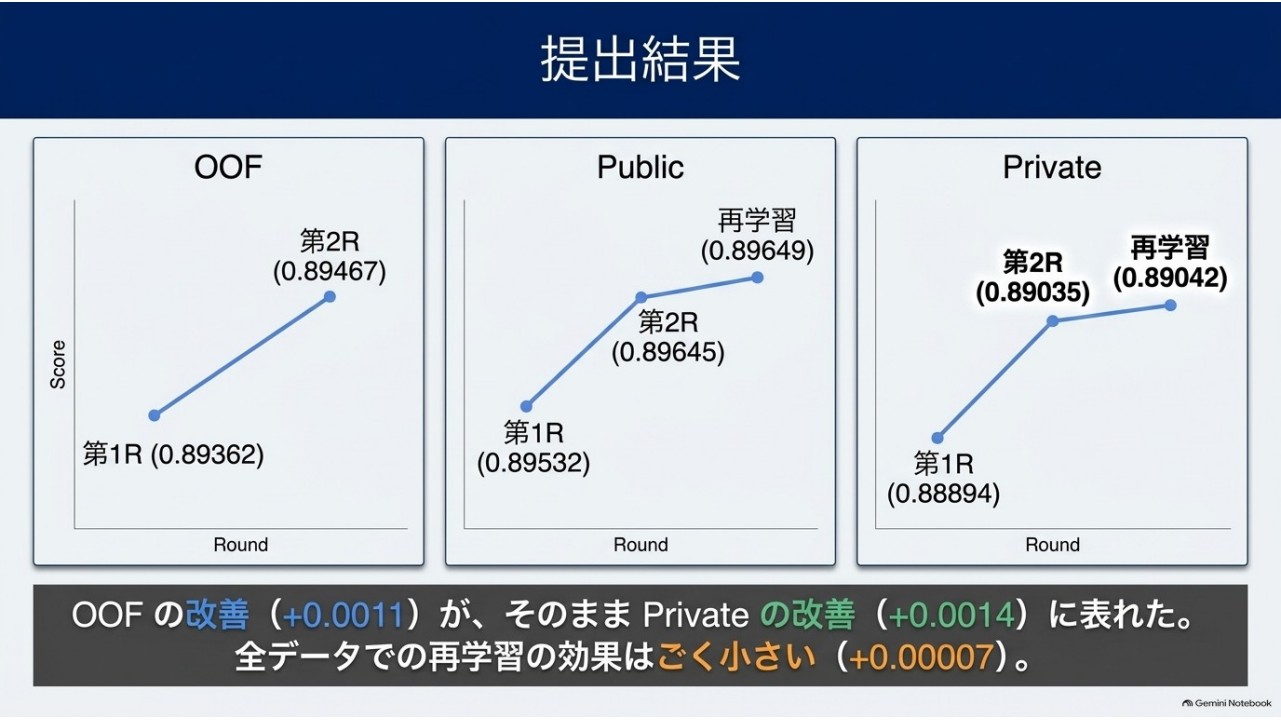
先に結果:Private 0.88894から0.89042へ
| 提出 | OOF mean AUC | Public | Private |
|---|---|---|---|
| 第1ラウンド:GBDT 4モデル | 0.893619 | 0.89532 | 0.88894 |
| 第2ラウンド:10モデルのブレンド | 0.894672 | 0.89645 | 0.89035 |
| GBDTを全データで再学習 | 0.894672 | 0.89649 | 0.89042 |
第1ラウンドから第2ラウンドへの改善幅は、OOFが+0.00105、Publicが+0.00113、Privateが+0.00141でした。第1ラウンドの提出IDは56497479、第2ラウンドのfold平均版は56502005、最終の全データ再学習版は56502305です。
OOFは「各行を学習に使っていないモデル」で作った予測の評価です。モデル選択には固定した10-foldのOOFを使い、Publicスコアを見て重みを調整しませんでした。Late Submissionなので当時の順位表には載りません。上位スコアとの比較は参考値です。
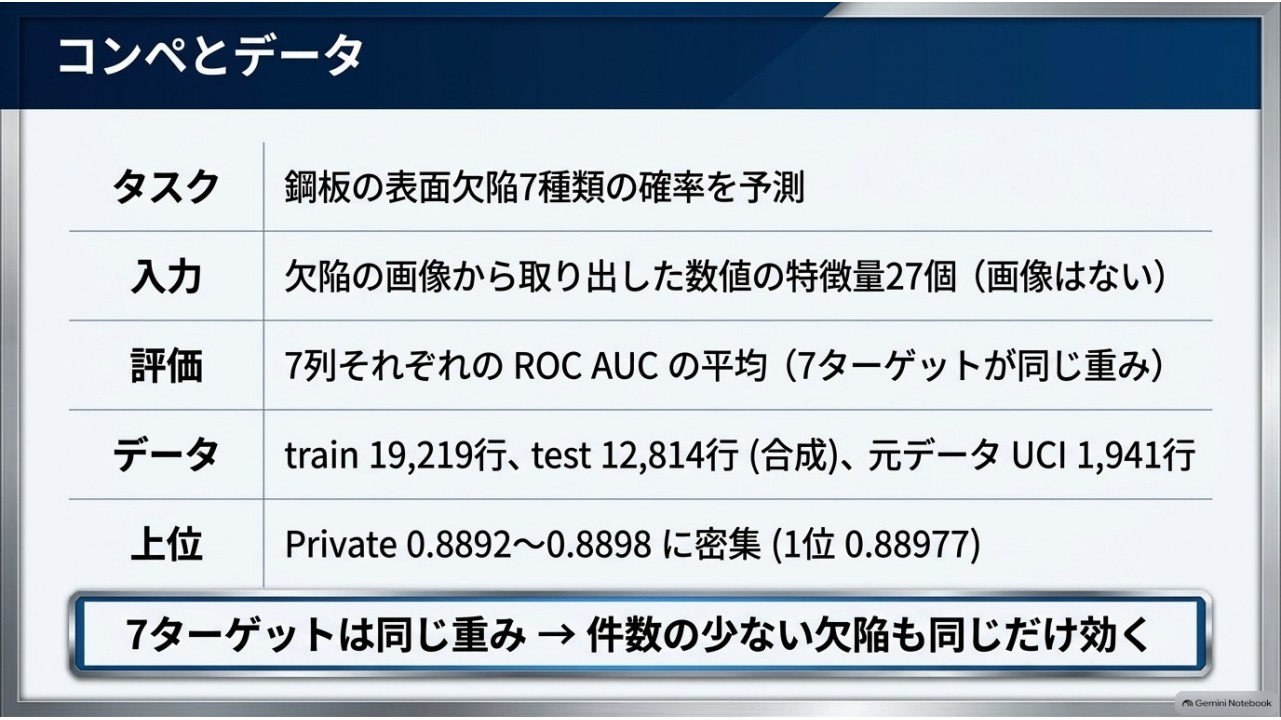
コンペの問題設定
入力は画像そのものではなく、欠陥領域の位置・面積・明るさなど27個の数値特徴量です。学習データは19,219行、テストデータは12,814行。7種類の欠陥それぞれのROC AUCを計算し、その単純平均で評価されます。件数の少ない欠陥も多い欠陥も、スコアへの重みは同じです。元のUCIデータ1,941行も利用しました。
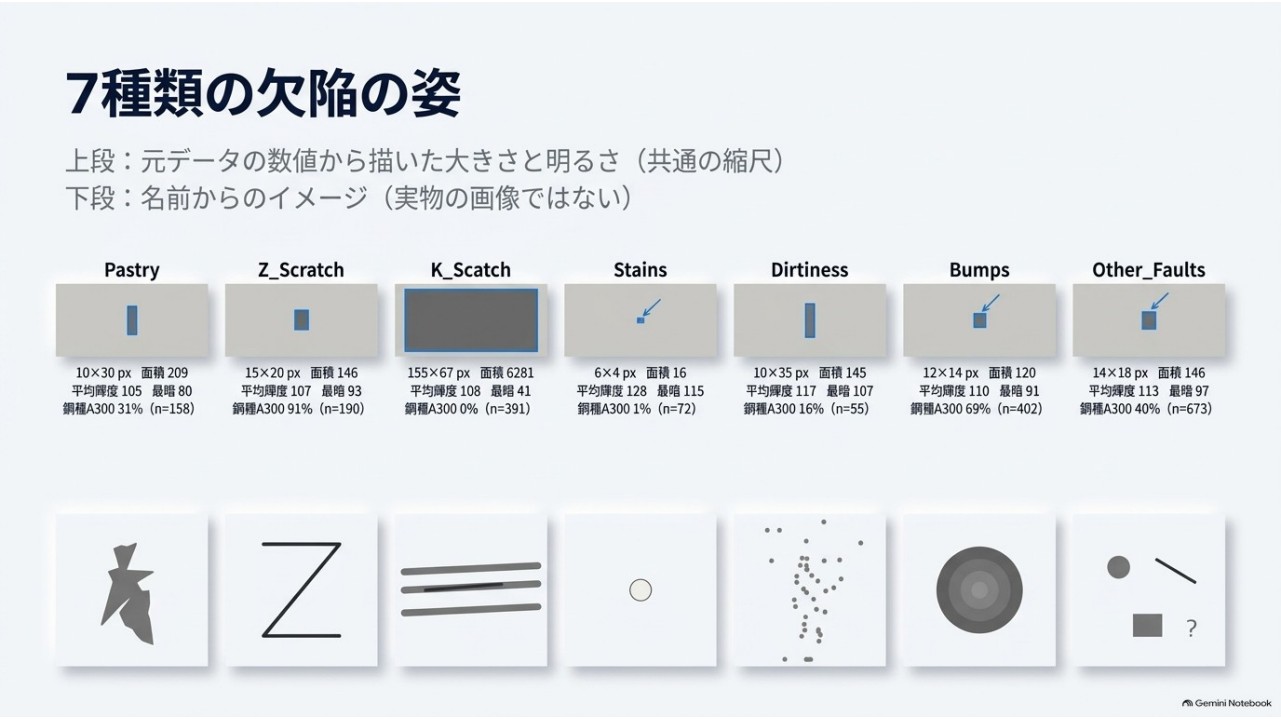
欠陥名は姿を想像する助けになりますが、次の図の欠陥の姿は説明用のイメージです。実物の形や寸法を表す資料ではありません。
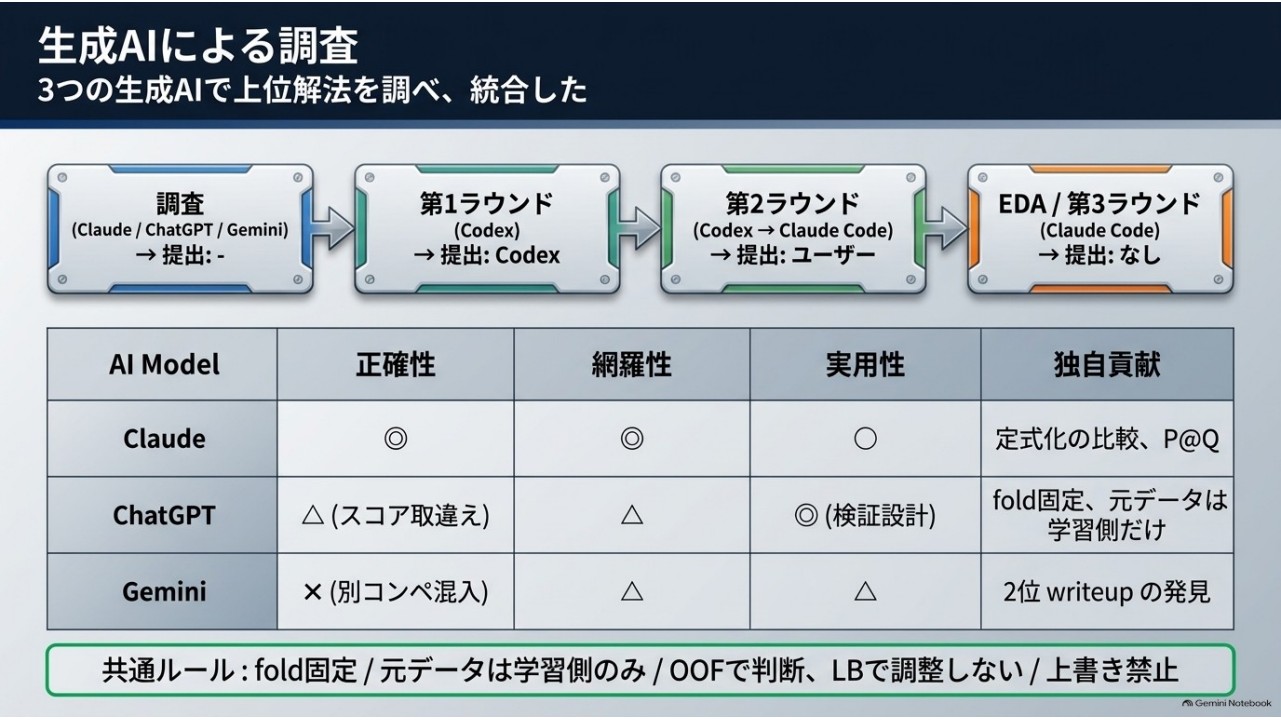
3つの生成AIで調べ、原文で確かめる
Claude、ChatGPT、Geminiに同じ依頼文で上位解法を調べてもらいました。Geminiは2位解法の公開writeupを見つけ、ChatGPTは固定foldでのOOFやリークを避ける検証手順を提案し、Claudeは幅広い解法を整理しました。一方、3者とも事実の取り違えや抜けがありました。順位、スコア、採用手法はKaggleの原文や公開コードまで戻って照合しています。この比較は今回の1件の調査での観察で、統合と評価をClaudeが担当したことによる偏りもありえます。
第1ラウンド:問題の立て方が効いた
最初は7本の二値分類XGBoostでOOF 0.889592。欠陥はほぼ1行につき1種類なので、7欠陥+欠陥なしの8クラス分類に切り替えました。8クラスの確率を学習foldから作った変換行列で提出用の7列へ戻し、OOFは0.890090になりました。
次に元データを学習foldにだけ追加して0.891059。さらに2位の公開解法を参考に特徴量を追加・削除して0.892303。GBDT 4モデルのブレンドで0.893619まで伸びました。最初の提出はPrivate 0.88894で、目標の0.889に0.00006届きませんでした。
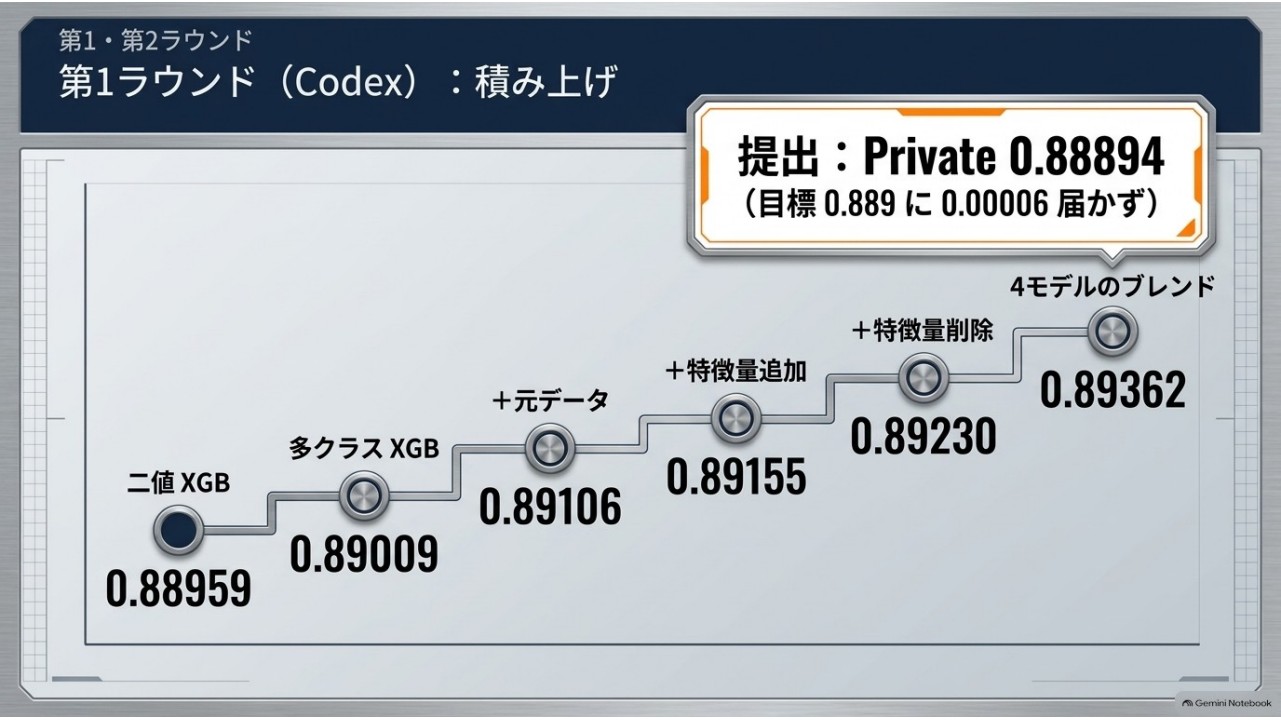
ただし4モデルはすべてGBDTで、OOF予測の順位相関は0.90〜0.98。同じような間違いをするモデルばかりでは、平均しても伸びにくい。次は違う間違いをするモデルが必要でした。
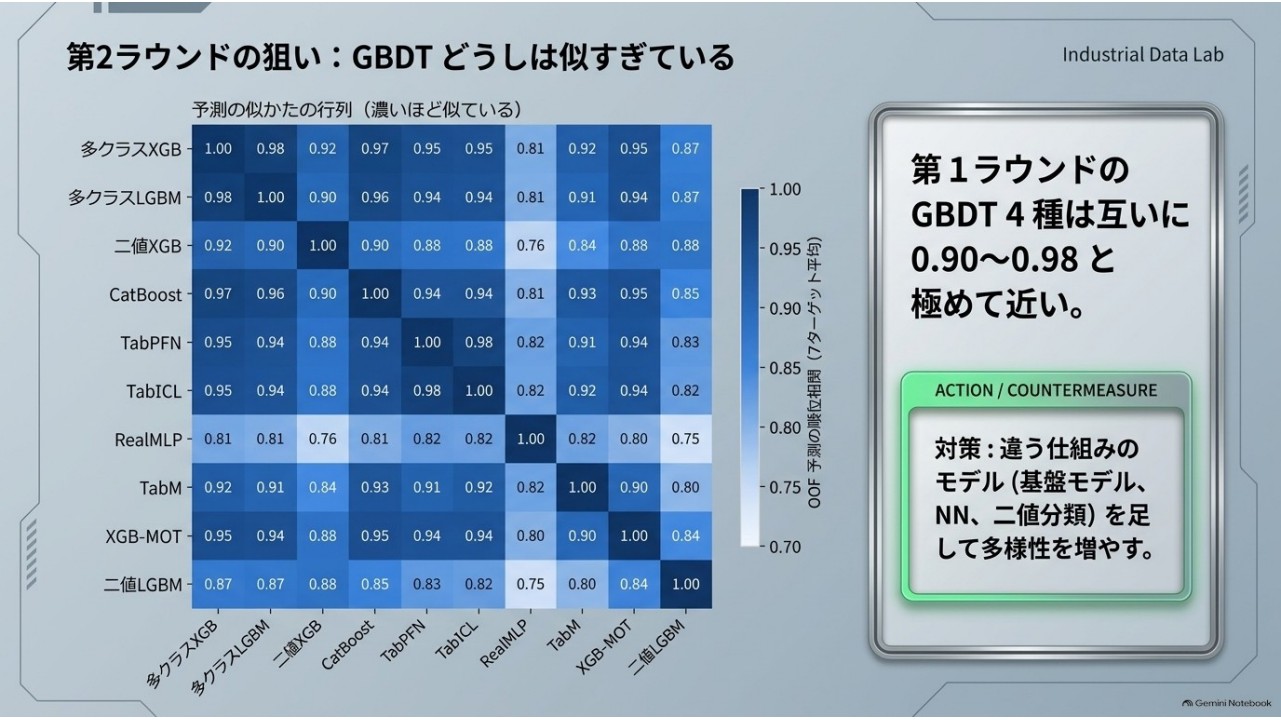
第2ラウンド:TabPFNとTabICLを加える
Codexが実行環境を整えたところでAstraの利用枠を使い切り、Claude Codeが続きを引き継ぎました。固定fold、上書きしない実験記録、引き継ぎログを残していたため、同じ条件で実験を続けられました。
追加候補を選ぶ際は、既存の木モデルと異なる予測を得られるかを重視しました。候補メモでは表形式基盤モデルのTabPFNとTabICL、ニューラルネットのTabMとRealMLPを挙げ、12GBのGPUメモリで動かせるかや利用条件も確認しました。GBDTはSteel、ニューラルネットと基盤モデルはSteel-nnの環境で実験しました。
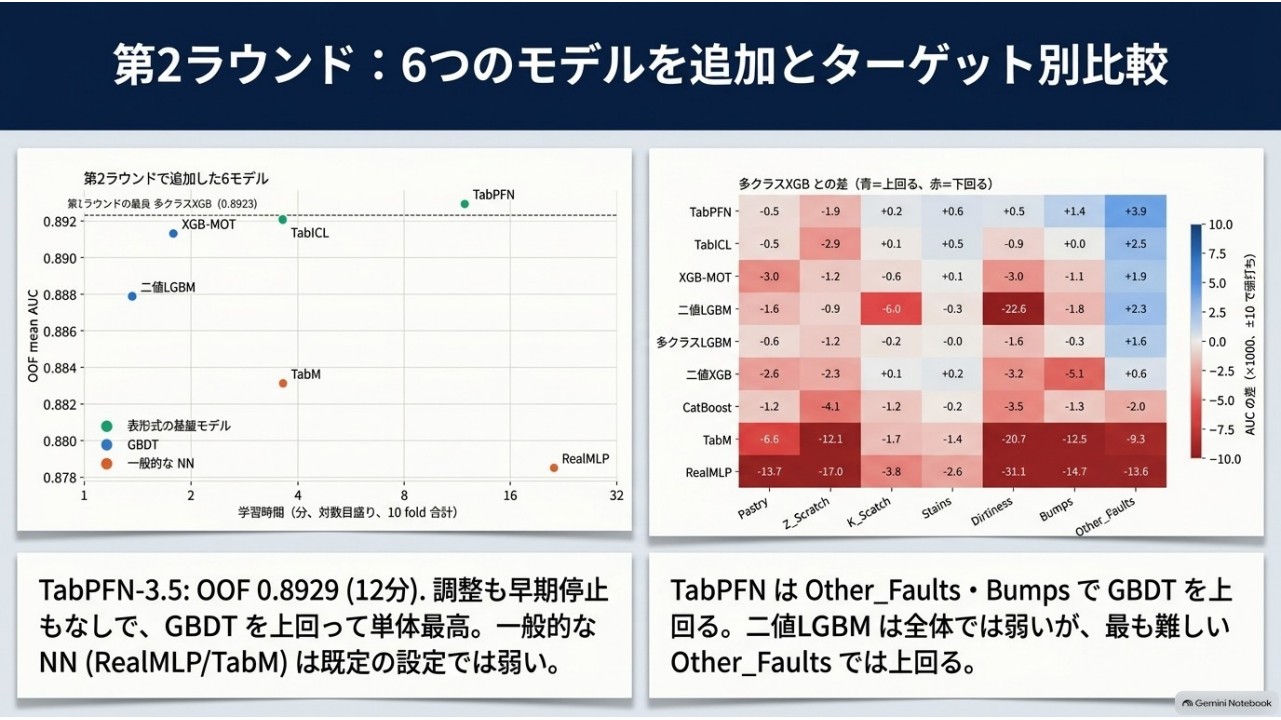
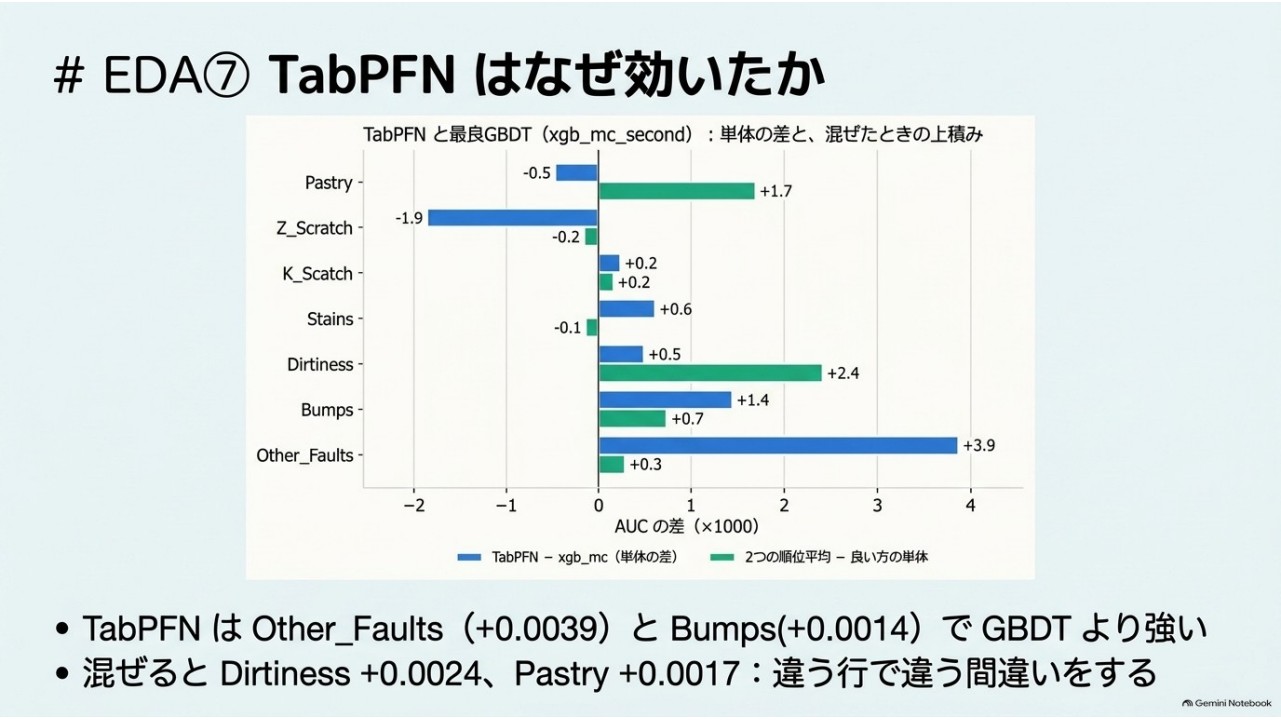
TabPFN-3.5、TabICL、二値LightGBMなど6モデルを追加。TabPFNの単体OOFは0.892924で、この時点の単体モデルでは最高でした。TabICLは0.892089。RealMLPやTabMは既定設定では届きませんでしたが、十分に調整した比較ではありません。
10モデルのブレンド重みは、検証fold以外のOOFで学ぶcross-fittedな方法で評価しました。最良は全体共通のNelder-Mead重みでOOF 0.894672。重みはTabPFN 0.29、二値XGBoost 0.18、TabICL 0.16、二値LightGBM 0.12など。二値LightGBMは単体OOFが0.887879でも、ほかと予測が違うため残りました。
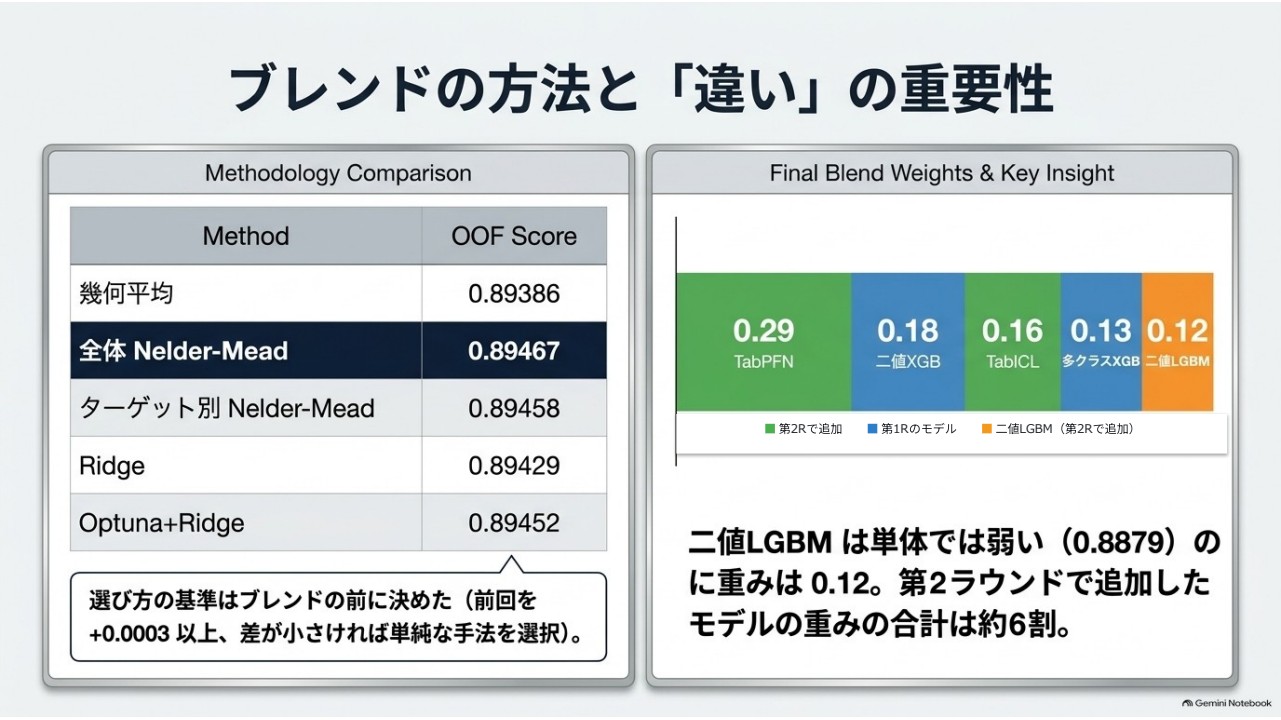
事前に決めた基準で提出した結果はPrivate 0.89035。GBDT部分を全データで再学習した比較版は0.89042でした。差は0.00007と小さく、この1回の比較で再学習の効果を断定できません。
EDAで「どこが難しいか」を見る
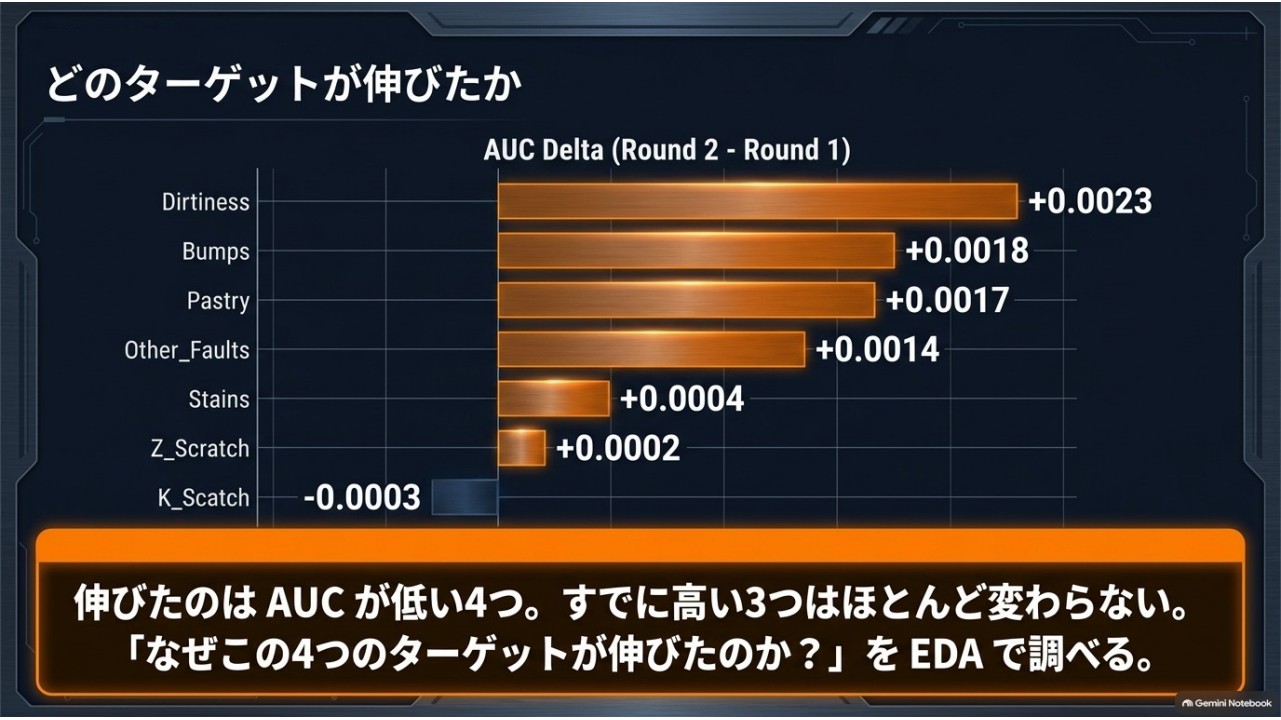
7欠陥の難しさはそろっていません。StainsとK_ScatchはすでにAUC 0.99前後ですが、Other_Faultsは約0.717、Bumpsは約0.819。第2ラウンドで伸びたのも、主にDirtiness、Bumps、Pastry、Other_Faultsです。改善余地は見分けにくい側に集中しています。
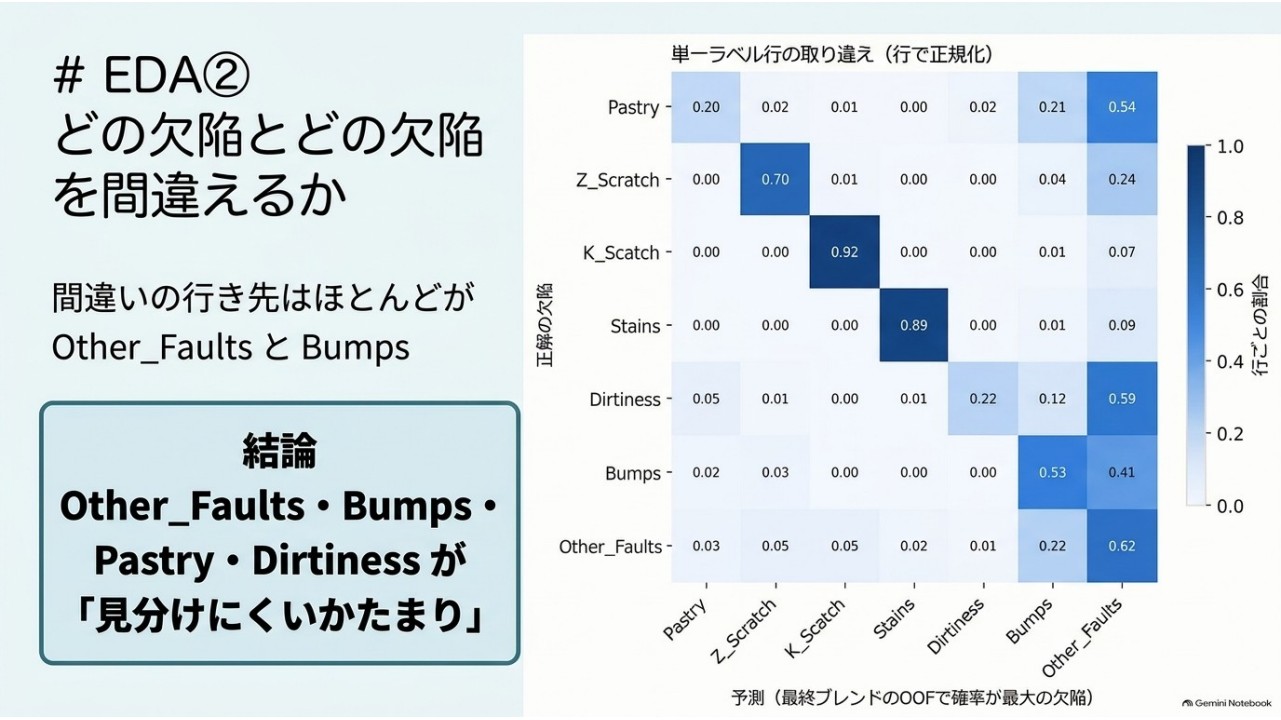
Other_Faultsは件数が多い一方で最も低いAUCです。多様な欠陥をまとめたクラスで、特定の数値特徴量だけでは決めにくいと考えられます。BumpsやPastryとの境界も曖昧でした。
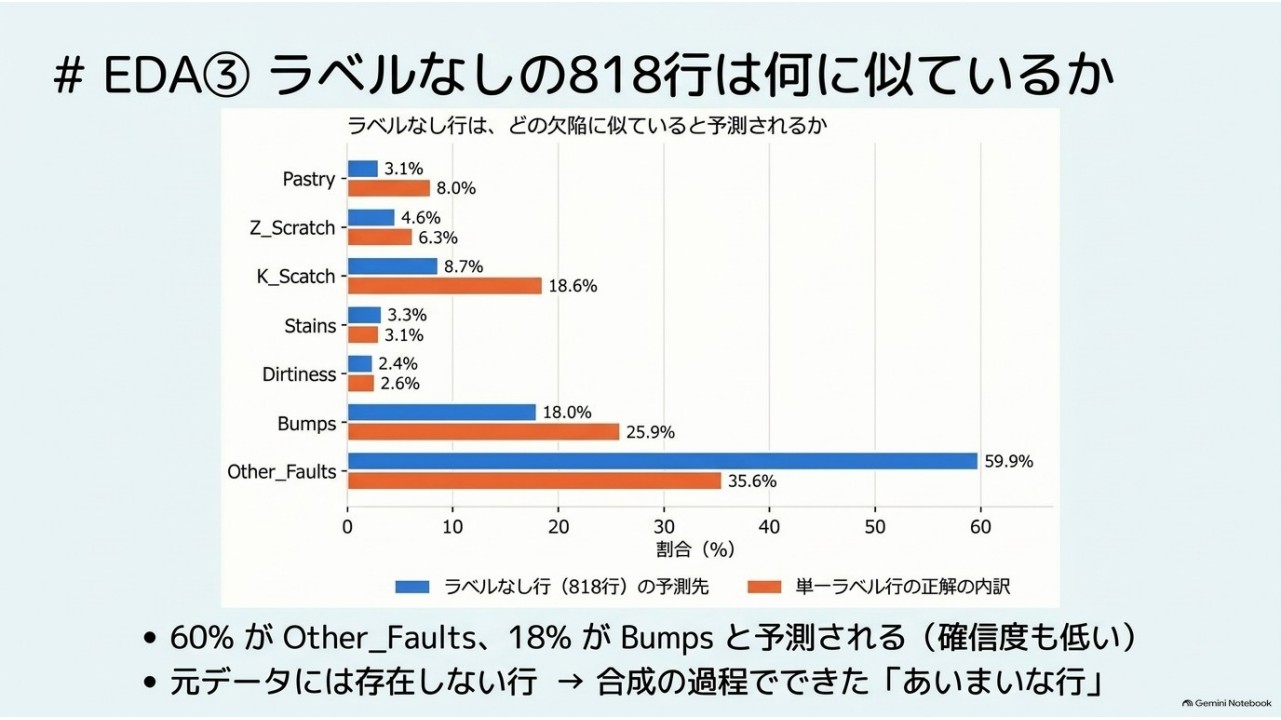
ラベルがすべて0の818行は、OOF予測上もOther_Faultsに似たものが多い。ただし、学習から除外してもスコアは上がりませんでした。
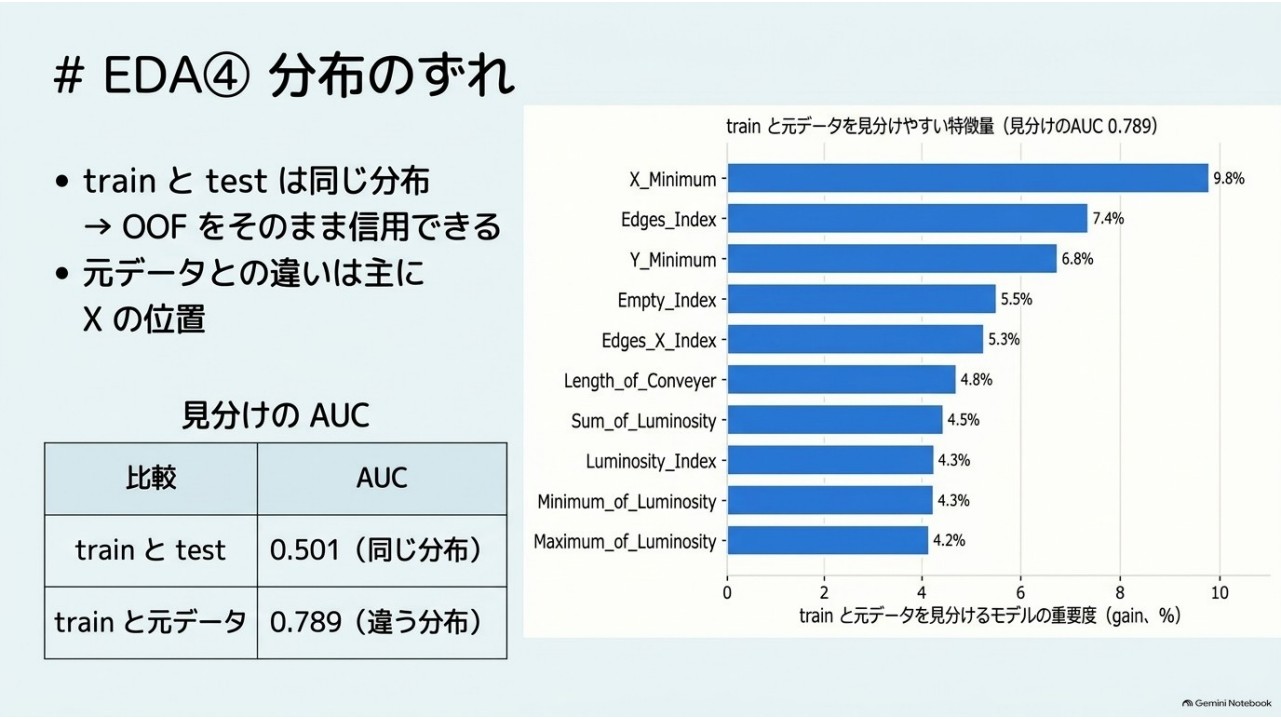
trainとtestを特徴量だけで見分ける分類器のAUCは0.501で、ほぼ区別できません。一方、コンペの合成データと元データはAUC 0.789で区別できます。OOFを信じる根拠がある一方、元データを検証側に混ぜない設計も大切です。
TabPFNは難しい欠陥の一部でGBDTと異なる間違いをしました。単体スコアだけでなく、予測の違いがブレンドで最大の重みを得た理由です。
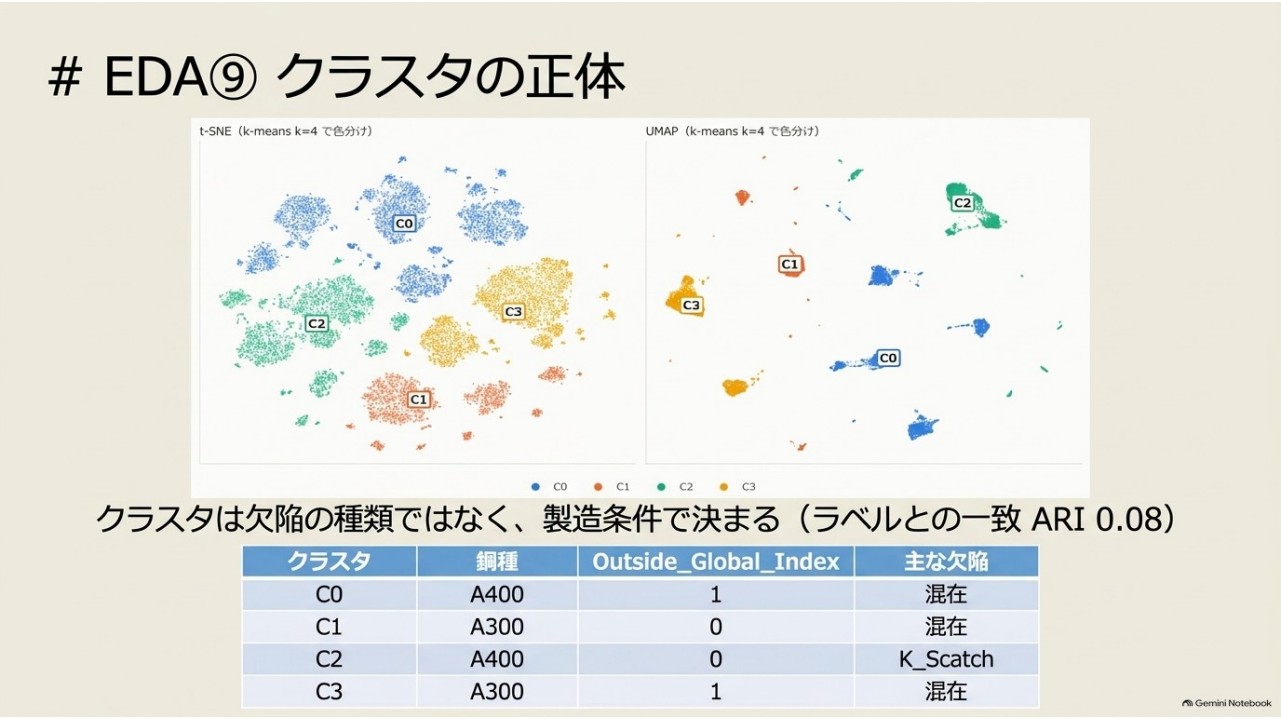
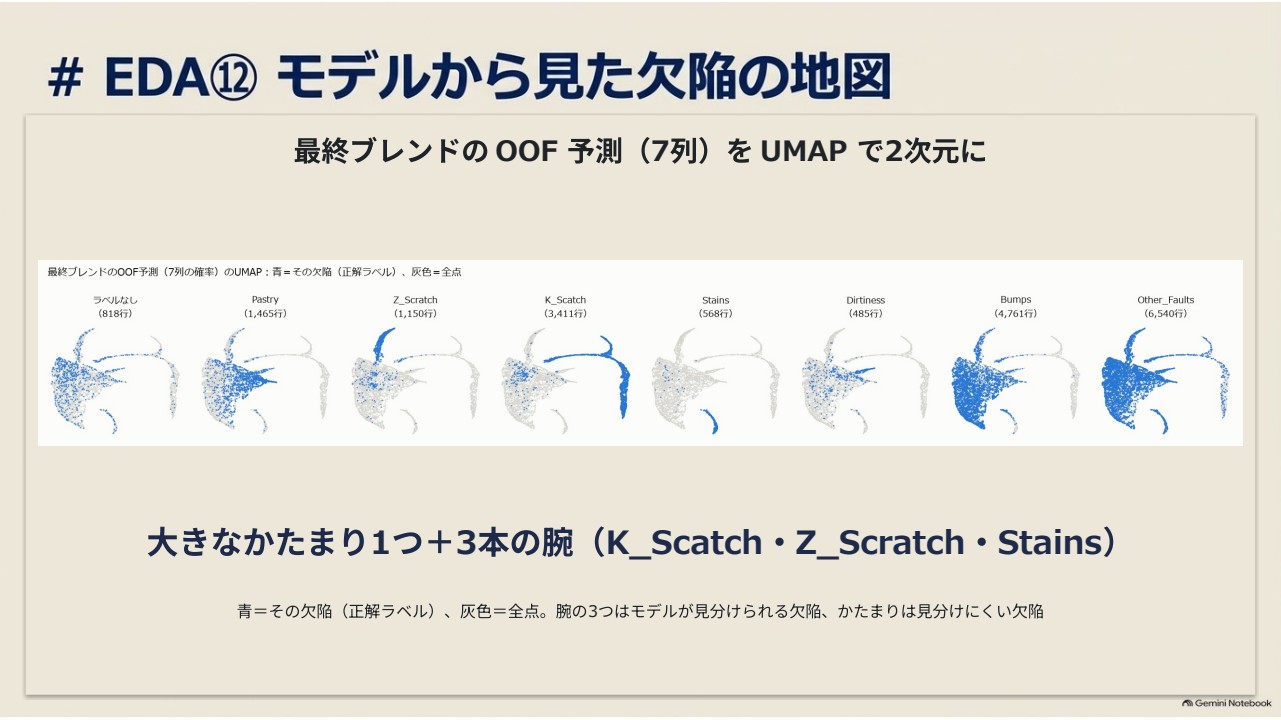
特徴量のUMAPでは、分かりやすい欠陥が離れた領域に現れ、Other_FaultsやBumpsは大きなかたまりに混ざります。2次元表示だけで高次元の関係を断定はできませんが、難しい欠陥の境界が曖昧だという結果と整合します。
第3ラウンド:EDAのヒントは提出基準に届かず
特徴量の追加、ラベルなし行の扱い、かたまり専用の2段目モデル、ノイズクラス、seed平均を固定foldで試しました。単体で少し改善したものもありますが、既存ブレンドへの寄与は最大でも約0.0001。事前に決めた「OOFを0.0003以上改善」という基準に届かず、第3ラウンドでは提出しませんでした。
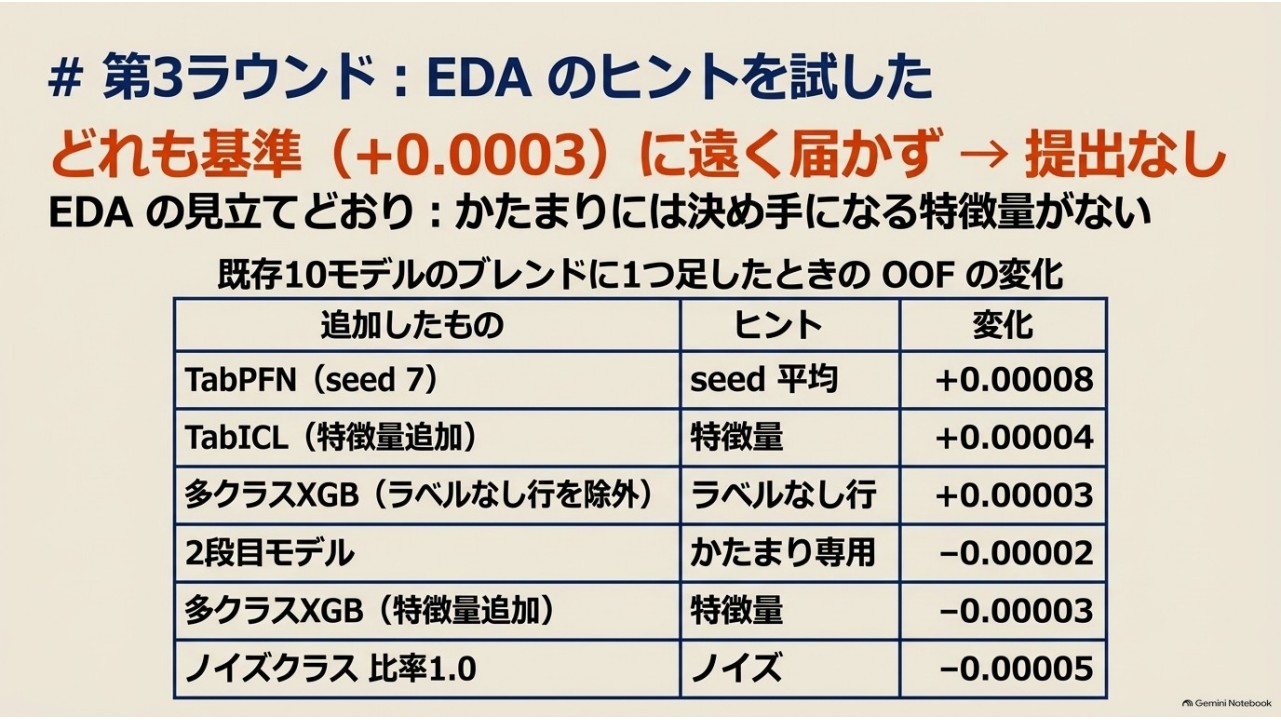
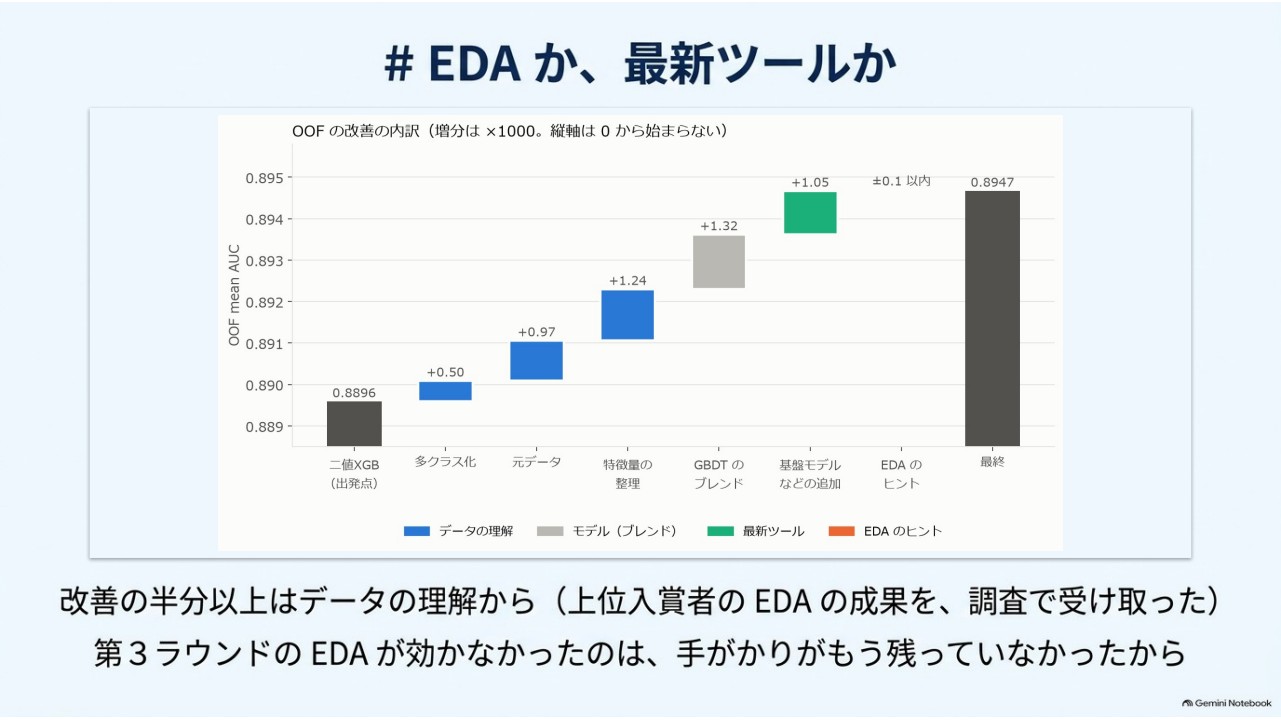
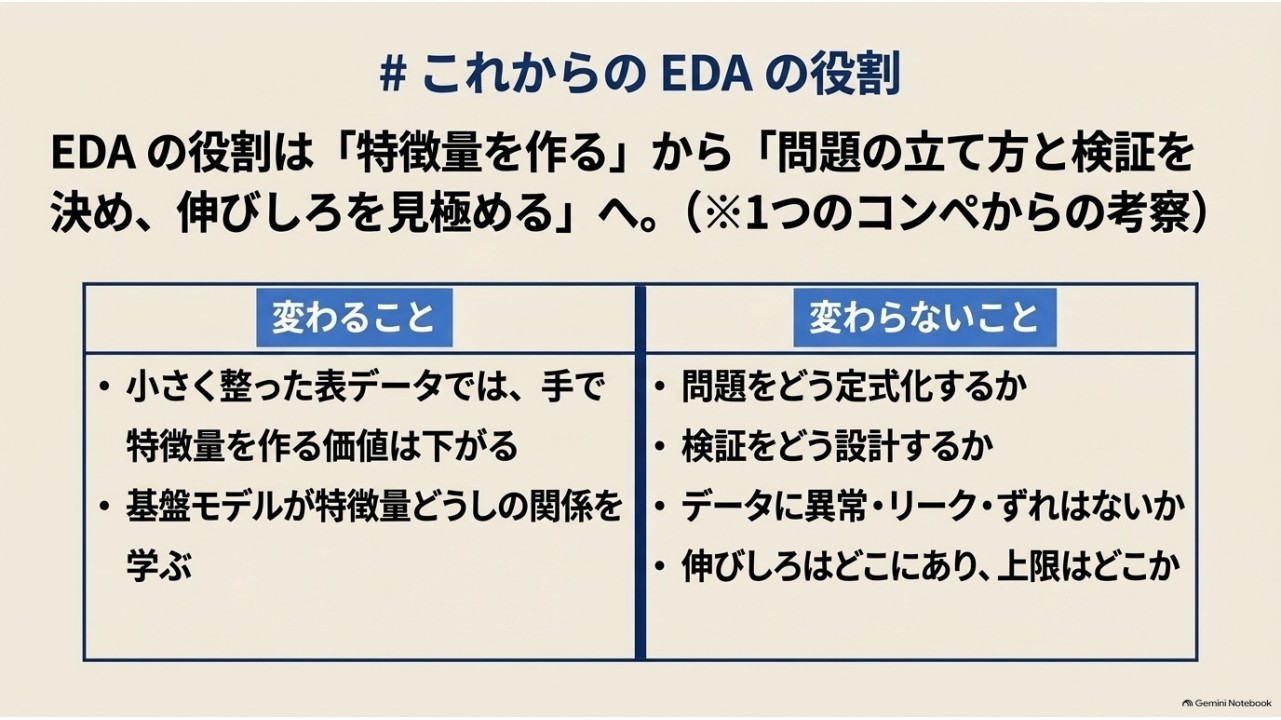
「EDAは不要だった」とは考えていません。最初の多クラス化、元データの扱い、重なる特徴量の削減は、データの構造を理解したうえでの選択です。後から行ったEDAは新たなスコアを生まなかったものの、残る難しさと伸び止まりを説明してくれました。
AIエージェントを引き継げた理由
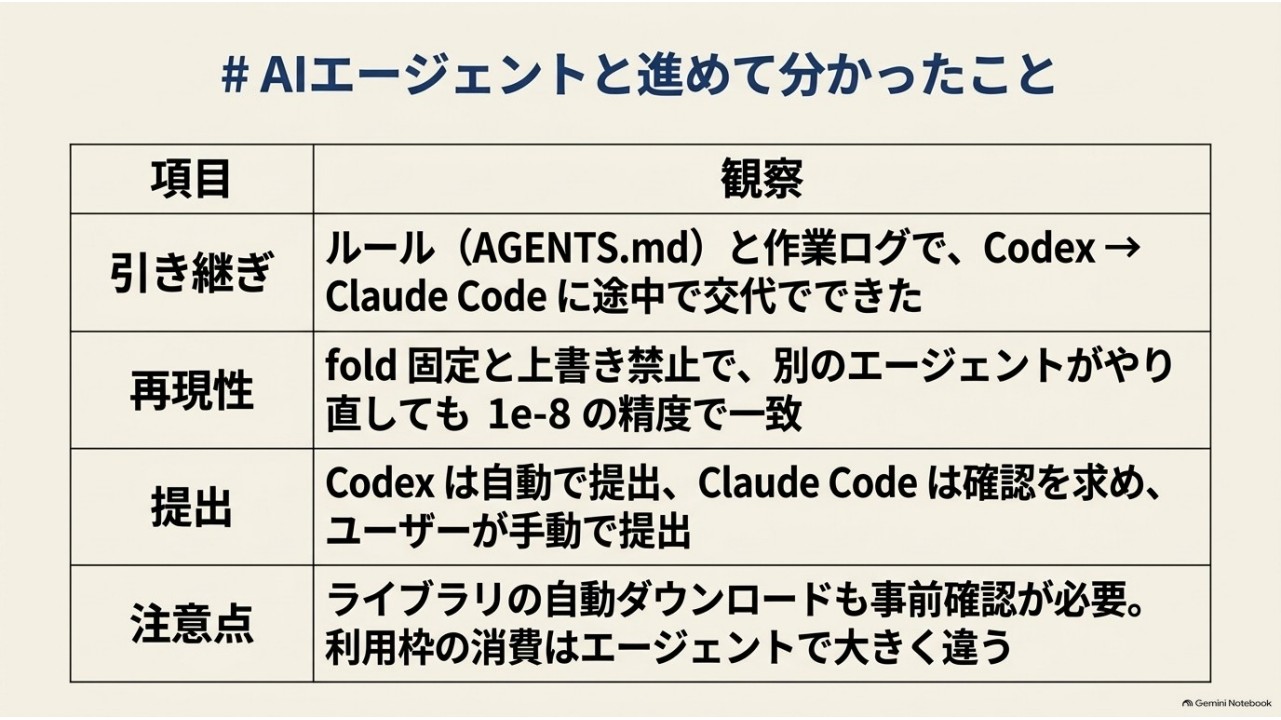
第1ラウンドと第2ラウンドの環境構築はCodex、以降の実装・EDA・レポート統合はClaude Codeが担当しました。固定fold、実験ごとのファイル保存、上書き禁止、作業ログがあったため、同じ条件で続きを実行できました。
提出方法も変わりました。第1ラウンドはCodexがKaggle APIで提出。第2ラウンド以降はClaude Codeが提出コマンドを用意し、候補を確認したうえで私がPowerShellから手動で実行しました。これは引き継ぎ時に「Claude Codeは提出しない」と決めた運用に沿っています。提出や認証情報の扱いをどこまで任せるか、事前に明文化する重要性も感じました。
まとめ
最終スコアはPrivate 0.89042。効いたのは、多クラスとして扱う定式化、元データを学習foldだけに足す検証設計、そしてGBDTと表形式基盤モデルの異なる予測を混ぜることでした。EDAの追加案は提出基準を超えませんでしたが、難しい欠陥の構造と改善の限界を理解する助けになりました。
OOFは完全に独立した評価ではありません。モデル選択や一部の調整に同じfoldを使っています。全データ再学習の差も1回の比較だけです。次に試すなら、TabPFNのファインチューニングをまず1foldで時間とVRAMを測って判断したいと思います。
資料:完成版スライド全32ページ(PDF)。スライドはClaude Codeが初稿を作り、Gemini Notebookでデザインを整えた後、Claude Codeと手作業で修正しました。
コンペ:Kaggle Steel Plate Defect Prediction。
再現用ファイル(Pythonコード・最高スコアの提出CSV)
再現用ZIPをダウンロード(約6 MB)。最高スコアの提出CSV blend_v2_nelder_mead_full.csv、元のPythonソース・設定、10モデルの保存済み予測、実行手順をまとめました。ZIPを展開して python reproduce_submission.py を実行すると、保存済み予測から提出CSVを再生成し、SHA-256で一致を確認できます。
学習からやり直す場合は、Kaggleの学習・テストデータとUCI元データを公式配布元から別途取得してください。GPU学習の非決定性があるため、最初から学習した結果のバイト単位一致は保証されません。PrivateスコアはKaggleの非公開ラベルによる評価です。